

Python矩阵输入时怎么将字符串转换为数字类型
详细讲解在Python中进行矩阵输入时,如何将输入的字符串准确高效地转换为数字类型(整数或浮点数),包含列表推导式、map函数、sys.stdin流式处理与NumPy转换方案,附带异常处理与完整SVG流程图解。
input() 或 sys.stdin 获取的标准输入始终是以文本字符串的形式呈现的。将输入矩阵转化为数值类型的标准解决路径分为三步:按行捕获文本、调用 split() 方法切分为字符子串列表,再借助 map() 函数或列表推导式逐个转换为 int 或 float 类型,最终组合为二维嵌套列表或 NumPy 数组结构。
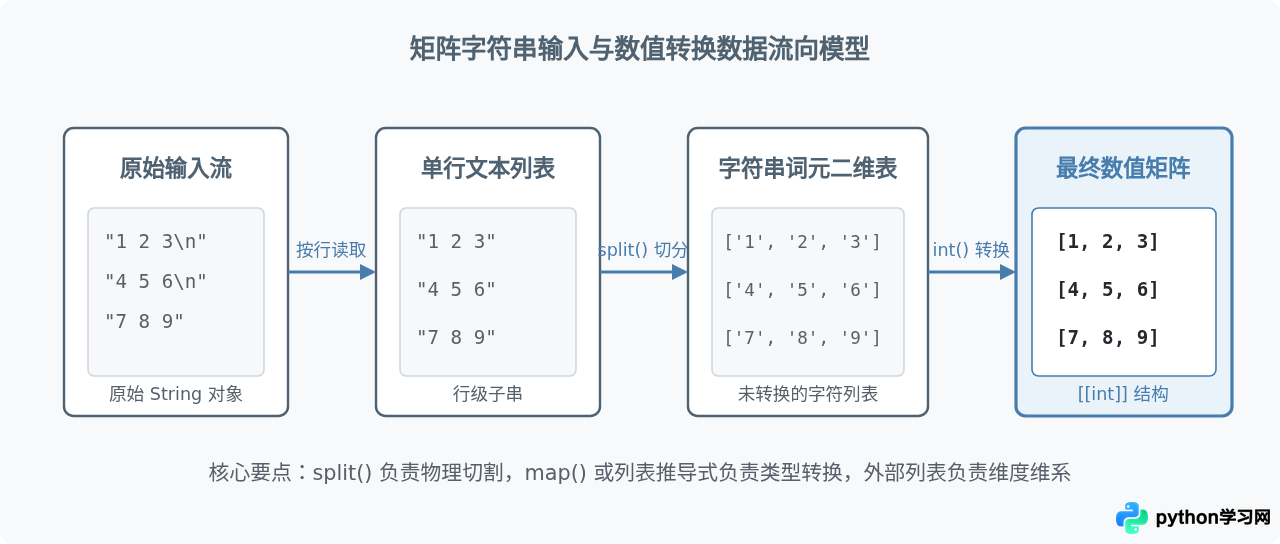
一、矩阵字符串转换的数据流向与核心原理
在终端输入矩阵时,用户键入的内容通常以换行符分隔行、以空格或逗号分隔列。Python 解释器接收到的初始对象是纯文本字符串。计算机无法直接对纯文本进行矩阵加减、转置或求逆运算,必须先将其映射为连续的数值结构。
整个转换过程遵循严格的由粗到细的流水线模型:从原始多行文本到按行切割的单行文本,再到切分出的离散字符串单元,最后经过类型强制构造出数值型二维矩阵。
二、常规矩阵输入的转换操作步骤
在大多数算法题、控制台工具或自动化脚本中,输入的矩阵通常具有明确的行数和列数。以下是标准化、规范化的操作步骤。
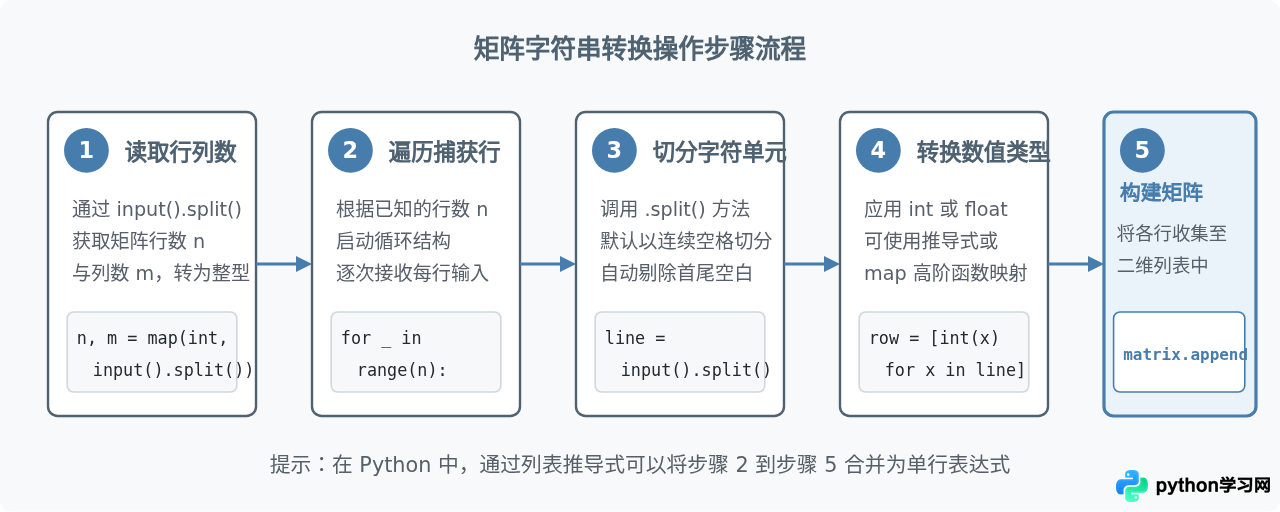
1. 方式一:使用列表推导式(推荐,可读性高)
列表推导式是 Python 编写代码时最符合语言惯例(Pythonic)的方式。它的结构清晰直观,容易添加数据筛选或清洗逻辑。
# 假设首先输入矩阵的行数 n
n = int(input("请输入矩阵行数: "))

# 通过嵌套列表推导式,直接读取并转换每行
matrix = [[int(val) for val in input().split()] for _ in range(n)]

print("转换后的整型矩阵:", matrix)
代码原理解释:
input().split():接收用户在该行输入的完整字符串。默认无参数调用split()时,会自动按任意连续空白字符(空格、Tab键)进行切分,并将行末换行符剔除,返回字符串列表。例如" 10 20 30 \n"会被切分为['10', '20', '30']。[int(val) for val in ...]:内层推导式遍历切分出的每个字符单元,显式调用int(val)构造整数,生成代表当前行的整型列表。- 外层
[... for _ in range(n)]:重复执行n次行输入,并将生成的各行打包为一个外层列表,最终构成二维列表。
2. 方式二:使用 map() 函数转换(执行高效)
map() 是 Python 的内置高阶函数,它将转换函数直接应用于迭代器中的每个元素。在处理纯数值转换且不需要复杂的中间逻辑时,map() 的执行速度通常略快于纯 Python 语法级别的推导式。
n = int(input("请输入行数: "))

# 使用 map(int, ...) 配合 list 构造器
matrix = [list(map(int, input().split())) for _ in range(n)]

print("结果矩阵:", matrix)
需要特别注意的是,在 Python 3 中,map() 返回的是一个惰性求值的迭代器对象。如果不使用 list() 对其进行强制求值和包装,后续无法直接通过索引访问元素(如 matrix[0][1]),因此必须显式用 list(map(...)) 进行封包。
3. 浮点数矩阵与特定分隔符处理
如果矩阵中包含小数,或者输入来源是 CSV 格式(以逗号作为分隔符),只需调整转换函数与 split() 的参数即可:
n = int(input("请输入行数: "))

# 处理逗号分隔的浮点数矩阵,例如输入 "1.2, 3.4, 5.6"
matrix = [list(map(float, input().split(','))) for _ in range(n)]

print("浮点型矩阵:", matrix)
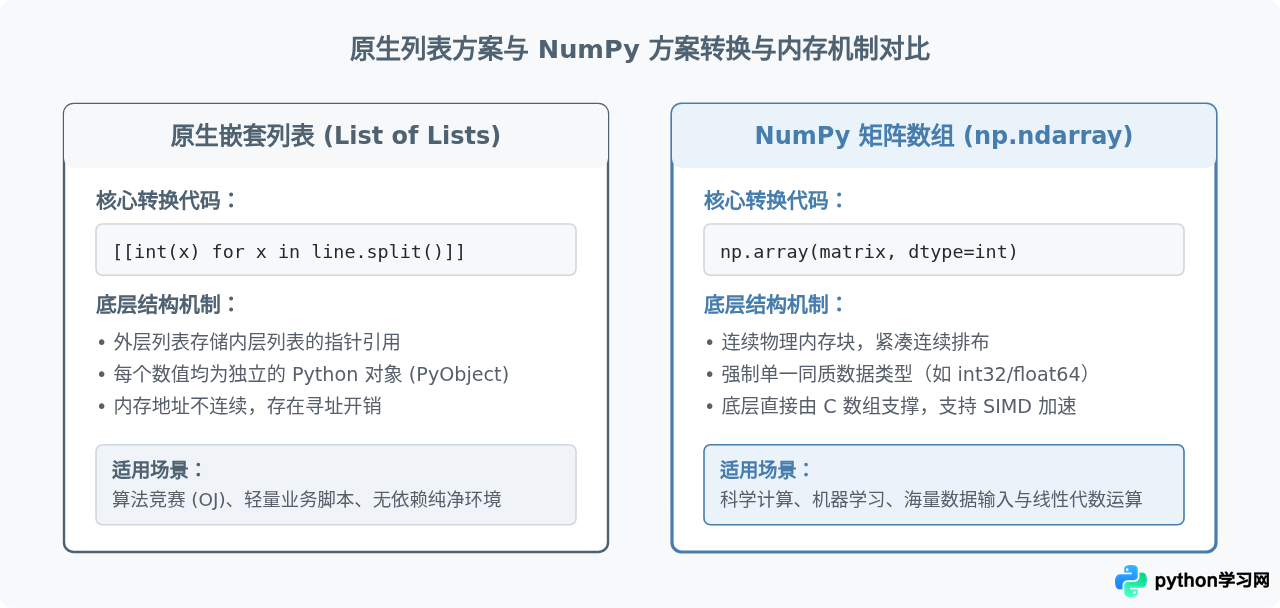
三、原生嵌套列表与 NumPy 数组方案对比
在 Python 中表示矩阵通常有两种形式:Python 原生内置的嵌套列表(List of Lists)以及科学计算库 NumPy 提供的 ndarray 对象。两者在底层内存管理、类型统一性与转换性能上存在明显差异。
NumPy 的快捷批量转换
如果已经引入了 NumPy 库,除了先构造列表再调用 np.array() 之外,还可以直接利用其专有 I/O 工具直接从字符串流中反序列化出数值矩阵:
import numpy as np
import io

# 模拟接收到的多行矩阵字符串
raw_data = """1.5 2.0 3.5
4.1 5.2 6.3
7.8 8.9 9.0"""

# 方法 A:通过 StringIO 将字符串包装后直接读取
matrix_np = np.loadtxt(io.StringIO(raw_data), dtype=float)

print("NumPy 矩阵类型:", type(matrix_np))
print("数据内容:\n", matrix_np)
np.loadtxt() 能够一次性完成文本行切分、列对齐与类型解析,对于大规模矩阵输入具备极高的数据吞吐效率。
四、异常情况与常见错误排查
在实际处理控制台输入或文件重定向时,输入数据往往不完全规范,常伴随空行、误触的回车符或非数字字符。如果在转换前未做防御性校验,程序会直接抛出运行时异常。
| 常见报错 | 诱发根源 | 针对性解决策略 |
|---|---|---|
ValueError: invalid literal for int() with base 10: '' |
输入的行中包含连续空格且使用了指定参数切分(如 split(' ')),导致切出空字符串 '' 并试图转为整数。 |
切勿给 split() 传空格参数,保持默认 split(),它会自动压缩所有连续空格并丢弃空子串。 |
ValueError: could not convert string to float: 'N/A' |
矩阵数据中混入了缺失值标记、表头文字或非法字符。 | 在转换步骤前添加数据校验函数,或使用 try...except 进行兜底过滤。 |
IndexError: list index out of range |
在已知行数 n 的循环中,用户过早输入了空行或到达 EOF(文件末尾)。 |
改用流式读取 sys.stdin.read().strip().splitlines(),根据实际读到的有效行数动态处理。 |
许多初学者习惯写 line.split(' ')。这会带来严重隐患:当输入中出现两个相邻空格 "1 2" 时,split(' ') 会返回 ['1', '', '2']。空字符串 '' 传递给 int() 或 float() 时必然报错。而无参的 line.split() 会把任意长度的连续空白视作一个分隔符,完全避免该问题。
流式输入的健壮处理示例
对于算法评测系统(如 ACM 模式)中行数未知、直接以文件末尾(EOF)结束的多组测试用例,推荐采用 sys.stdin 读取全部内容后再统一解析:
import sys

def parse_input_matrix():
    # 读取全部输入内容并去除首尾空白
    raw_content = sys.stdin.read().strip()
    if not raw_content:
        return []

    matrix = []
    for line in raw_content.splitlines():
        # 过滤可能存在的空行
        clean_line = line.strip()
        if not clean_line:
            continue
        # 转换为整数列表
        row = [int(item) for item in clean_line.split()]
        matrix.append(row)

    return matrix
五、方法决策与总结全景
在进行 Python 矩阵输入的字符串到数值转换时,开发者应根据“输入规模”、“运行依赖”以及“后续运算需求”三个维度选择最适配的技术路径。
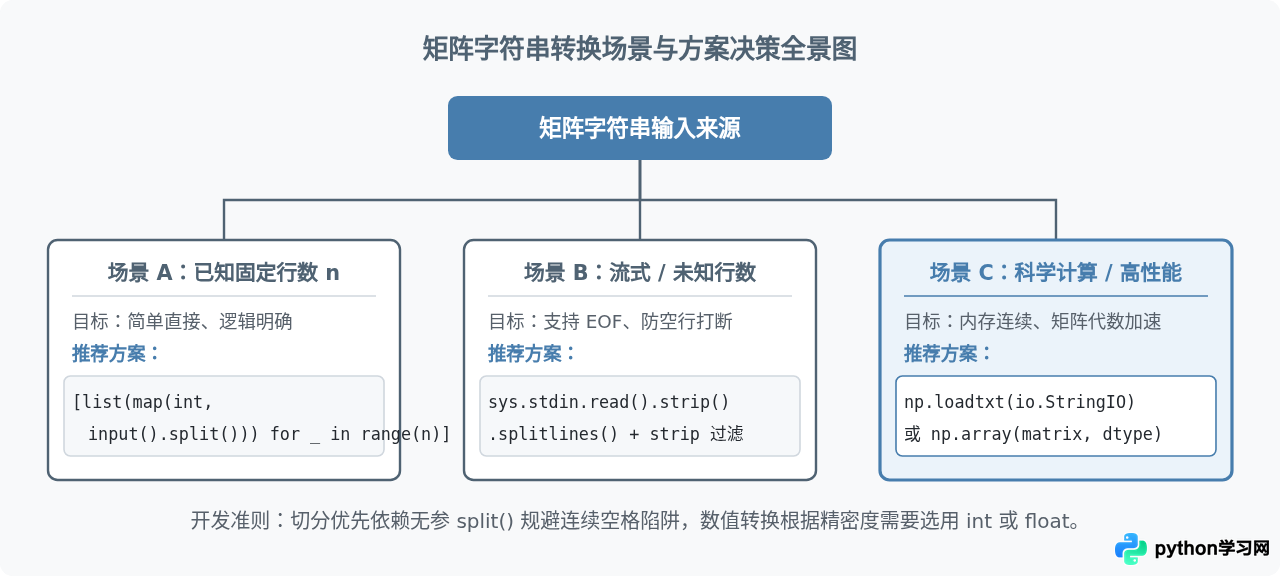
综上所述,将输入的矩阵字符串准确转换为数字类型,其核心在于把握“字符串切分粒度”与“映射转换函数”的搭配。日常开发与解题中,首选嵌套列表推导式或 map(int, input().split()) 组合;在面对未知行数与多余空白时,辅以 strip() 和流式读取;而在涉及高维矩阵运算时,及时借助 NumPy 进行类型固化,即可保证代码的高效与稳健。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









