

Python结合BeautifulSoup批量下载网页所有图片
详细讲解使用 Python 结合 BeautifulSoup 库批量抓取和下载网页图片的完整方案,包含网页抓取、图片标签定位、URL规范化补全、流式落地存储及常见异常处理。
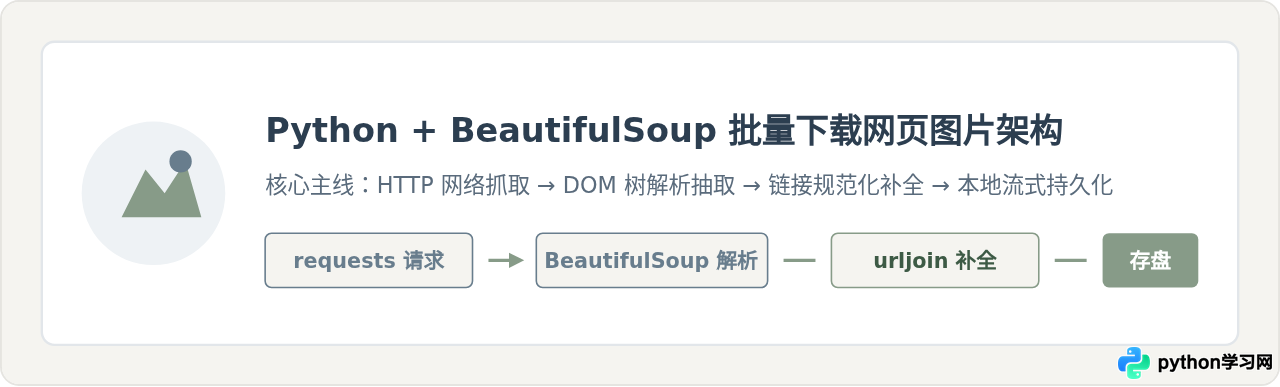
在 Python 中批量下载网页中的所有图片,标准做法是由 requests 库负责发起网络请求以拉取网页 HTML 原文,交由 BeautifulSoup 构建 DOM 语法树并检索全部 <img> 标签;随后通过标准库 urllib.parse.urljoin 统一将相对路径修复为可直接访问的完整绝对 URL,最后借助流式写入模式(Stream Write)按块将二进制图像数据持久化保存到本地硬盘。本文将以清晰的模块化拆解,完整演示这一处理流水线与高稳定性落地方案。
一、准备工作与运行依赖
在编写抓取脚本前,需要准备好网络请求库与 HTML 解析库。通常推荐使用 requests 处理 HTTP 协议层交互,使用 beautifulsoup4 配合底层解析引擎 lxml 进行文档解析。
打开终端并执行以下安装命令:
pip install requests beautifulsoup4 lxml安装完成后,核心模块的分工如下:
- requests:负责与目标服务器建立 TCP 连接并发送 HTTP GET 请求,获取目标网页的 HTML 字符串以及图片的原始二进制字节流。
- BeautifulSoup:负责将无规则的 HTML 源码转换成结构化的树状文档对象,提供面向标签名称、属性过滤的高效查找接口。
- urllib.parse:Python 内置标准库,其提供的
urljoin函数能够正确依据当前网页的 Base URL 拼接规范的图片绝对链接。
二、核心执行流水线设计
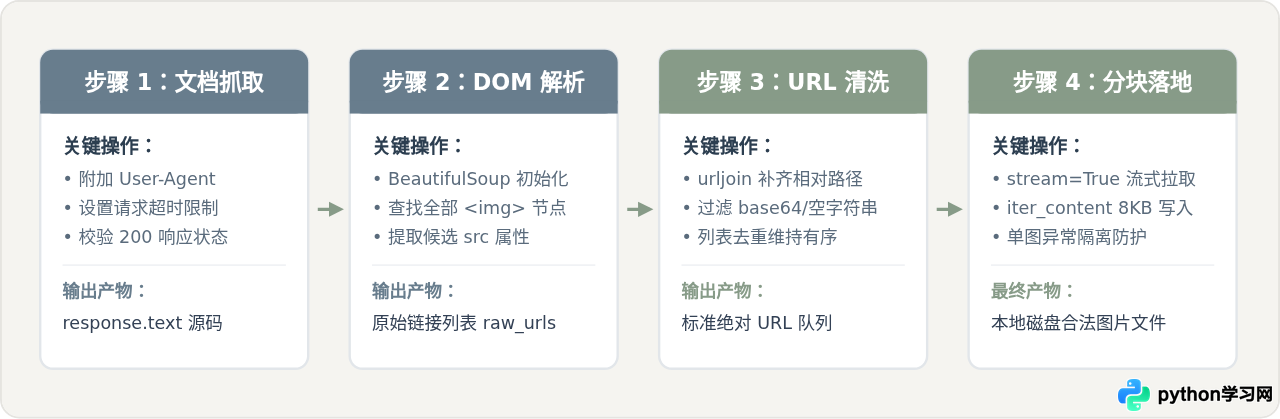
完整的下载作业不是单一步骤,而是由四个强关联的阶段构成的处理流水线(Pipeline)。只有各环节遵循严格的契约,程序在面对各类型网站时才具备足够鲁棒性。
三、步骤详解:从页面请求到解析
1. 获取目标网页源码
直接通过默认参数请求现代网页很容易遭到拦截。在构造请求时,至少应声明一个合法的客户端标头(User-Agent),同时必须显式设定连接超时时间(timeout),防止网络阻塞导致主线程无限挂起:
import requests

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

target_url = "https://example.com/gallery"
response = requests.get(target_url, headers=headers, timeout=(5, 15))
response.raise_for_status()  # 若状态码非 200 会抛出 HTTPError 异常
html_content = response.text
2. 用 BeautifulSoup 提取图片节点
拿到 HTML 内容后,将其交给 BeautifulSoup 初始化。通过 soup.find_all("img") 可以一次性抓取页面中所有的图片元素。需要特别注意的是,很多现代网站为了加速渲染引入了图片懒加载(Lazy Load),真实链接可能存放在自定义数据属性中:
from bs4 import BeautifulSoup

soup = BeautifulSoup(html_content, "lxml")
img_tags = soup.find_all("img")

raw_urls = []
for img in img_tags:
    # 优先检测常见的懒加载属性,若无再回退至原生 src
    src = (
        img.get("data-original") or
        img.get("data-src") or
        img.get("data-url") or
        img.get("src")
    )
    if src:
        raw_urls.append(src.strip())
四、图片 URL 规范化与补全机制
在 HTML 文档中,图片路径通常有四种存在形式:完整绝对路径、双斜线协议相对路径、以单斜线开头的根相对路径,以及点号开头的同级/父级相对路径。直接请求相对路径会导致 HTTP 请求报错,必须转换为完整的网络地址。
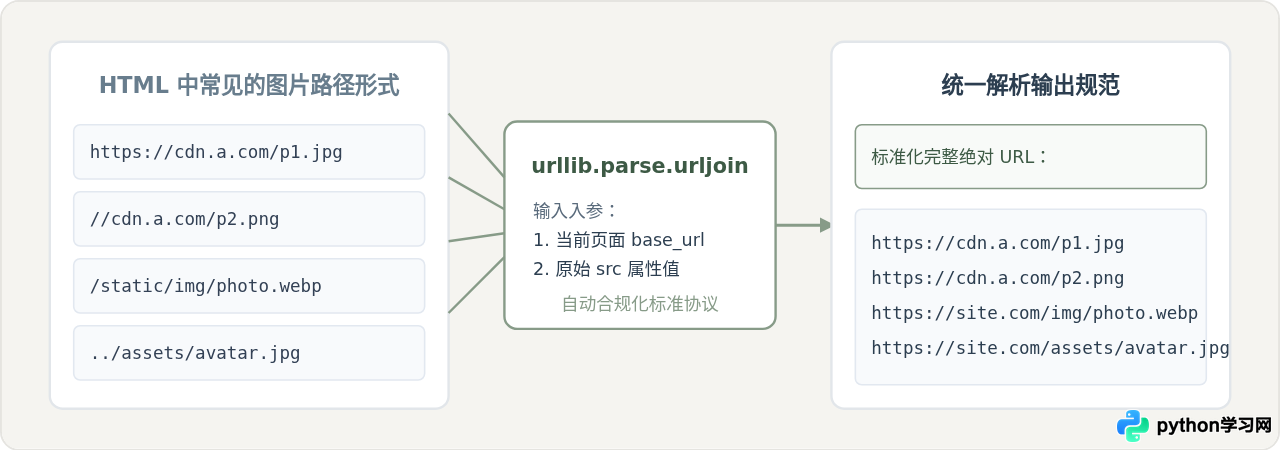
标准库函数 urljoin(base_url, url) 会智能识别以下分支逻辑:
- 若原始链接已带
http://或https://,直接原样返回。 - 若原始链接以
//开头,则继承当前页面的协议(如从https://...补齐为完整的 HTTPS 链接)。 - 若原始链接以
/开头,则基于当前页面的域名根目录完成拼接。 - 若原始链接为相对目录路径(如
./img/1.jpg),则基于当前页面的具体目录层级进行相对解析。
五、写入方式对比:一次性加载 vs 流式分块落盘
在拿到有效图片 URL 后,需要向图片资源地址发起请求并保存为本地文件。在实现下载逻辑时,主要有两种编程范式:直接读取 response.content 写入 与 启用 stream=True 流式分块写入。理解两者在一致请求条件下的机制差异,对于保证脚本稳定性至关重要。
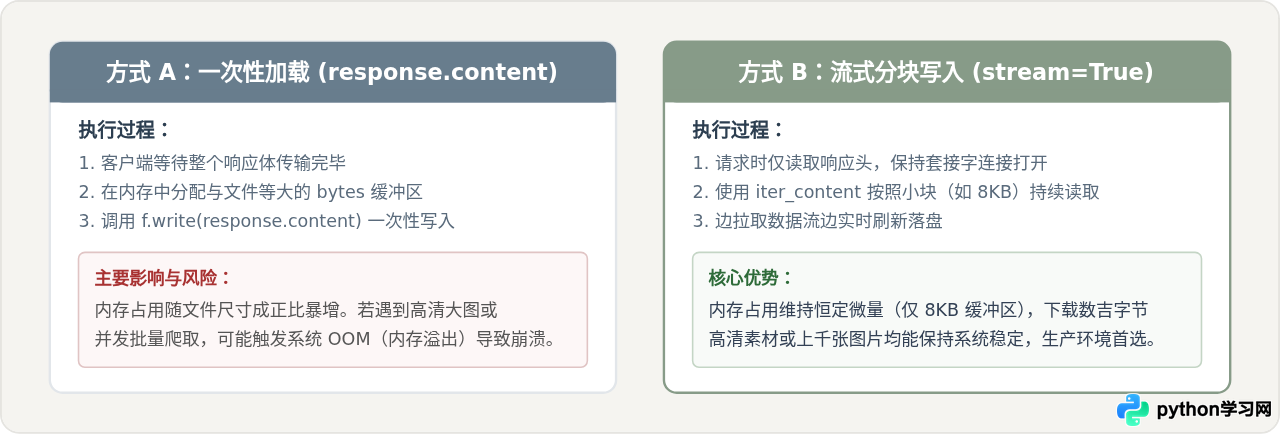
| 对比维度 | 一次性写入 (response.content) | 流式分块写入 (stream=True + iter_content) |
|---|---|---|
| 代码复杂度 | 极简(仅需 2 行代码即可落盘) | 需使用 with 上下文管理器及循环分块迭代 |
| 内存开销 | 高,与单张图片体积呈 1:1 线性正相关 | 恒定维持在设定块大小(如 8KB),不受文件体量影响 |
| 弱网耐受度 | 较差,整包接收完毕前无任何持久化数据 | 良好,可结合进度回调追踪传输,连接异常时及时释放 |
| 推荐适用场景 | 页面小图标、验证码、单张几十 KB 以内的缩略图 | 批量下载、全尺寸相册原图、未明规格的通用爬虫 |
六、完整整合代码实现
结合前述的各个模块,下面提供一份结构严谨、支持防爬头定制、自动创建存储文件夹、防御重名覆盖及单图异常隔离的完整可执行代码:
import os
import re
import requests
from urllib.parse import urljoin, urlparse
from bs4 import BeautifulSoup

def download_images_from_page(page_url, save_dir="downloaded_images"):
    """
    批量提取指定网页中的所有图片并流式保存到本地目录
    :param page_url: 目标网页 URL
    :param save_dir: 本地存储文件夹名称
    """
    # 1. 准备本地目录
    os.makedirs(save_dir, exist_ok=True)

    # 2. 构造通用客户端请求头
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/124.0.0.0 Safari/537.36"
        )
    }

    print(f"正在拉取网页内容: {page_url}")
    try:
        response = requests.get(page_url, headers=headers, timeout=(5, 15))
        response.raise_for_status()
    except requests.RequestException as e:
        print(f"抓取页面失败: {e}")
        return

    # 3. 解析 DOM 树并提取所有图片链接
    soup = BeautifulSoup(response.text, "lxml")
    img_tags = soup.find_all("img")
    print(f"共发现 {len(img_tags)} 个 <img> 标签")

    # 4. 抽取、去重并补全绝对地址
    image_urls = []
    seen = set()
    for img in img_tags:
        src = (
            img.get("data-original") or
            img.get("data-src") or
            img.get("data-url") or
            img.get("src")
        )
        if not src:
            continue

        src = src.strip()
        # 跳过内联 Base64 编码图片
        if src.startswith("data:image"):
            continue

        full_url = urljoin(page_url, src)
        if full_url not in seen:
            seen.add(full_url)
            image_urls.append(full_url)

    print(f"完成去重与规整,待下载有效图片数量: {len(image_urls)}")

    # 5. 循环执行流式下载
    success_count = 0
    for idx, img_url in enumerate(image_urls, start=1):
        # 提取文件名与扩展名
        parsed_path = urlparse(img_url).path
        filename = os.path.basename(parsed_path)

        # 清除文件名中的非法字符
        filename = re.sub(r'[\/:*?"<>|]', '_', filename)

        # 处理无文件名或无后缀的特殊情况
        ext = os.path.splitext(filename)[1].lower()
        if not filename or ext not in [".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg"]:
            filename = f"image_{idx:03d}.jpg"
        else:
            filename = f"{idx:03d}_{filename}"

        file_path = os.path.join(save_dir, filename)

        try:
            # 采用 stream=True 流式拉取
            with requests.get(img_url, headers=headers, stream=True, timeout=(5, 20)) as img_resp:
                if img_resp.status_code == 200:
                    with open(file_path, "wb") as f:
                        for chunk in img_resp.iter_content(chunk_size=8192):
                            if chunk:
                                f.write(chunk)
                    success_count += 1
                    print(f"[{idx}/{len(image_urls)}] 下载成功: {filename}")
                else:
                    print(f"[{idx}/{len(image_urls)}] 请求返回状态码: {img_resp.status_code},跳过")
        except requests.RequestException as err:
            print(f"[{idx}/{len(image_urls)}] 下载失败 ({img_url}): {err}")

    print(f"
全部任务处理完毕!成功下载: {success_count}/{len(image_urls)} 张图片,存储于: {save_dir}/")

if __name__ == "__main__":
    # 示例执行入口(请替换为需要测试的具体合法网址)
    test_target = "https://httpbin.org/html"
    download_images_from_page(test_target, save_dir="output_images")
七、关键注意事项与避坑指南
在实际应用中,网络环境和网站前端实现具有高度多样性。以下总结了爬取图片时最常遇到的四类边界情况及对应的解决方案:
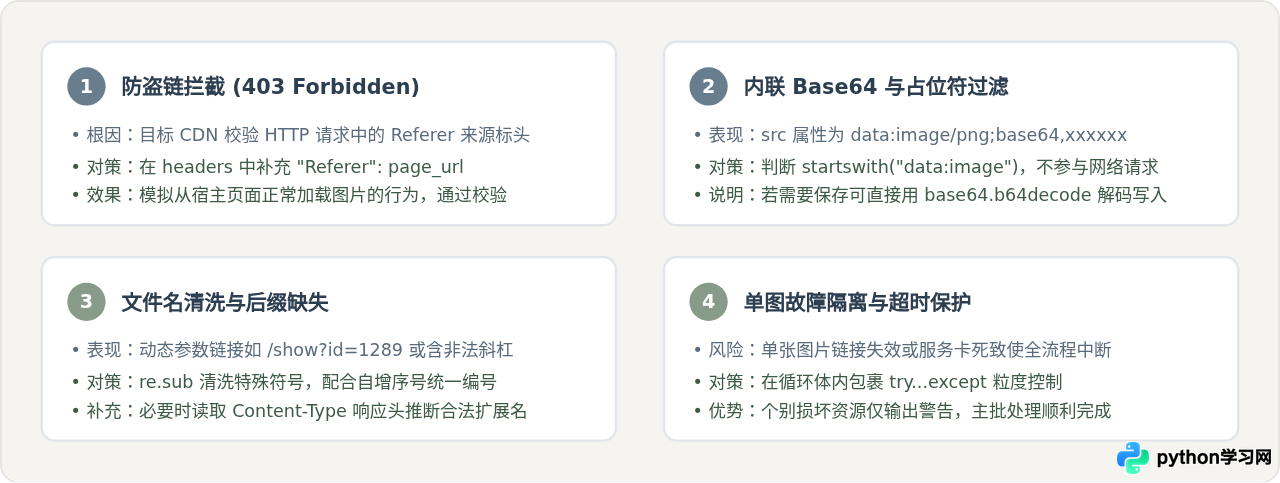
requests 建立稳定的连接管道,利用 BeautifulSoup 精确挖掘并清洗文档节点,再配合 urljoin 统一路径规范与流式分块写入,便构成了 Python 批量下载网页图片的标准解法。遵循这一分层设计,能够在确保低内存占用的同时,从容应对绝大部分静态与常规服务端的图像提取需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









