

Python基础文件读写操作代码模板(open与with语句)
系统介绍Python中文件读写的标准代码模板,涵盖open()函数与with语句的使用、文本与二进制模式区别、常用读写方法对比及常见异常处理。
with open(...) as f: 语法结构。它依托上下文管理器协议,确保文件在读写完成或发生异常中断时自动关闭并安全释放系统句柄。本文直接提供文本读写、追加写入与二进制处理的标准代码模板,梳理 open() 与 with 语句的机制差异,并解析常用模式与方法选型。
一、标准文件读写操作代码模板
Python 处理文件的常规生命周期包括三步:指定路径与模式打开文件、执行数据流读写、关闭文件。为了避免遗漏关闭操作,日常开发中统一推荐采用 with 语句。
1. 读取文本文件(常用模板)
读取文本文件时,务必显式声明 encoding="utf-8",以防止在不同操作系统(如 Windows 默认的 GBK)下解析出现中文乱码。
# 模板 1:一次性读取全部内容(适合体积较小的文件)
file_path = "example.txt"

with open(file_path, mode="r", encoding="utf-8") as f:
    content = f.read()
    print("读取到的内容:")
    print(content)

# 模板 2:逐行迭代读取(内存友好,适合中大型文件)
with open(file_path, mode="r", encoding="utf-8") as f:
    for line_number, line in enumerate(f, start=1):
        # line 末尾自带换行符 \n,可使用 strip() 或 rstrip("\n") 剔除
        clean_line = line.rstrip("\n")
        print(f"第 {line_number} 行: {clean_line}")
2. 写入文本文件(覆盖写模板)
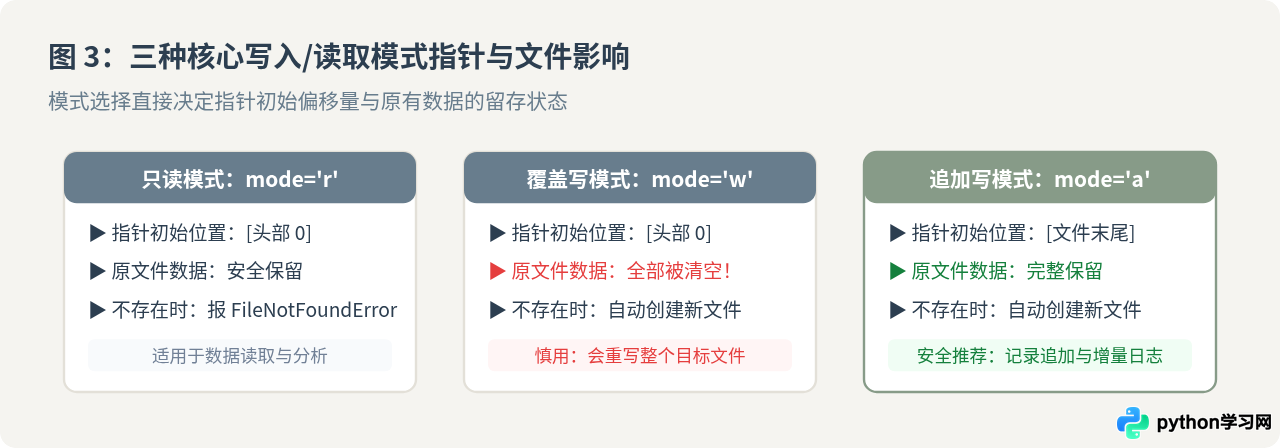
使用模式 "w" 打开文件。如果目标文件不存在,系统会自动创建;若文件已存在,其原有内容将被完全清空。
# 模板 3:覆盖写入单段或多行文本
output_path = "output.txt"
lines_to_write = ["第一行数据\n", "第二行数据\n", "第三行总结\n"]

with open(output_path, mode="w", encoding="utf-8") as f:
    # 单独写入字符串
    f.write("=== 记录开始 ===\n")
    # 批量写入列表中的所有行
    f.writelines(lines_to_write)
3. 追加写入文本文件(保留原内容模板)
使用模式 "a" 打开文件。文件指针会直接定位到文件末尾,写入的新数据紧跟在末尾,不会破坏原有内容。
# 模板 4:向文件末尾追加日志或新记录
log_path = "app.log"

with open(log_path, mode="a", encoding="utf-8") as f:
    f.write("2026-10-29 10:00:00 [INFO] 任务执行完毕\n")
4. 二进制文件读写(图片、音视频或序列化数据)
处理非纯文本时,需在模式中加入 b(如 "rb" 或 "wb"),此时不能传入 encoding 参数,读写单位为原始字节 bytes。
# 模板 5:二进制文件复制(如复制图片)
src_path = "photo.jpg"
dst_path = "photo_backup.jpg"

with open(src_path, mode="rb") as src_file:
    data = src_file.read()

with open(dst_path, mode="wb") as dst_file:
    dst_file.write(data)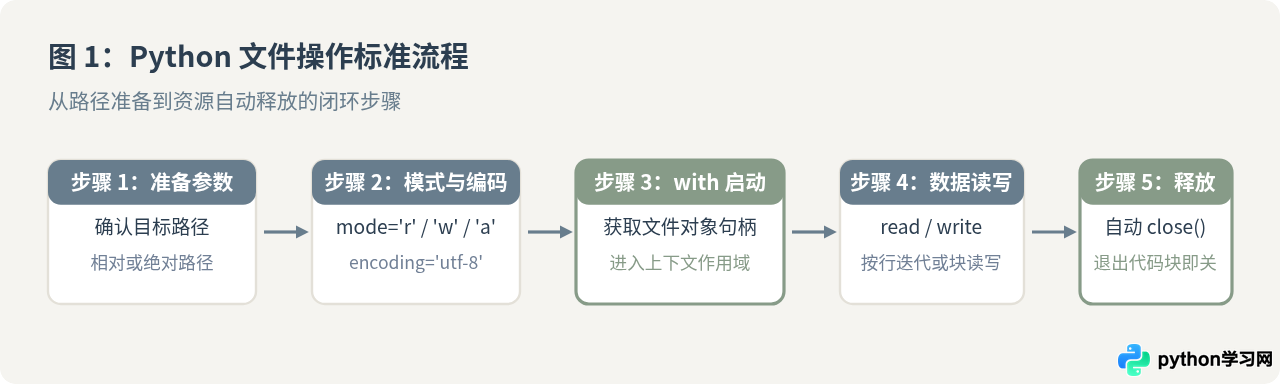
二、open() 手动管理与 with 语句的关键机制对比
初学者常会接触到最原始的写法:直接调用 f = open(...) 并在末尾写上 f.close()。然而在实际工程中,这种方式极具安全隐患。
1. 传统 open() 与 close() 的缺陷
# 传统方式(存在隐患)
f = open("data.txt", "r", encoding="utf-8")
try:
    content = f.read()
    # 假设此处代码发生数据解析异常(ValueError / ZeroDivisionError 等)
    result = 10 / 0
finally:
    # 必须配合 try...finally 才能确保关闭,代码繁琐且易漏写
    f.close()
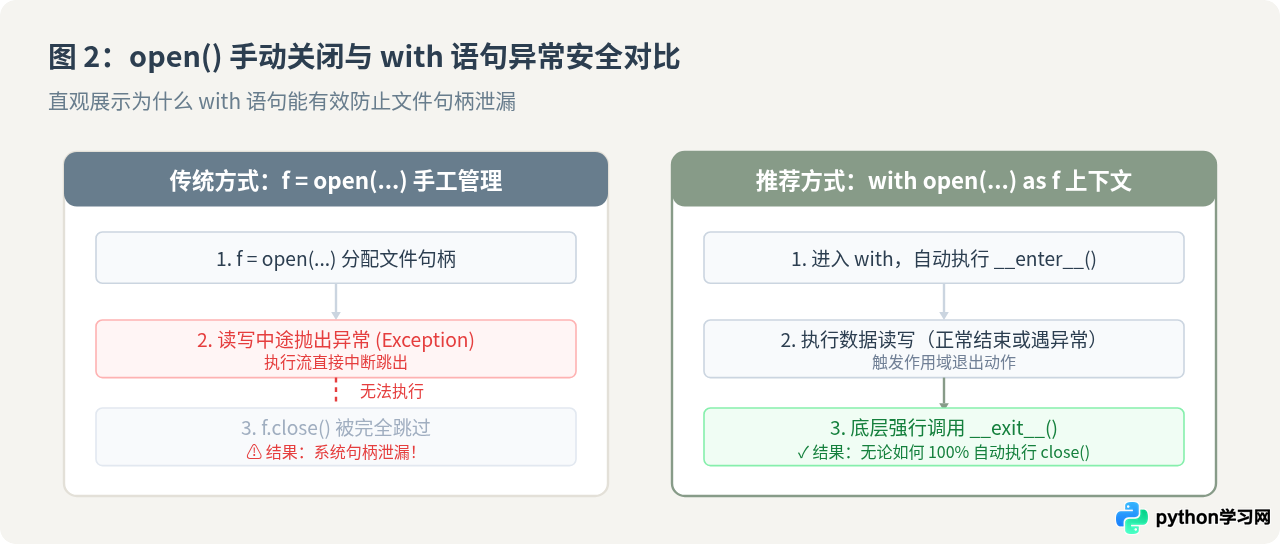
如果在读写过程中发生异常,程序执行流会立即跳出当前逻辑。若未使用 try...finally 严密包裹,后面的 f.close() 将永远不会被执行。操作系统分配给当前进程的文件描述符就会持续被占用,直到进程退出;在多进程、循环处理或高并发场景下,极易引发“Too many open files”(打开文件数超限)致命错误。
2. with 语句的上下文管理协议
with 语句利用了 Python 的上下文管理器(Context Manager)协议。open() 返回的文件对象内部实现了 __enter__() 和 __exit__() 方法:
- 进入上下文:执行
with open(...) as f:时,首先触发__enter__(),将打开的文件对象赋值给变量f。 - 退出上下文:不论代码块是正常执行完毕、遇到
return提前退出,还是中途遭遇异常报错中断,解释器都会无条件调用__exit__()方法,由其负责安全调用底层的close(),保证句柄被彻底释放。
三、文件打开模式(mode)与编码行为解析
open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None) 函数提供了丰富的控制参数,其中 mode 决定了读写权限与指针初始位置。
| 模式字符 | 读写权限 | 文件不存在时 | 初始指针位置 | 是否清空原内容 |
|---|---|---|---|---|
"r" |
只读(默认) | 抛出 FileNotFoundError | 文件头部(0) | 否 |
"w" |
只写 | 自动创建新文件 | 文件头部(0) | 是(立即清空原内容) |
"a" |
追加写 | 自动创建新文件 | 文件末尾 | 否(在末尾续写) |
"x" |
独占写入 | 正常创建写入 | 文件头部(0) | 若文件已存在则报错 FileExistsError |
"r+" |
读写 | 抛出 FileNotFoundError | 文件头部(0) | 否(原地覆写对应字节) |
"b" |
二进制模式 | 与对应读写模式一致 | 视搭配的主模式而定 | 处理原始字节流,禁用 encoding |
四、常用读写方法选型与内存优化
拿到文件句柄后,如何调用方法对程序性能有显著影响。针对不同文件体量,应选用匹配的 API。
1. 读取方法选型对比
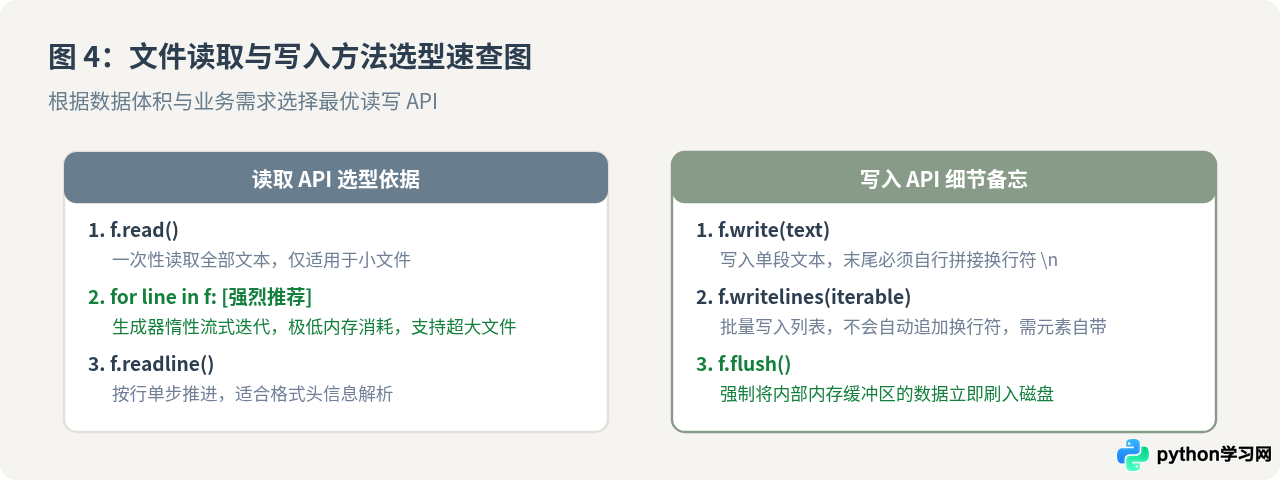
f.read(size=-1):读取全部内容并作为一个字符串返回。适合配置文件、小型模版等内容在几十兆以内的场景;若文件达数吉字节(GB),会导致内存瞬间被占满。f.readline():每次仅读取一行,返回带\n的字符串。读到末尾返回空字符串""。f.readlines():一次性读取全部行并存为列表list返回。本质上仍是将整个文件全部加载到内存中。- 推荐最佳实践(逐行迭代):直接对文件对象进行迭代
for line in f:。Python 解释器在底层使用缓冲生成器按需加载下一行,既兼顾了按行处理的便捷,又使得内存占用维持在极低水准(仅当前行大小)。
2. 写入方法选型与换行细节
f.write(string):将指定字符串写入文件,返回写入的字符数(文本模式)或字节数(二进制模式)。注意:write()不会自动在末尾附加换行符,多行文本必须显式传入\n。f.writelines(sequence):接收由字符串组成的可迭代对象(如列表),依次写出。常见误区:尽管名字带lines,但它不会自动为各元素补齐换行符,传入的每个元素末尾仍需自带\n。
五、生产环境异常处理与排坑总结
在实际项目中,单纯使用 with 能够确保资源按时释放,但外部环境(如路径不存在、权限不足等)仍需进行防护性异常捕获:
import os
from pathlib import Path

# 生产级安全读取模板
file_path = Path("configs/settings.json")

try:
    with open(file_path, mode="r", encoding="utf-8") as f:
        data = f.read()
except FileNotFoundError:
    print(f"错误:指定文件不存在 -> {file_path}")
except PermissionError:
    print(f"错误:没有权限读取该文件 -> {file_path}")
except UnicodeDecodeError as e:
    print(f"编码解析错误:文件非 utf-8 格式,请核对编码配置 -> {e}")
except Exception as e:
print(f"读取文件时遭遇未知异常 -> {e}")- 优先使用
with open(...) as f:,杜绝裸调f = open(...)。 - 文本模式下永远显式写明
encoding="utf-8"。 - 读取大文件严禁使用
f.read()或f.readlines(),统一采用for line in f:迭代。 - 写模式
"w"会立即擦除原有数据,若要保留请改用"a"模式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









