

零基础学Python做什么项目进步最快?适合新手的实战清单
零基础学习Python究竟做什么项目进步最快?本文梳理了一份由浅入深、强反馈的实战清单,涵盖文件批处理、数据抓取、命令行工具与轻量Web应用,帮助初学者跨越语法遗忘与无从下手的困境。
零基础学习Python想要快速建立编程思维与解决问题的能力,关键不在于做多大、多复杂的系统,而在于选择能够“即时反馈、流程闭环、直观可验证”的微型实战项目。本文梳理了初学者进步最快的四个梯队项目清单,带你由浅入深掌握核心语法、模块调用与逻辑组织能力。
一、为什么有些项目进步飞快,而有些让人半途而废?
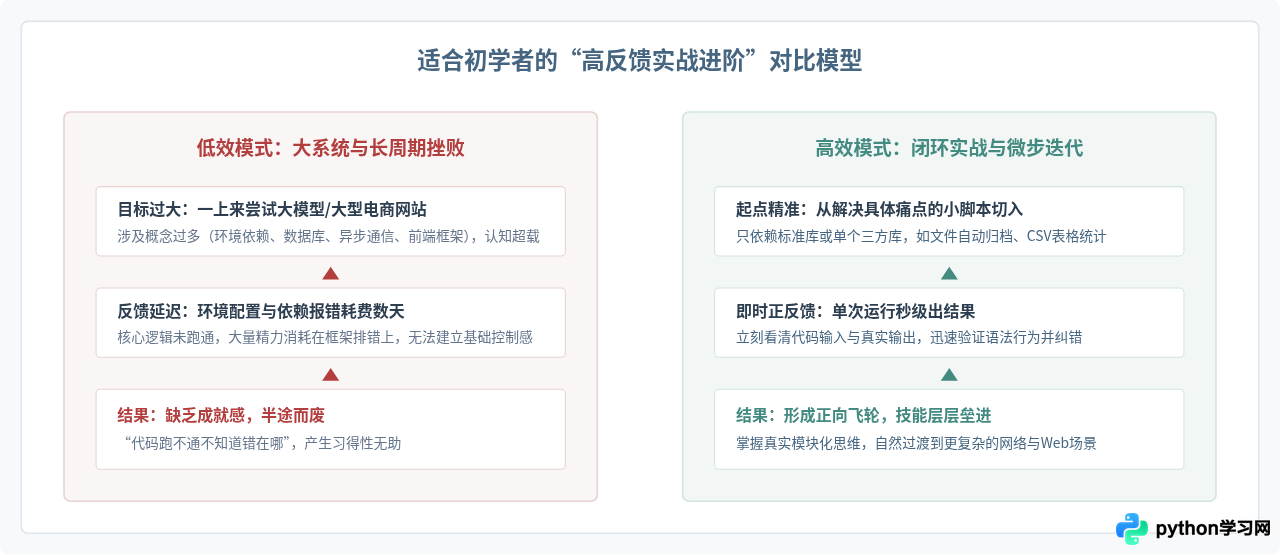
很多初学者在刚学完变量、列表和循环后,常常陷入两种极端:要么盲目跟风选择“人脸识别”、“深度学习大模型”或“分布式爬虫”,结果被环境配置、第三方库的复杂依赖与高等数学公式劝退;要么长期停留在语法习题册里做控制台打印星号或四则运算,脱离了真实应用场景,学完即忘。
能够让零基础学习者进步最快的实战项目,通常具备三个核心特征:
- 输入与输出明确直观:运行代码后能立刻看到物理结果(例如文件被自动移动、生成了一张Excel表格或在终端输出了结构化报表)。
- 排错路径短、错误定位清晰:不依赖庞大黑盒框架,遇到报错能清晰看懂栈追踪信息,训练对Python原生异常的诊断敏锐度。
- 涵盖完整的编程闭环:包含“读取数据/接收输入 → 逻辑判断与变换 → 持久化存储/结果呈现”的完整生命周期。
二、第一梯队:本地自动化与文件分类整理器(稳固基础语法)
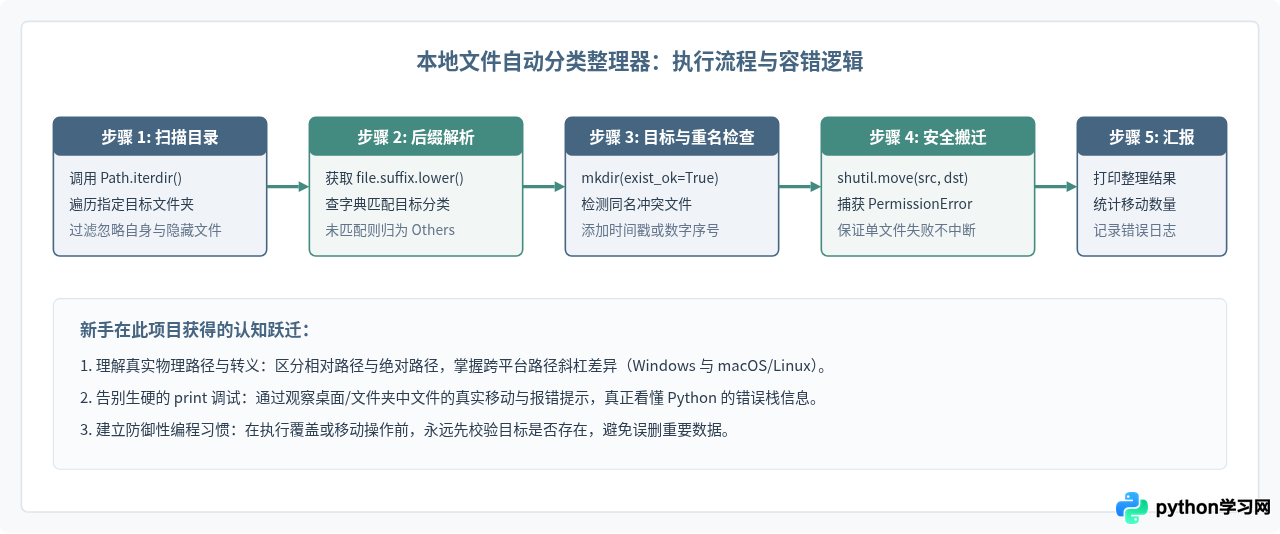
如果你刚学完变量、字典、条件判断和基础循环,首推项目是“下载目录自动分类整理工具”。这个项目能强迫你跳出空洞的算法题,直接面对本地操作系统的真实数据。
1. 解决的核心问题
每个人的电脑“下载”文件夹里通常堆满了安装包、文档、图片、压缩包。该工具能够根据文件后缀名,自动将乱糟糟的文件移动到对应的类别子文件夹中(如将 .png、.jpg 移动到 Images/,将 .pdf、.docx 移动到 Documents/)。
2. 核心技术点
- 标准库模块:
pathlib.Path或os、shutil。 - 容器与数据结构:利用字典(
dict)配置后缀与目录映射关系。 - 防破坏保护:目标路径冲突检测(
exists())、重命名规避覆盖。
3. 核心参考实现
from pathlib import Path
import shutil

# 后缀与目标分类文件夹的映射规则
CATEGORY_MAPPING = {
    "Images": [".jpg", ".jpeg", ".png", ".gif", ".webp"],
    "Documents": [".pdf", ".docx", ".txt", ".xlsx", ".pptx"],
    "Archives": [".zip", ".tar", ".gz", ".7z", ".rar"],
    "Installers": [".dmg", ".pkg", ".exe", ".msi"]
}

def organize_folder(target_dir_path: str):
    target_dir = Path(target_dir_path)
    if not target_dir.exists() or not target_dir.is_dir():
        print(f"错误:指定路径 '{target_dir_path}' 不存在或不是有效目录。")
        return

    moved_count = 0
    # 遍历当前目录下的所有项目
    for item in target_dir.iterdir():
        # 跳过子文件夹及隐藏文件
        if item.is_dir() or item.name.startswith("."):
            continue

        ext = item.suffix.lower()
        destination_category = "Others"

        for category, extensions in CATEGORY_MAPPING.items():
            if ext in extensions:
                destination_category = category
                break

        dest_folder = target_dir / destination_category
        dest_folder.mkdir(exist_ok=True)

        dest_file = dest_folder / item.name
        # 简单防重名处理
        if dest_file.exists():
            dest_file = dest_folder / f"{item.stem}_backup{item.suffix}"

        try:
            shutil.move(str(item), str(dest_file))
            print(f"已移动: {item.name} -> {destination_category}/")
            moved_count += 1
        except Exception as e:
            print(f"移动 {item.name} 时出错: {e}")

    print(f"\n整理完毕!共归档 {moved_count} 个文件。")

if __name__ == "__main__":
    # 测试时建议先在新建的测试空目录运行
    organize_folder("./test_downloads")
shutil.move。先手动建立一个包含 10 个测试文本与图片的 test_downloads 文件夹,运行确认无误后,再应用到真实目录。
三、第二梯队:公开数据采集与表格生成器(掌握结构化数据处理)
完成本地文件处理后,第二步应将视野扩展至网络世界。很多新手误以为“爬虫”就是暴力抓取反爬严格的商业网站,结果因为 Cookie、验证码、IP 封禁等门槛备受打击。最佳入门方式是抓取无复杂反爬机制的公开静态页面或开放 JSON API(如公开书单、天气预报、开源榜单),并将其转换为结构化的 CSV 或 Excel 文件。
1. 解决的核心问题
从网页或接口中获取杂乱的原始文本,通过解析提取关键字段(如标题、评分、作者、发布日期),最后按列对齐写入 .csv 表格,实现数据的沉淀与分析基础。
2. 核心技术点
- 网络请求:
requests.get()与自定义User-Agent请求头。 - HTML/JSON解析:使用
BeautifulSoup提取标签属性,或直接用标准库json反序列化。 - 数据持久化:使用标准库
csv模块进行逗号分隔符写入,解决中文utf-8-sig乱码问题。
3. 核心参考实现
import requests
from bs4 import BeautifulSoup
import csv

# 目标以公共练习站点为例(如 quotes.toscrape.com)
URL = "http://quotes.toscrape.com/"
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

def fetch_and_save_quotes(output_csv: str = "quotes.csv"):
    try:
        response = requests.get(URL, headers=HEADERS, timeout=10)
        response.raise_for_status() # 状态码非 200 时主动抛出异常
    except requests.RequestException as e:
        print(f"网络请求失败: {e}")
        return

    # 解析 HTML 内容
    soup = BeautifulSoup(response.text, "html.parser")
    quote_blocks = soup.find_all("div", class_="quote")

    extracted_records = []
    for block in quote_blocks:
        text_elem = block.find("span", class_="text")
        author_elem = block.find("small", class_="author")

        quote_text = text_elem.get_text(strip=True) if text_elem else ""
        author = author_elem.get_text(strip=True) if author_elem else "Unknown"

        extracted_records.append({
            "quote": quote_text,
            "author": author
        })

    # 写入 CSV 文件,采用 utf-8-sig 确保 Excel 打开中文不乱码
    with open(output_csv, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=["quote", "author"])
        writer.writeheader()
        writer.writerows(extracted_records)

    print(f"抓取成功!共提取 {len(extracted_records)} 条数据,已保存至 {output_csv}")

if __name__ == "__main__":
    fetch_and_save_quotes()
四、第三梯队:交互式命令行记账工具(建立状态与模块化思维)
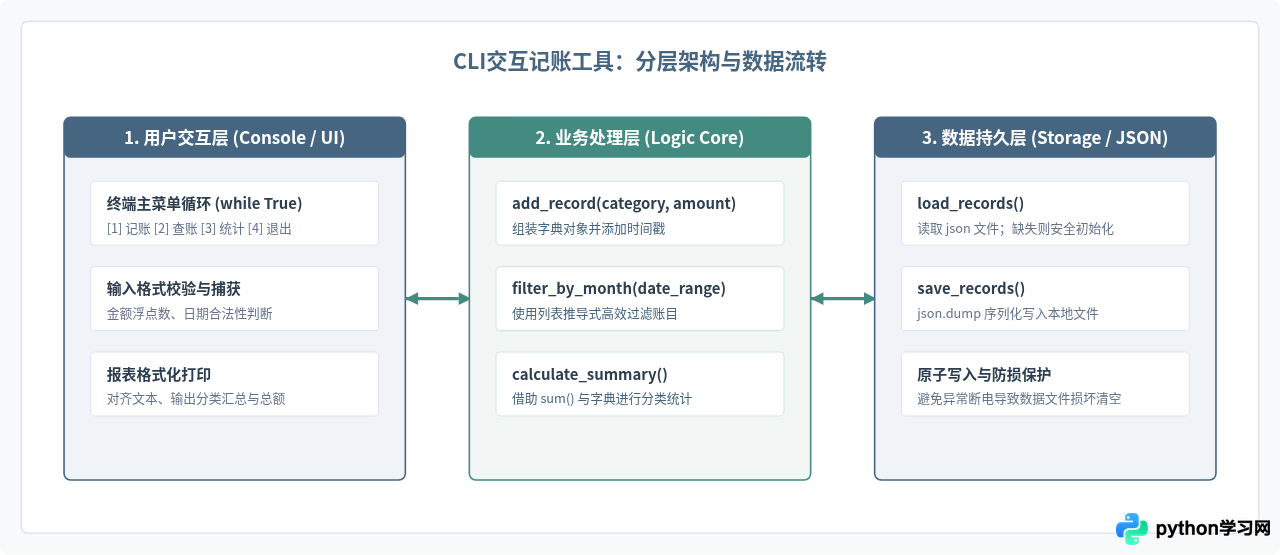
前面两个梯队属于“跑完即停”的批处理脚本。而在软件开发中,程序往往需要长时间处于运行状态,与用户持续交互,并维护内部状态。交互式命令行(CLI)个人记账与预算分析小工具是跨越“只会写单脚本”到“会组织模块化代码”的最佳项目。
1. 为什么该项目进步最明显?
在编写该项目的过程中,你第一次需要将功能拆分为不同的函数。例如:
- 不能把“用户输入金额”和“写入文件”写在一个死循环里,否则后续想加上“统计月度开支”功能时代码就会变成面条式浆糊。
- 必须掌握参数传递与返回值,学会把数据(账目字典)在各个函数间规范流转。
- 学会处理用户乱输入的问题(如在输入金额时输入了字母、或者在选择菜单时输入了不存在的选项),真正体会到
try-except与ValueError的实际保护价值。
五、第四梯队:微型Web服务或API接口(跨入现代软件开发门槛)
当你能够熟练写出无bug的CLI小工具并操作本地数据后,下一个飞跃点是理解现代互联网服务的本质:HTTP协议与客户端/服务端架构。
对于新手,极力推荐使用轻量级框架 FastAPI 或 Flask 实现一个简单的便签服务或天气看板API,而不是一上来就去啃庞大笨重的 Django。
核心目标与演进:
- 编写第一个路由接口:用几行代码让浏览器通过
http://127.0.0.1:8000/notes看到你返回的 JSON 列表。 - 理解前后端交互基础:搞懂
GET(获取数据)与POST(提交新建便签)的区别。 - 实现简单静态页面联动:通过一个最简单的 HTML 页面用原生 JavaScript
fetch()调用你的 Python 接口,体验全栈联调的乐趣。
六、零基础Python实战清单全景总结
为了帮助初学者制定清晰的学习规划,避免越级挑战导致信心崩溃,以下整理了这四个梯队项目的进阶要点对比:
| 梯队与项目名称 | 核心掌握技术 | 典型耗时 | 核心突破认知 |
|---|---|---|---|
| 梯队一:本地文件归档器 | pathlib, shutil, 字符串处理, 异常捕获 |
1 - 2 天 | 告别黑盒做题,建立操作系统物理文件操作信心 |
| 梯队二:数据提取与CSV生成 | requests, BeautifulSoup, csv, 字典推导 |
2 - 3 天 | 理解互联网公开数据结构与表格自动化生成 |
| 梯队三:CLI交互记账本 | 函数拆分, json持久化, while状态循环 |
3 - 5 天 | 学会模块化架构设计、输入校验与数据持久化 |
| 梯队四:微型Web应用/API | FastAPI / Flask, HTTP路由, 请求与响应 | 5 - 7 天 | 跨越单机脚本,理解现代网络服务与系统交互全貌 |
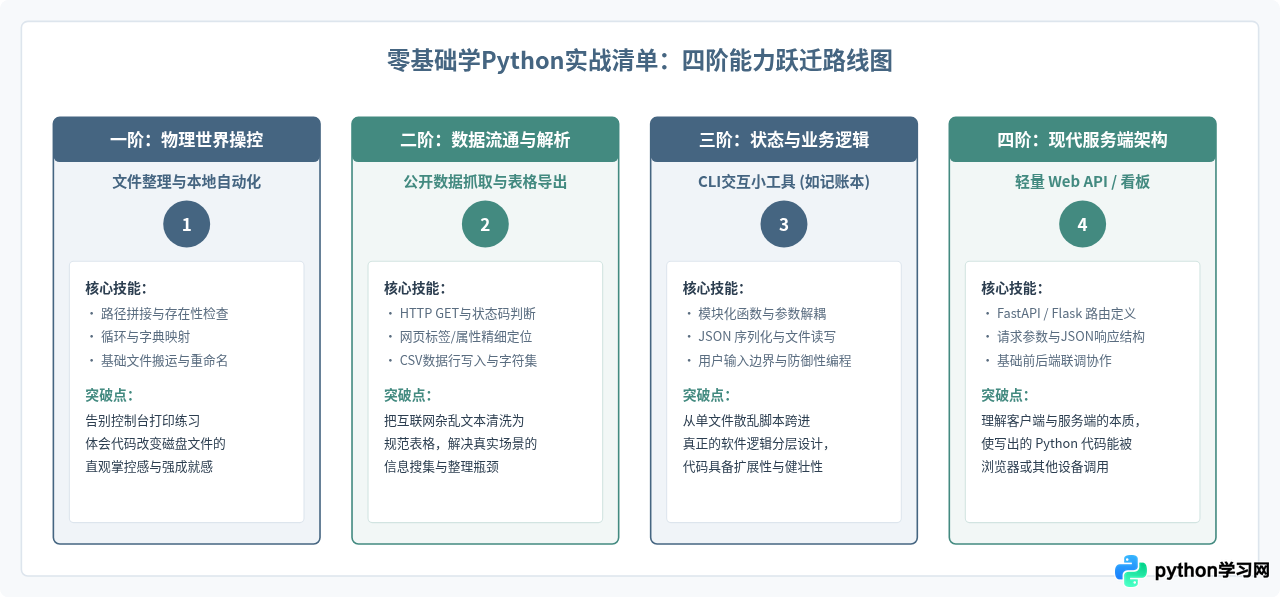
对于零基础学习者,编写代码最宝贵的资源不是时间,而是解决问题时获得的持续成就感。按照“本地文件整理 → 公开网络数据清洗 → 交互式状态管理 → 微型Web服务”的阶梯依次推进,每一个项目都能在一到三天内获得确定性的运行产出,你的Python编程能力与工程直觉也将在这一次次小而确定的闭环中以最快的速度建立起来。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









