

Python内置标准库与第三方常用库有什么区别?
深入对比Python内置标准库与第三方常用库的分发来源、存储机制、生命周期、使用方式与技术选型,配备清晰架构与流程图解。
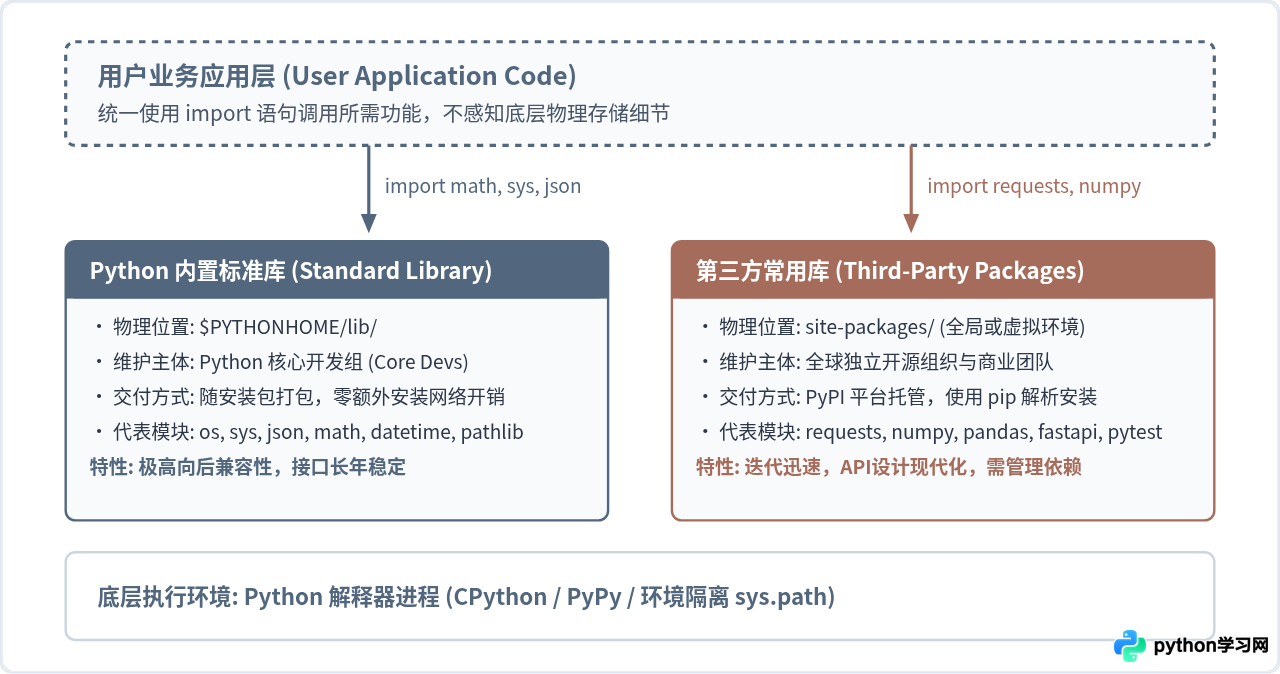
Python内置标准库与第三方常用库的核心区别在于分发来源、依赖生命周期与演进节奏:标准库由Python官方核心开发团队维护,随Python解释器一同分发,无需额外安装即可直接导入;第三方库则由开源社区独立研发与发布,托管在PyPI等公共索引仓库中,必须借助包管理工具显式安装至运行环境。理解二者的设计定位与边界,是编写稳定工程代码的关键前提。
在编写Python代码时,我们经常会输入 import os 或 import requests 这类语句。从语法形式上看,两者没有任何差异,都是将一个模块加载进当前的命名空间。然而,如果你将包含这两行代码的文件移交到一台刚安装好Python的全新机器上运行,import os 会立即成功,而 import requests 则会抛出 ModuleNotFoundError 异常。这个最常见的运行表现,恰恰揭示了两类模块在底层分发机制和系统定位上的本质不同。
一、概念定义与系统体系架构
Python自诞生以来便践行“自带电池”(Batteries Included)的设计哲学。这一理念的载体就是内置标准库。当用户从官方渠道安装Python解释器(例如CPython)时,系统不仅安装了执行字节码的虚拟环境,还附带了一整套标准库文件,涵盖系统交互、文本处理、数学计算、文件格式解析、并发控制等数十个领域。
与此相对,第三方常用库是开源社区为了解决各类专业领域问题(如现代高并发Web开发、分布式任务调度、科学计算与机器学习)而独立开发并共享的软件包。它们不受Python语言发布周期的限制,托管在官方包索引服务器(PyPI - Python Package Index)上,按需由使用者拉取集成。
二、操作流转:获取、安装与依赖生命周期
在日常开发的操作层面上,两者的区别体现在从“提出功能需求”到“代码成功执行”的完整生命链条中。标准库免除了环境配置与网络依赖,而第三方库则需要严密的版本声明与环境隔离控制。
1. 内置标准库的操作闭环
标准库无需安装,直接引用。以读写JSON文件为例,开发者只需确保Python处于可用状态:
import json

payload = {"name": "Antigravity", "status": "active"}
serialized = json.dumps(payload, indent=2)
print("序列化结果示例:")
print(serialized)
执行该脚本不需要网络连接,无论是在离线的生产服务器、嵌入式开发板还是容器精简镜像中,只要Python环境完整,代码均能直接正常运行。
2. 第三方常用库的操作步骤与环境隔离
第三方库不能直接全局裸装,必须在项目中配合虚拟环境管理工具使用。完整的规范流程包括以下操作步骤:
步骤一:创建隔离的虚拟环境
为防止不同项目的第三方依赖版本发生冲突,首先在项目根目录下创建独立环境:
python3 -m venv .venv步骤二:激活虚拟环境
根据所处操作系统执行对应的激活脚本,将当前命令行会话的 PATH 和 sys.path 指向该虚拟目录:
# Linux / macOS
source .venv/bin/activate

# Windows PowerShell
.\.venv\Scripts\Activate.ps1
步骤三:使用包管理器拉取并安装目标库
使用 pip 声明需要安装的包名,包管理器将自动解析其依赖图谱、下载Wheel二进制包或源码并放入该环境的 site-packages 目录:
pip install requests步骤四:在代码中调用并验证结果
安装完成后,模块在当前虚拟环境中可见,可以像标准库一样引入:
import requests

response = requests.get("https://httpbin.org/get")
print("HTTP响应状态码示例:", response.status_code)
步骤五:固化依赖清单以便团队协作
为了保证其他协同人员或部署机器能够获得完全一致的环境,导出精确的版本锁定文件:
pip freeze > requirements.txt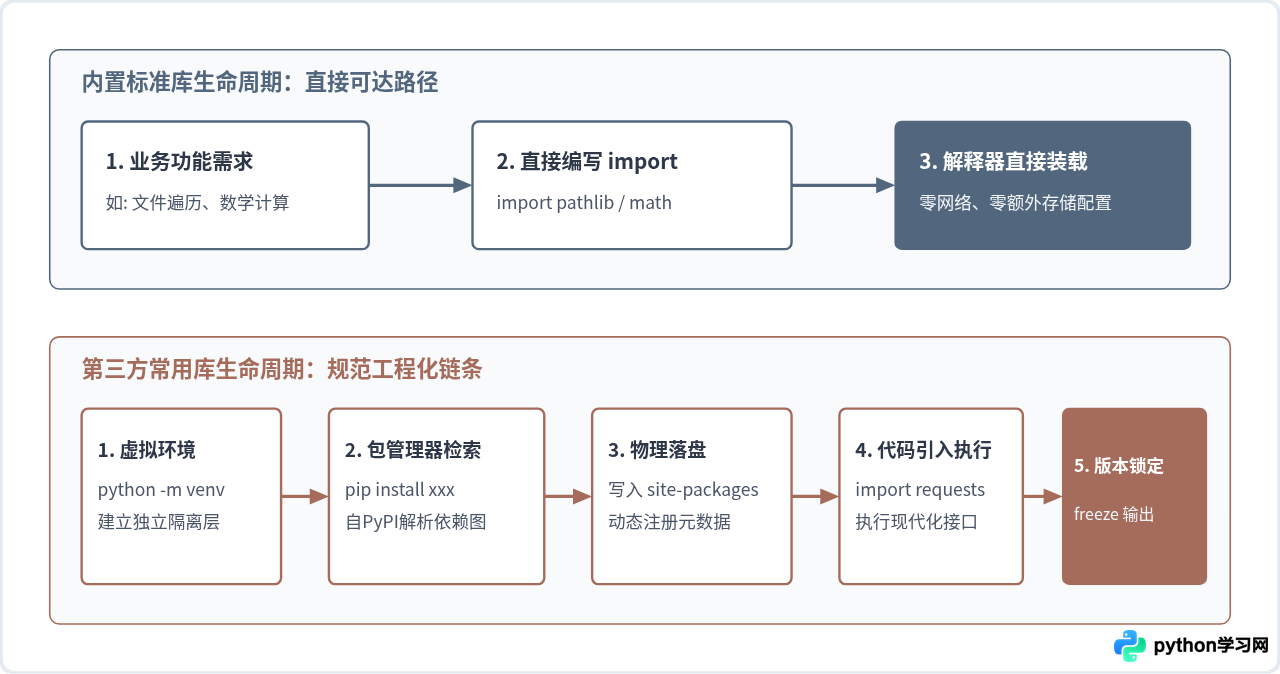
三、设计理念、迭代节奏与向后兼容性权衡
为什么Python不把所有优秀的第三方库直接收录进标准库?这是很多开发者在经历 urllib 与 requests 的体验落差后经常提出的疑问。这个现象背后,涉及开源软件治理中深层次的稳定性与创新速度的权衡。
1. 标准库的设计哲学:极致稳定与渐进式演变
标准库一旦被收录,其维护责任将永久移交给Python核心委员会。标准库遵循极其严格的向后兼容原则:
- 更新周期与语言绑定:标准库的新增特性和模块废弃只能随着Python的次版本(Minor Release,通常为每年一个版本,如 3.11 到 3.12)发布,日常无法单独发布小补丁引入新API。
- 长达数年的废弃周期(Deprecation Policy):移除标准库中过时的模块(例如 Python 3.13 移除 cgi 和 telnetlib 等 PEP 594 涉及的死库),需要经历数个版本周期的警告和讨论。
- 极度克制的依赖关系:标准库模块之间只能相互调用,严禁依赖任何外部第三方组件,这保证了安装Python解释器时的完全自闭环。
2. 第三方库的优势与潜在代价:敏捷演进与生态风险
第三方库由细分领域的专业团队或公司主导,能够采用现代软件工程中最激进的设计:
- 人体工学API(Developer Ergonomics):例如网络请求领域,标准库的
urllib.request需要处理繁重的字节流编码、异常捕获与Cookie管理器,而requests或httpx则以简洁直观的单行代码屏蔽所有底层繁琐机制。 - 版本不连续性(Breaking Changes):第三方库可遵循语义化版本(SemVer)自由发布大版本。主版本号升级时可能重构或废弃接口(例如 Pydantic v1 到 v2 的断代调整),若项目未做好版本锁定,容易引发线上构建失败。
- 供应链与依赖传递(Transitive Dependencies):引入一个第三方库可能间接引入数十个子依赖包,带来潜在的安全漏洞(CVE)与维护弃坑风险。
json.py 或 requests.py)。Python在根据 sys.path 解析模块时优先搜索当前工作目录,这会导致内置模块被局部同名文件遮蔽,产生诸如 AttributeError: partially initialized module 的隐蔽异常。
四、工程技术选型决策路径
在面对具体的业务需求时,是选用内置标准库还是引入第三方库,不应盲目遵循“库越多越先进”或“零依赖即最优”的极端教条,而应基于场景特征进行客观权衡。
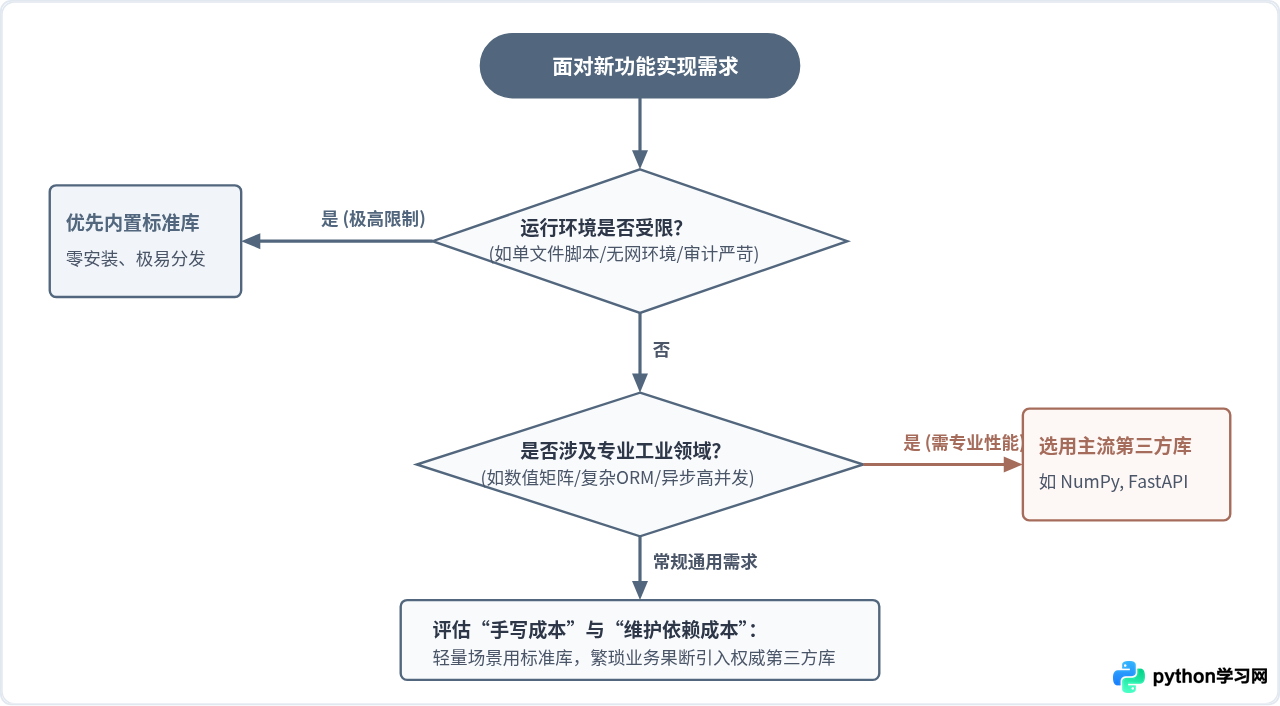
在做选型决策时,可参考以下实际判断依据:
- 优先采用标准库的场景:
- 运维排障与巡检自动化脚本:目标机器可能是未配置外网代理或受限的企业内网宿主机,依靠标准库的
subprocess,shutil,socket,argparse能确保脚本在任意机器即拷即用。 - 通用的基础结构件与协议定义:当编写需要对外分发的公共组件或开源SDK时,尽量减少无谓的第三方依赖项,避免给下游集成者引入依赖地狱(Dependency Hell)。
- 长期处于只读维护状态的边缘系统:不需要高频迭代的系统,采用内置库可以确保在数年内即便经历操作系统补丁和轻度解释器升级,代码依然正常跑通。
- 运维排障与巡检自动化脚本:目标机器可能是未配置外网代理或受限的企业内网宿主机,依靠标准库的
- 果断引入第三方库的场景:
- 生产级核心网络与微服务架构:标准库自带的
wsgiref或http.server仅适合教学调试,生产环境必须使用FastAPI,Uvicorn,Django或gRPC等具备连接池管理、生产级容灾与异步事件循环的高性能第三方库。 - 密集型数据处理与科学计算:纯Python循环在处理海量二维矩阵时效率有限,而基于底层C/Fortran优化的
NumPy,Pandas,Polars能提供成百上千倍的矢量化计算加速。 - 工程质量与测试自动化保障:标准库的
unittest继承了传统 xUnit 风格,但在现代工程实践中,代码表现力更强、插件生态完善的pytest能大幅缩短测试编写与错误定位的时间。
- 生产级核心网络与微服务架构:标准库自带的
五、综合特征对比与多维总结
为了给日常工程架构提供清晰的对照参考,下表汇总了内置标准库与第三方常用库在关键技术维度的具体表现:
| 对比维度 | Python 内置标准库 | 第三方常用库 (Third-Party) |
|---|---|---|
| 分发与交付 | 与 Python 解释器捆绑发布,官方单体交付 | 托管在 PyPI 独立服务器,通过 pip 按需拉取 |
| 物理存储路径 | 解释器安装目录下的 lib/ |
环境专属目录下的 site-packages/ |
| 使用前置操作 | 无需操作,只要 Python 环境就绪即可直接 import |
需初始化虚拟环境,执行 pip install 并写入依赖清单 |
| 迭代更新周期 | 受限于 Python 语言主干发布(约每年一个 Minor 版本) | 社区按需高频发版,由各自项目团队独立把控 |
| API 向后兼容性 | 极高,遵循 PEP 规范与漫长的弃用预警流程 | 视具体团队而定,遵循 SemVer,大版本更新可能存在破坏性变更 |
| 依赖传递风险 | 零外部依赖,系统自闭环,无外部供应链风险 | 可能引入复杂的依赖树,需关注安全审计与版本锁定 |
| 典型代表模块 | os, sys, json, math, datetime, pathlib, sqlite3 |
requests, numpy, pandas, pydantic, fastapi, pytest |
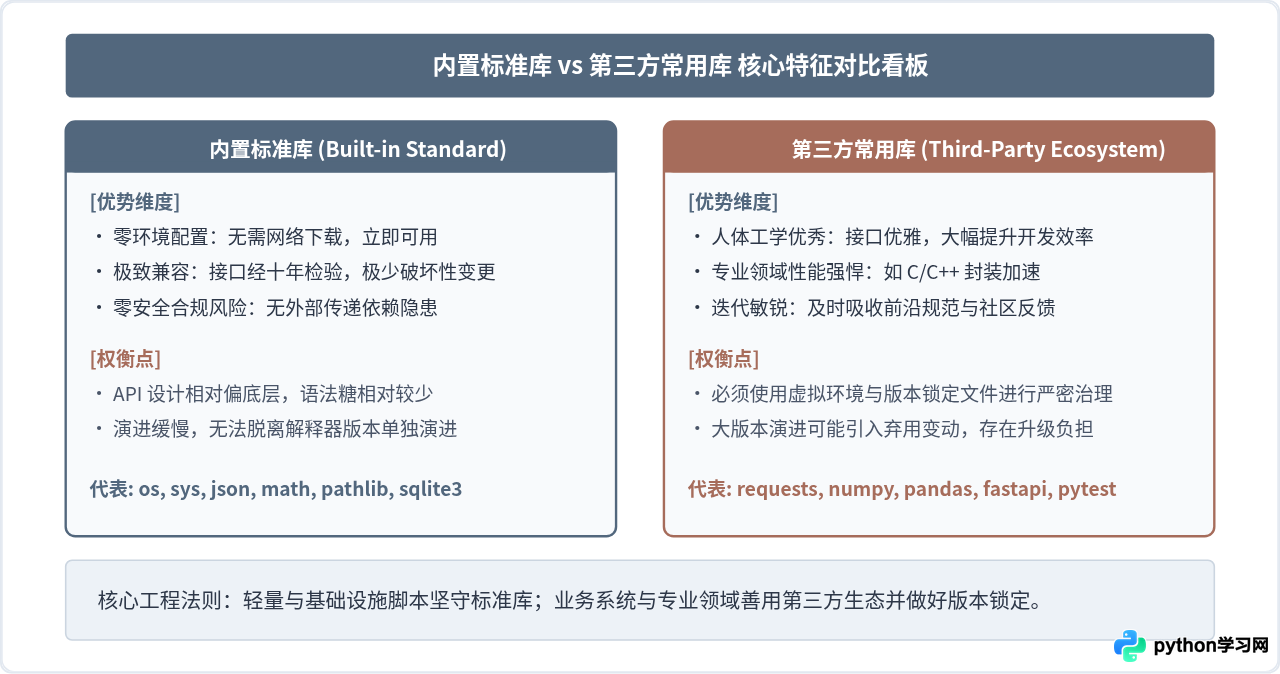
综上所述,Python内置标准库与第三方常用库不是非此即彼的对立关系,而是相互依存的层级生态。标准库提供了坚固、可靠且自包含的基础支撑基石,确保了Python作为通用编程语言的普适性与长久生命力;第三方库则凝聚了全球开源社区在各个具体技术领域的最佳实践,赋能Python应对现代软件工程中日益复杂的业务挑战。在实际开发中,深刻理解两者的区别,合理设计依赖边界,才能构建出既高效敏捷又稳固长青的软件系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









