

Python文档字符串(docstring)与普通多行注释的规范写法
深入解析Python文档字符串(docstring)与普通多行注释的核心差异、编译存储机制、PEP 257官方规范及Google/NumPy主流风格,提供规范示例与架构图示。
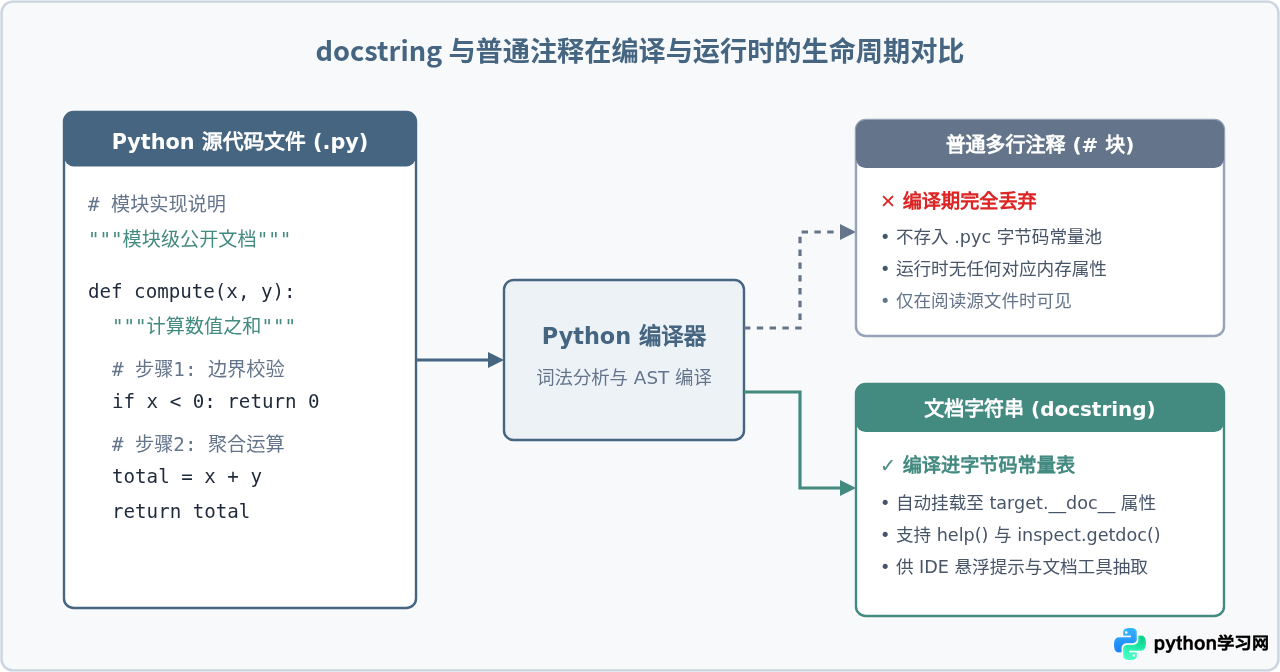
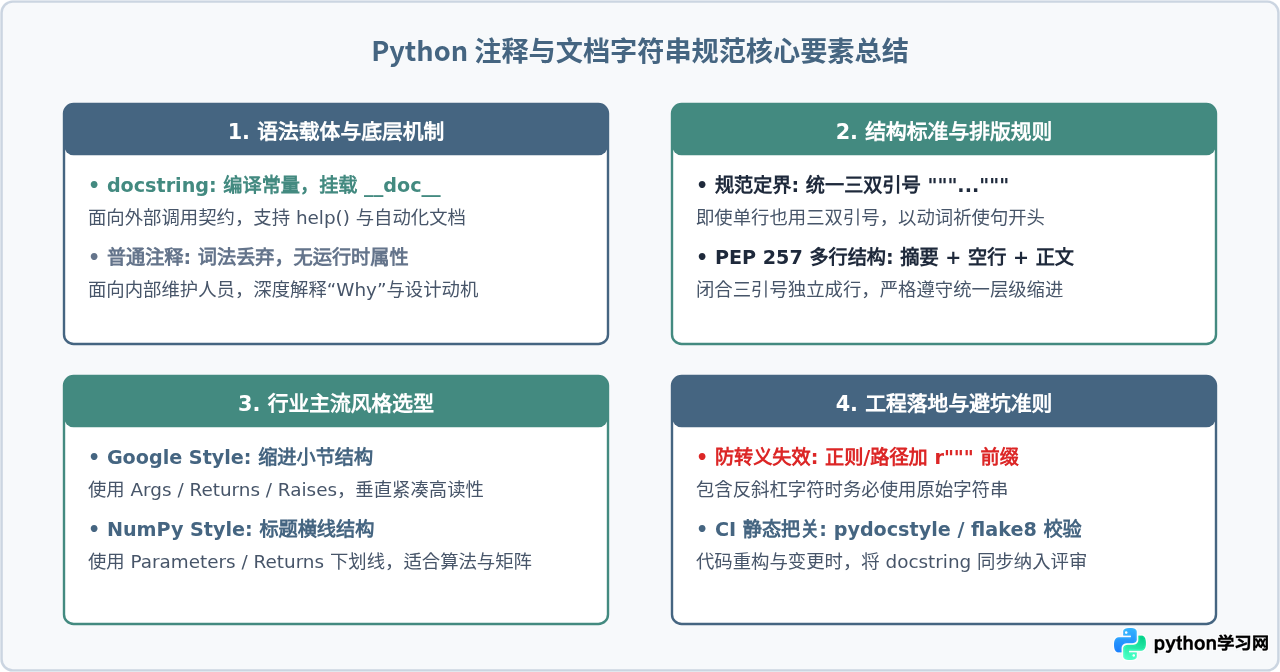
在 Python 开发中,文档字符串(docstring)与普通多行注释虽然都使用文本解释代码,但它们在语言规范、编译机制和工程定位上有着根本区别。简而言之,文档字符串是模块、类、方法或函数公共接口的组成部分,会被 Python 编译器保留在字节码中,并在运行时绑定到对象的 __doc__ 属性上,供 IDE 提示、反射检查和自动化文档生成器提取;而普通多行注释则是面向源码维护者的实现细节说明,在编译期被直接剥离,不参与运行时行为。本文将深入讲解两者的底层机制、规范写法以及在实际工程中的落地准则。
一、本质区别:语法定位与底层编译机制
理解两者的规范写法,首先需要理清它们在 Python 解释器内部的不同处理路径。许多开发者习惯用三引号字符串包裹一段文字并随意放置在函数体内作为多行注释,这种做法虽然在语法上不会报错,但在语义和执行机制上与正式的文档字符串并不等同。
| 对比维度 | 文档字符串 (docstring) | 普通多行注释 (Block Comments) |
|---|---|---|
| 官方规范依据 | PEP 257 (Docstring Conventions) | PEP 8 (Style Guide for Python Code) |
| 语法形式 | 位于定义后首行的三引号字符串 """...""" |
连续以 # 开头的行块 |
| 编译期处理 | 被编译器识别为常量,写入代码对象的 co_consts |
词法分析或语法解析阶段直接丢弃 |
| 运行时访问 | 通过 obj.__doc__ 或 help(obj) 直接读取 |
运行时完全不存在,无法通过任何代码反射访问 |
| 面向读者 | 函数、类或模块的外部调用者(使用契约) | 阅读并维护当前实现逻辑的内部开发者(实现细节) |
二、普通多行注释的工程规范与推荐写法
根据 Python 官方编码规范 PEP 8 的定义,行注释与块注释是解释代码具体实现、算法背景及权衡决策的主要手段。写好多行注释需要遵循以下关键规范:
1. 优先使用连续的井号块(#),而非裸三引号
在 Python 中,如果一段三引号字符串没有被赋值给任何变量,也没有放在模块、类或函数的首行,它在语法上是一个无害的“表达式语句”。很多初学者习惯用它来充当多行注释。然而 PEP 8 明确推荐使用由 # 开头的行块作为正式多行注释,原因在于:
- 语法高亮与工具识别一致: 所有编辑器和静态分析工具都能无歧义地将
#识别为注释行,不会将其与多行文本常量混淆。 - 避免缩进歧义与潜在开销: 裸三引号字符串如果出现在循环或性能敏感代码中,AST 仍会先构建常量节点(即使常数折叠优化可能介入),而在缩进复杂的逻辑块中使用三引号更容易引发不可见的语法对齐问题。
2. 块注释的格式与排版要求
编写由 # 构成的多行块注释时,应当遵循以下格式约束:
- 每个
#后面保留一个标准空格,随后开始书写正文。 - 注释的缩进级别必须与所解释的代码保持完全一致。
- 注释内部如果需要分段,段落之间使用仅包含
#的空行进行分隔,不要留出完全空白的行。 - 每行注释长度建议限制在 72 至 79 个字符以内,确保在分屏阅读时不产生水平滚动。
# 推荐的普通多行注释规范写法
#
# 对于高并发网络请求,此处不采用全量同步锁,
# 而是通过分段哈希槽减少锁竞争频次。
#
# 如果下游网关响应超时超过 500ms,触发指数退避重试,
# 最多重试 3 次以防止级联雪崩。
def acquire_resource(slot_id, retry_limit=3):
pass优秀的代码本身就应该清晰展示“正在做什么”。普通多行注释的最高价值在于解释那些无法直接从变量名和语法逻辑看出来的上下文——例如背后的业务规则、选择某种特殊算法的原因、规避某个底层 bug 的临时解决方案等。
三、PEP 257 文档字符串规范与结构剖析
PEP 257 是专门针对 Docstring 建立的官方规范。文档字符串可以出现在三个层级:模块开头、类定义体开头、函数/方法定义体开头。无论在哪种层级,文档字符串都必须紧随定义的第一条语句出现。
1. 引号规范与基础约定
所有文档字符串统一使用成对的三重双引号 """..."""。即使是单行文档字符串,也应当使用三重双引号,以便未来扩充为多行时无需修改定界符。
2. 单行文档字符串(One-line Docstrings)
单行文档字符串适用于极其明显、功能单一的函数或方法。规范要求:
- 起始三引号、摘要内容和闭合三引号位于同一行。
- 使用祈使句(Imperative mood)语气,以动词开头,例如“计算两点间欧氏距离。”而非“本函数用来计算……”。
- 摘要末尾使用句号结尾,前后不留额外空行。
def get_user_status(user_id: int) -> bool:
    """返回指定用户当前是否处于活跃登录状态。"""
    return user_id in active_sessions
3. 多行文档字符串(Multi-line Docstrings)的标准结构
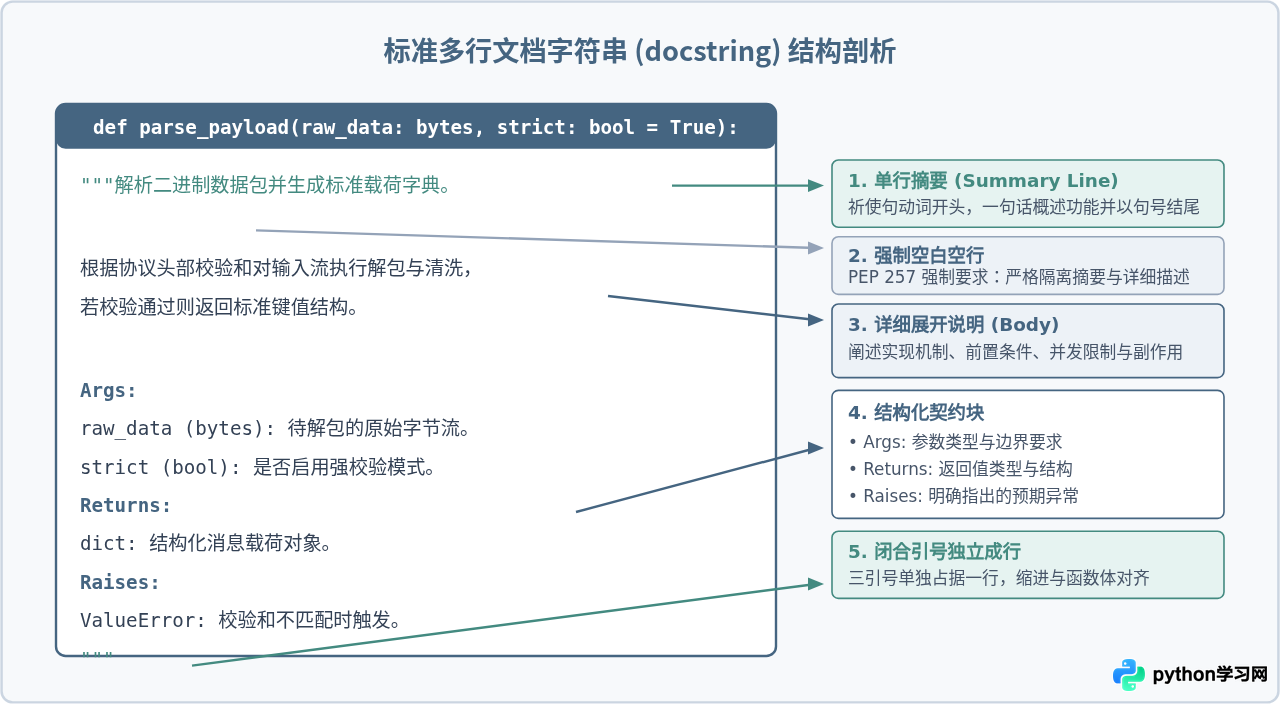
多行文档字符串由五个核心部分构成:单行摘要、空白分隔行、详细功能描述、结构化参数/返回值/异常说明、独立成行的闭合引号。
四、主流工程风格选择与编写流程
PEP 257 仅规定了宏观的结构规则,并未细化参数列表、返回值和异常的具体排版语法。在大型项目与开源生态中,两大主流风格确立了事实标准:Google Style 与 NumPy Style。
1. Google 风格(Google Python Style Guide)
Google 风格使用简洁的缩进段落组织文档,视觉紧凑且易读性极高,是 Web 应用、微服务和常规 Python 项目中最广泛采用的规范。
def transfer_funds(source_acc: str, target_acc: str, amount: float) -> bool:
    """在两个内部账户之间执行原子转账交易。

    执行前检查源账户可用余额,并锁定双方账户行记录以保证
    并发隔离级别。整个转账在单一数据库事务内完成。

    Args:
        source_acc (str): 转出资金的账户流水号。
        target_acc (str): 转入资金的目标账户流水号。
        amount (float): 转账金额,必须大于 0.01。

    Returns:
        bool: 交易成功提交返回 True。

    Raises:
        InsufficientBalanceError: 当源账户可用资金不足时抛出。
        AccountLockedError: 目标账户处于冻结状态时抛出。
    """
    pass
2. NumPy / SciPy 风格
NumPy 风格使用横线(减号)为小节添加下划线,结构庄重、排版严整,能够容纳详尽的数学公式、矩阵维度说明与科学计算背景,在 NumPy、SciPy、Pandas、PyTorch 等数据科学与算法库中占据统治地位。
def normalize_matrix(matrix: np.ndarray, axis: int = 0) -> np.ndarray:
    """沿着指定维度对输入矩阵执行 L2 范数归一化。

    Parameters
    ----------
    matrix : np.ndarray
        二维浮点数组,形状为 (M, N)。
    axis : int, optional
        执行归一化的轴索引,默认为 0(沿列方向归一化)。

    Returns
    -------
    np.ndarray
        归一化后的新数组,形状与输入保持一致。

    Notes
    -----
    若某一维度的范数为零,计算时将使用机器精度微小量 epsilon 规避除零异常。
    """
    pass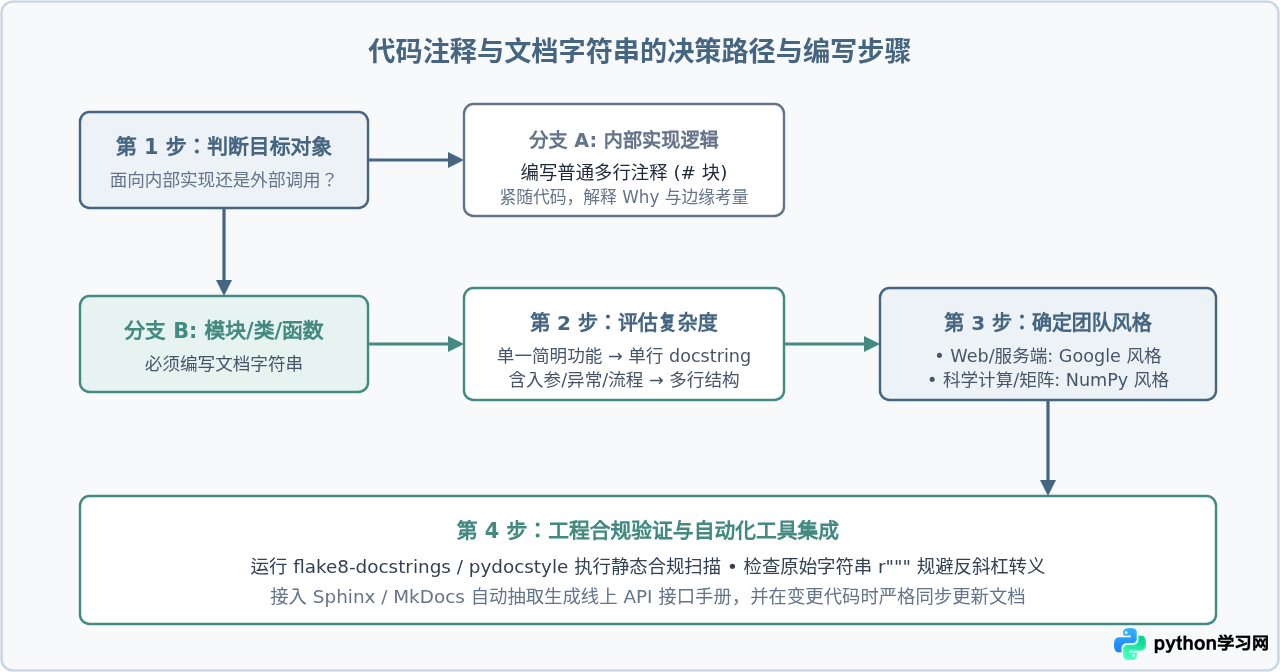
五、常见易错陷阱与进阶注意事项
在编写文档字符串和多行注释的过程中,开发者常因细节疏忽引入格式问题或工具兼容错误。以下是四项最典型的注意事项:
1. 正则表达式与 Windows 路径下的反斜杠转义
当文档字符串中包含反斜杠(例如正则表达式模式 \d+ 或路径 C:\tools)时,普通的 """ 会在词法解析时被当成转义符处理,从而破坏实际字符。规范做法是:只要文档中存在反斜杠,务必使用原始字符串定界符 r"""..."""。
def match_phone_number(text: str) -> list[str]:
    r"""提取文本中所有匹配的国内手机号码。

    匹配规则:
        前缀匹配 1[3-9],后续跟随 9 位数字:r"^1[3-9]\d{9}$"。

    Args:
        text (str): 输入的待检测纯文本。
    """
    pass
2. 缩进不齐导致文档提取工具排版错乱
Python 官方库提供了 inspect.cleandoc(doc) 函数来清除文档字符串的多余缩进。如果你的多行 docstring 中后续行的缩进少于首行,或者在编辑器中混用了制表符和空格,会导致 Sphinx 或 IDE 生成的文档页面出现不正常的代码块缩进或段落折叠。
3. 不要把过期的注释和文档遗留在代码中
代码重构后未同步修改 docstring 比不写文档更具破坏性。如果函数参数已经改名为 timeout_seconds,而 docstring 依然保留 timeout_ms,将对调用方造成严重误导。在代码审查(Code Review)流程中,必须把文档字符串的同步更新视为硬性检查项。
4. 模块级别与类级别的标准放置位置
- 模块级 docstring: 必须放在
.py文件的最顶端(在所有import语句之前,仅可排在编码声明# -*- coding: utf-8 -*-之后)。 - 类级 docstring: 紧随
class ClassName:定义行下方,详细解释类的职责、主要属性列表(Attributes:),而__init__方法内则聚焦于构造参数(Args:)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









