

Python读取CSV文件时怎么跳过表头或指定行数
全面讲解Python在读取CSV文件时跳过表头、前N行元数据或任意指定行数的实用方法。涵盖标准库csv、itertools.islice与Pandas的详细语法、代码示例、执行时序及避坑建议。
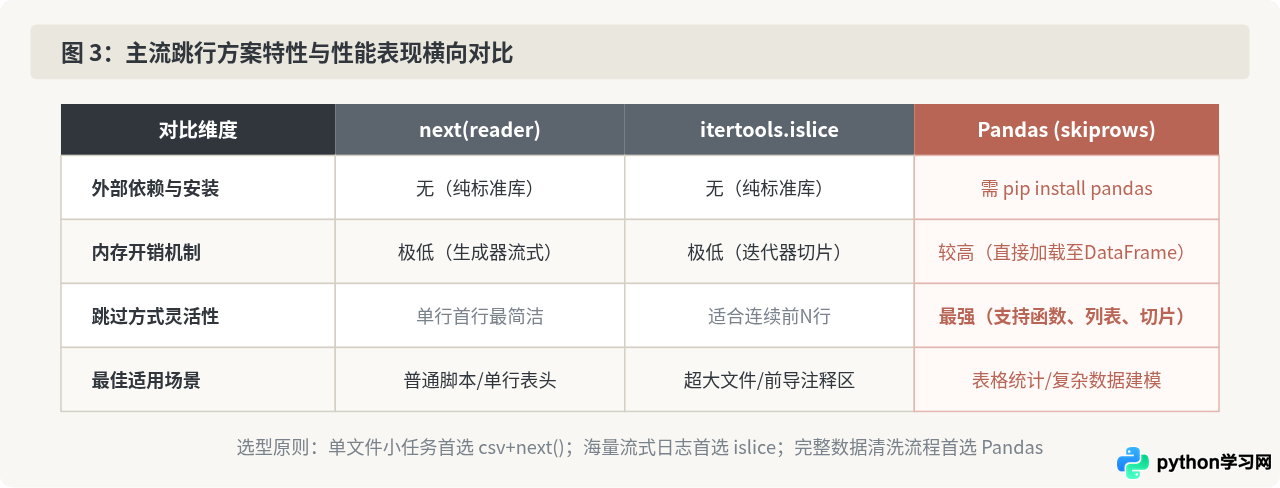
在日常数据处理中,CSV文件的顶部往往包含列名表头,或者掺杂着导出工具生成的元信息、说明性文字和空行。在Python中读取这类文件时,如果直接解析数据行,程序就会把说明文本误当作数值,进而引发类型转换异常。针对跳过表头或指定行数的需求,核心解决路径通常分为两类:如果只使用Python标准库,使用next()函数可以单步跳过首行表头,结合itertools.islice()则能精确跳过前N行;如果使用数据分析库Pandas,直接在read_csv()中指定skiprows参数即可完成首行、多行以及任意离散行数的过滤。
一、使用标准库 csv 模块跳过表头或固定行数
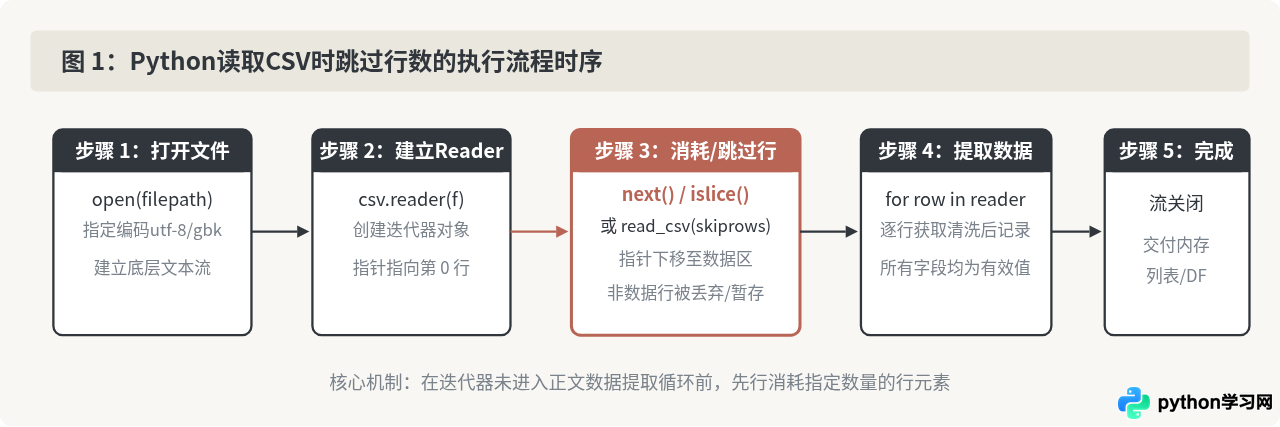
Python内置的 csv 模块无需安装任何外部依赖,是轻量级脚本和流式处理的首选方案。csv.reader 本质上返回一个可迭代对象(Iterator),每次调用都会产出CSV中的下一行。
1. 跳过单行表头:使用 next() 函数
当CSV文件的第1行是列名,第2行起就是正文数据时,最惯用的做法是在进入 for 循环前对 reader 对象调用一次 next()。这会直接消耗掉迭代器的第一个元素:
import csv

file_path = "sales_data.csv"

with open(file_path, mode="r", encoding="utf-8") as f:
    reader = csv.reader(f)

    # 消耗第一行表头,并将列名保存在 header 变量中(若无需使用,可直接写 next(reader))
    header = next(reader)
    print("跳过的表头字段:", header)

    # 后续循环直接从第2行数据行开始
    for row in reader:
        print("数据记录:", row)
运行结果示例:
跳过的表头字段: ['id', 'product', 'price', 'quantity']
数据记录: ['101', 'Notebook', '25.5', '2']
数据记录: ['102', 'Pen', '4.0', '10']
如果目标CSV文件可能为空,直接调用 next(reader) 会抛出 StopIteration 异常。可以通过传递默认值来避免报错,例如 header = next(reader, None)。当文件完全为空时,header 将得到 None,后续遍历也不会抛出异常。
2. 跳过前 N 行元数据:结合 itertools.islice()
许多系统导出的CSV文件在前几行会附带制作人、导出日期或报表标题等元数据,例如前3行全为注释文字,从第4行起才是字段名或正文。若连续编写多次 next(reader) 虽能生效,但不够通用。此时使用标准库 itertools.islice 是最规范的做法:
import csv
from itertools import islice

file_path = "report_with_meta.csv"
skip_count = 3  # 跳过前 3 行无关说明

with open(file_path, mode="r", encoding="utf-8") as f:
    reader = csv.reader(f)

    # islice(可迭代对象, 起始索引, 终止索引)
    # 起始索引为 skip_count,终止索引为 None 代表切片提取直至末尾
    data_stream = islice(reader, skip_count, None)

    for row in data_stream:
        print(row)
二、跳过任意离散行或满足特定条件的行
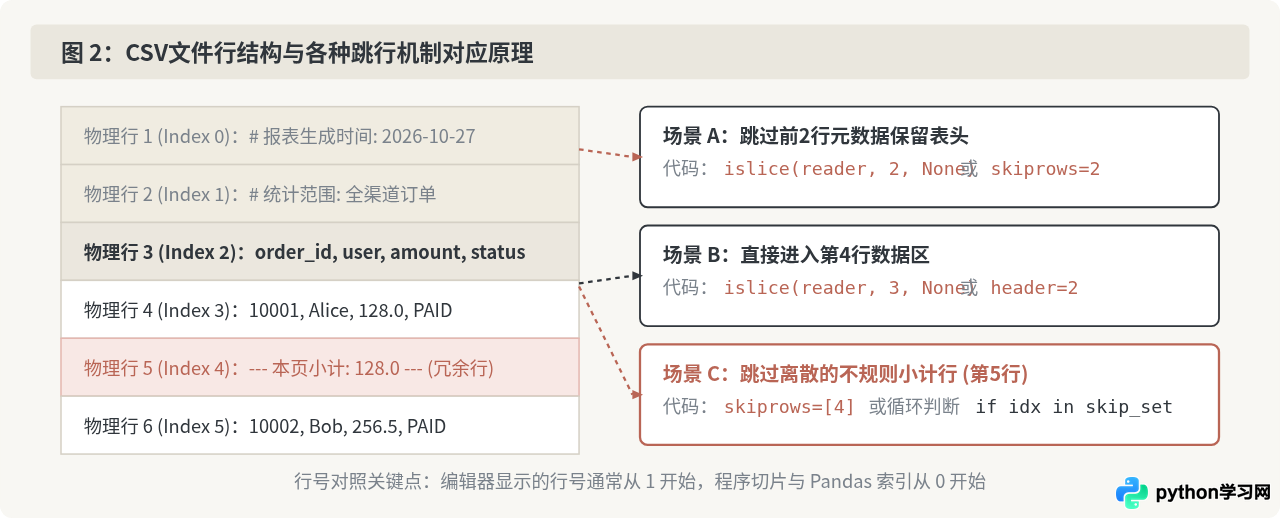
有时我们需要跳过的并不局限在文件开头,而是分散在文件各处的无效行,例如第 1、第 5、第 12 行,或是所有以 #、// 开头的注释行。
1. 使用 enumerate() 跳过指定行号列表
在标准库下,可以结合内置的 enumerate() 获取从 0 开始的行索引,并配合集合(set)过滤掉目标行:
import csv

file_path = "data_with_blank_lines.csv"
# 定义要忽略的 0-based 行索引:例如跳过第 0 行(表头)和第 4 行(阶段汇总行)
ignored_indices = {0, 4}

with open(file_path, mode="r", encoding="utf-8") as f:
    reader = csv.reader(f)
    for line_idx, row in enumerate(reader):
        if line_idx in ignored_indices:
            continue
        # 处理有效数据
        print(f"有效数据行 (原行号 {line_idx + 1}):", row)
2. 根据内容特征动态跳过(注释行或空行)
如果不需要固定行号,而是按内容模式跳过,可以直接在行遍历中增加判定条件:
import csv

file_path = "config_data.csv"

with open(file_path, mode="r", encoding="utf-8") as f:
    reader = csv.reader(f)
    for row in reader:
        # 跳过空列表(空行)或首个字段以 '#' 开头的注释行
        if not row or row[0].strip().startswith("#"):
            continue
        print("有效业务行:", row)
三、使用 Pandas 读取时跳过表头或指定行
如果项目本身引入了 Pandas 进行数据分析,使用 pandas.read_csv() 能够以更简洁的声明式语法完成跳行控制。核心参数包括 skiprows 与 header。
1. skiprows 参数的三种传参形式
- 传入整数
n:跳过文件前n行。例如skiprows=2表示直接跳过前两行。 - 传入列表
[i, j, k]:精确跳过指定行号(基于 0 索引)。例如skiprows=[0, 2, 5]表示跳过第 1 行、第 3 行与第 6 行。 - 传入可调用函数(Callable):根据行索引的逻辑运算决定是否跳过。例如只读取偶数行、或跳过包含特定特征的行。
import pandas as pd

file_name = "complex_report.csv"

# 方式一:直接跳过前 3 行说明性文字,第 4 行作为 DataFrame 的列名
df1 = pd.read_csv(file_name, skiprows=3)

# 方式二:跳过指定的行索引(例如第 0 行是主标题,第 2 行是废弃占位符)
df2 = pd.read_csv(file_name, skiprows=[0, 2])

# 方式三:使用 Lambda 函数动态跳过(例如跳过所有行索引能被 10 整除的行,且保留首行表头)
df3 = pd.read_csv(
    file_name,
    skiprows=lambda x: x > 0 and x % 10 == 0
)
2. header 参数与 skiprows 的协同使用
初学者在使用 pd.read_csv 时常遇到的困惑是:跳过了前面的行之后,列名(Column Name)到底会由哪一行充当?
- 如果原文件前两行是说明文字,第三行是实际列名,设置
header=2(0 索引)即可直接把第 3 行作为表头,并自动跳过前面的 0、1 行。 - 如果原文件完全没有列名表头,全是纯数据,或者你希望通过
skiprows把所有表头都抹去,需要显式指定header=None,否则 Pandas 默认会把跳过后的第一条有效数据误当成列名。
# 场景:跳过前 1 行错误表头,且不使用原文件任何列名,自定义指定列名
df = pd.read_csv(
    "raw_records.csv",
    skiprows=1,          # 跳过原文件的第 1 行
    header=None,         # 告知 Pandas 剩下内容中没有表头行
    names=["id", "username", "score", "created_at"]  # 自定义列名
)
四、容易出现的常见问题与注意事项
在实际操作中,很多报错并不是因为跳行代码本身有误,而是由文件格式或索引理解偏差导致的。以下是需要特别留意的关键点:
1. 0 索引与 1 索引的偏差
文本编辑器(如 VS Code、Sublime Text)或 Excel 查看文件时,左侧显示的行号是从 1 开始的。而在 Python 中,无论是 enumerate() 还是 Pandas skiprows=[...] 列表,索引都是从 0 开始。如果你想跳过 Excel 中看到的第 5 行,在 Pandas 中应指定 skiprows=[4],否则就会误跳过第 6 行。
2. UTF-8 BOM 导致首行读取异常
在 Windows 环境下用 Excel 导出的 CSV 文件常带有 BOM(Byte Order Mark)。如果以常规的 utf-8 编码打开,首行首列的字段名前会带有不可见的 \ufeff 字符。这会导致表头名字变成 \ufeffid,后续根据字段名匹配时就会报 KeyError。解决方法是在打开文件时明确指定编码为 utf-8-sig:
# 推荐在包含中文或Windows导出的CSV中使用 utf-8-sig
with open("data.csv", mode="r", encoding="utf-8-sig") as f:
    reader = csv.reader(f)
    header = next(reader)
3. 大文件处理时的内存警惕
对于数百万行或文件体积达到数 GB 的超大 CSV 文件,切忌采用“先全部读取成列表再用切片 data[1:] 跳过”的做法。这种方式会一次性将整个文件载入内存,引发内存溢出(OOM)。标准库的 next(reader) 与 islice(reader, n, None) 均为流式惰性求值,无论文件多大都只维持单行常数级内存占用。
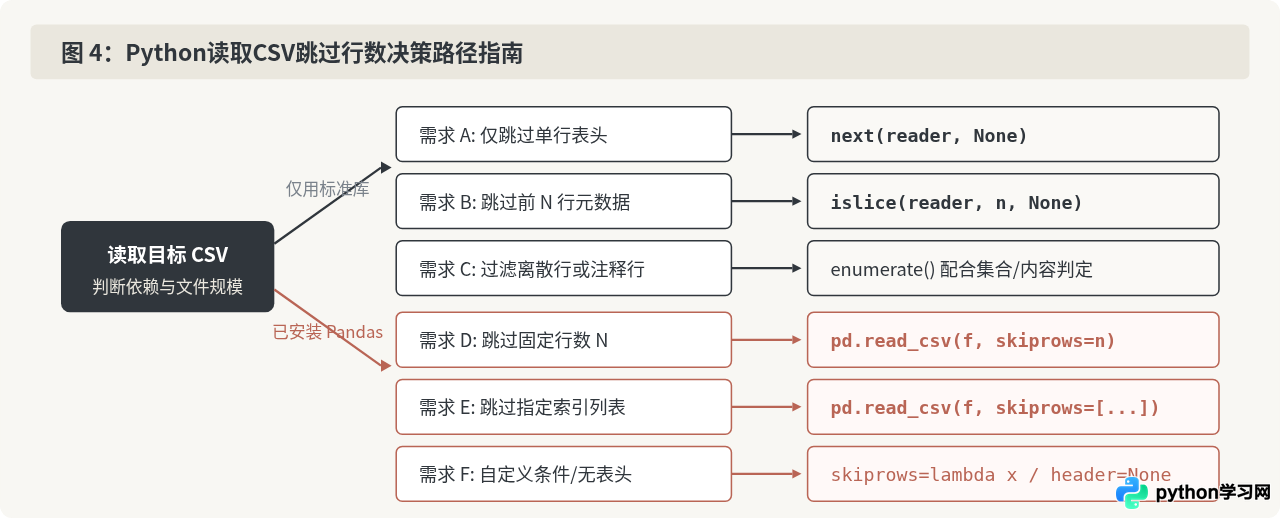
五、总结
处理CSV文件时跳过表头或指定行数是数据清洗的基础操作。总结起来,选择策略非常明确:
- 轻量级或无第三方库环境:对于常见的“跳过首行字段名”,使用
next(reader, None)即可;如果要跳过固定数量的前 N 行,引入itertools.islice(reader, n, None)能够保持极高的代码可读性与零内存压力。 - 离散行或条件注释:通过
enumerate()获取真实行号配合条件判断,能够在不破坏迭代器状态的前提下过滤杂质行。 - 数据分析与多维清洗:使用
pandas.read_csv()的skiprows参数(支持整数、行索引列表或 Lambda 谓词)最为直接,同时配合header参数校准列名来源,可以快速得到格式规范的 DataFrame。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









