

Python中何时使用@property而非普通方法或直接属性
深入对比Python中的直接属性、@property装饰器与普通方法,结合实际代码和场景分析其定位、开销预期与选择边界,帮助开发者写出更符合Pythonic风格的面向对象代码。
在Python面向对象编程中,公开一个数据或能力通常有三种途径:公开直接属性(Direct Attribute)、@property 属性装饰器 以及 普通实例方法(Method)。简明判断准则是:凡是不需要额外校验与动态推导的简单状态,优先使用直接属性;需要将动态计算、数据校验或只读防护封装为“属性式访问”时,使用 @property;而需要接收参数、包含耗时较长的I/O操作、或者明显代表执行动作(动词操作)时,必须使用普通方法。
一、三者的核心定位与访问形态
Python倡导简洁直接的设计哲学。与其他部分面向对象语言(如Java中约定俗成的私有字段加Getter/Setter)不同,Python支持统一访问原则(Uniform Access Principle),调用方通过 obj.name 读取数据时,不需要关心底层是直接读取内存字典还是触发了背后的一段逻辑函数。
为了直观对比这三者的语法形态,我们先来看一段简单的圆形定义示例:
import math

class Circle:
    def __init__(self, radius: float):
        # 1. 直接属性:纯粹的数据存储
        self.radius = radius

    # 2. @property:表现为属性,实为动态计算(只读)
    @property
    def area(self) -> float:
        return math.pi * (self.radius ** 2)

    # 3. 普通方法:接收参数、执行明确的操作动作
    def scale(self, factor: float) -> None:
        if factor <= 0:
            raise ValueError("缩放因子必须大于0")
        self.radius *= factor

# 调用端表现
c = Circle(5.0)
print(c.radius)     # 5.0      -> 直接属性访问
print(c.area)       # 78.5398  -> 属性化调用(无需加小括号)
c.scale(2.0)        # 动作执行 -> 方法调用(显式传参并加小括号)
print(c.area)       # 314.159  -> 动态联动更新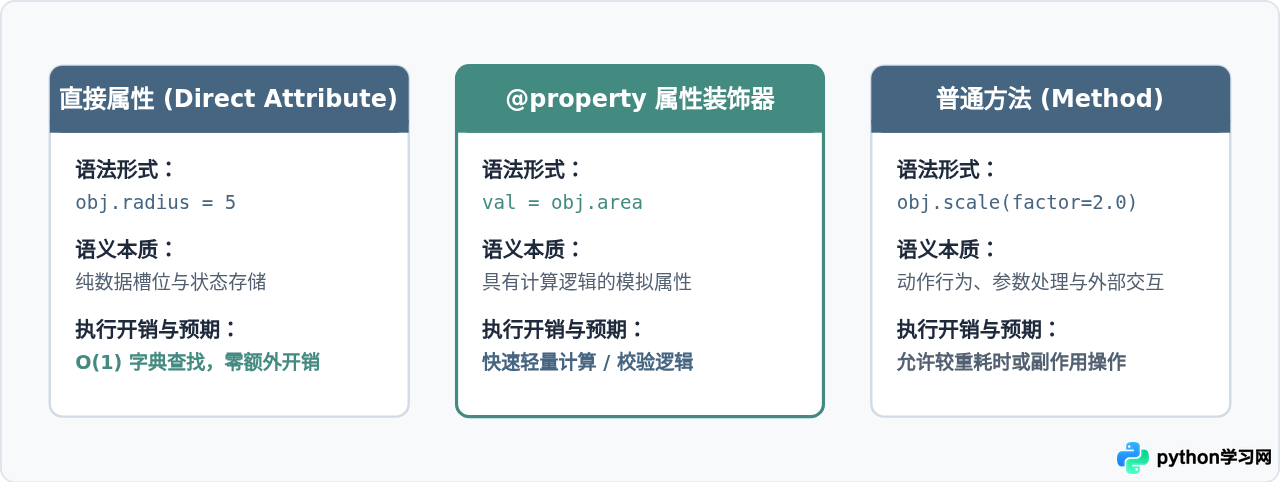
二、何时应该坚决使用直接属性?
在Python初学阶段,很多具有Java或C++背景的开发者习惯在一开始就为每个属性编写 get_x() 和 set_x()。在Python中这是一种反模式(Anti-pattern)。
只要满足以下条件,就应当毫无顾虑地直接使用普通属性 self.attr = value:
- 属于纯粹的状态记录:例如用户的姓名、重试次数、配置开关、坐标点等。
- 写入时无需数据转换或边界校验:赋值过程不存在范围过滤、格式截断或关联字段联动刷新。
- 读取时无需派生计算:属性值即为其在内存中的真实表示,不依赖其他属性动态推导。
因为Python提供了
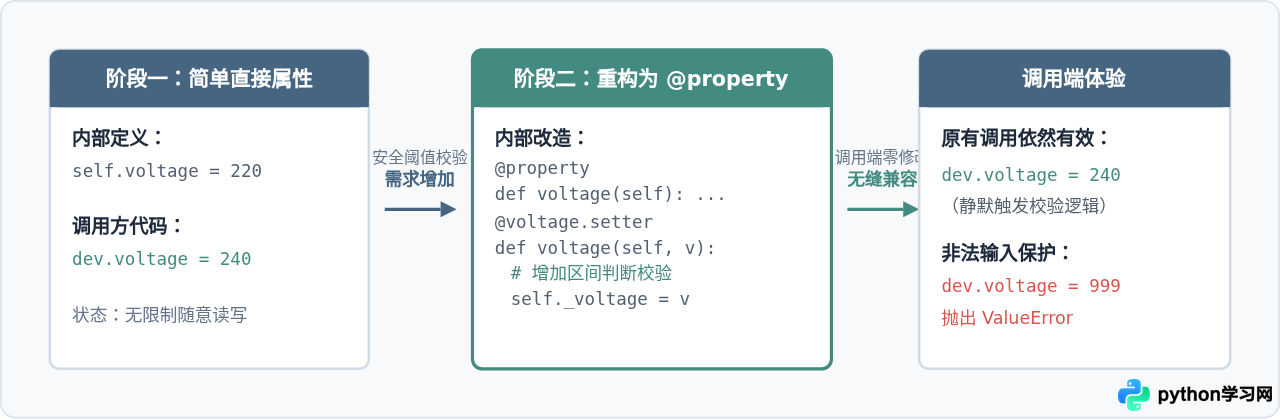
@property 特性。如果未来业务需求变更,需要对某个直接属性增加校验或变更为动态计算,你可以直接将其重构为 @property,而完全不破坏任何外部调用方的代码。
三、何时使用 @property 而非其他形式?
@property 的本质是一个描述符(Descriptor)。它最适合用于调用者在逻辑认知上认为这是一个属性,但实现上需要逻辑介入的场景。典型应用场景包括以下四类:
1. 动态衍生属性(只读计算)
当一个值可以通过现存的内部属性直接推导计算出来,且计算成本较低时,将其实现为 @property 可以确保数据永远保持一致,避免因冗余存储而导致的状态不同步。
class User:
    def __init__(self, first_name: str, last_name: str):
        self.first_name = first_name
        self.last_name = last_name

    @property
    def full_name(self) -> str:
        # 动态衍生,避免冗余存储 full_name 导致修改姓或名时数据脱节
        return f"{self.first_name} {self.last_name}"

user = User("Guido", "van Rossum")
print(user.full_name)  # "Guido van Rossum"
user.first_name = "Python"
print(user.full_name)  # "Python van Rossum" (自动保持同步)
2. 数据校验与合法性约束(Setter防护)
当属性需要接受外部赋值,但必须保证类型正确、数值在有效区间内时,配合 @attr.setter 可以无缝实现校验拦截。
class BankAccount:
    def __init__(self, balance: float):
        self.balance = balance  # 会走 balance.setter 校验

    @property
    def balance(self) -> float:
        return self._balance

    @balance.setter
    def balance(self, value: float) -> None:
        if not isinstance(value, (int, float)):
            raise TypeError("账户余额必须为数值类型")
        if value < 0:
            raise ValueError("账户余额不可为负数")
        self._balance = float(value)
3. 不破坏公开接口的无痛平滑重构
这是 @property 最具价值的工程实践。最初发布的代码可能直接公开了 temperature 字段,随着系统演进,需要对温度单位统一转为摄氏度并做防冻保护,利用属性装饰器可以在保持原有属性访问语法不变的前提下完成功能升级。
四、何时必须坚持使用普通方法?
虽然 @property 能让调用看起来更干净,但滥用它会严重破坏代码的可预期性。在以下四种场景中,绝对不要使用 @property,必须使用普通方法:
1. 操作需要接收外部参数
@property 装饰的getter方法只能接受 self 参数。如果计算过程必须传入上下文或筛选条件(例如计算打折后的价格 calculate_discount(rate)),只能定义为普通方法。
2. 涉及高开销计算或 I/O 操作(数据库、网络、磁盘)
在所有程序员的潜意识中,通过点号访问属性 user.profile 应该是瞬间完成的(接近 O(1) 的轻量操作)。如果将一个涉及 HTTP 请求或复杂 SQL 聚合的逻辑包装成属性,调用者便可能无意间在循环中调用它,从而导致严重的性能灾难:
# 糟糕的设计:隐藏了极重的网络请求
class CloudServer:
    @property
    def cpu_load(self):
        # 错误示例:每次访问都发送网络请求甚至阻塞 500ms
        return requests.get("https://api.example.com/metrics/cpu").json()

# 正确做法:使用动词命名的方法,明确提示调用者这是有成本的操作
class CloudServer:
    def fetch_cpu_load(self) -> float:
        return requests.get("https://api.example.com/metrics/cpu").json()
3. 带有显著副作用或改变对象主要状态的操作
属性通常代表“名词”(状态),而方法代表“动词”(动作)。像 save()、publish()、clear_cache() 这类会永久修改存储或改变外部环境的操作,必须声明为方法。
五、工程决策推导流程
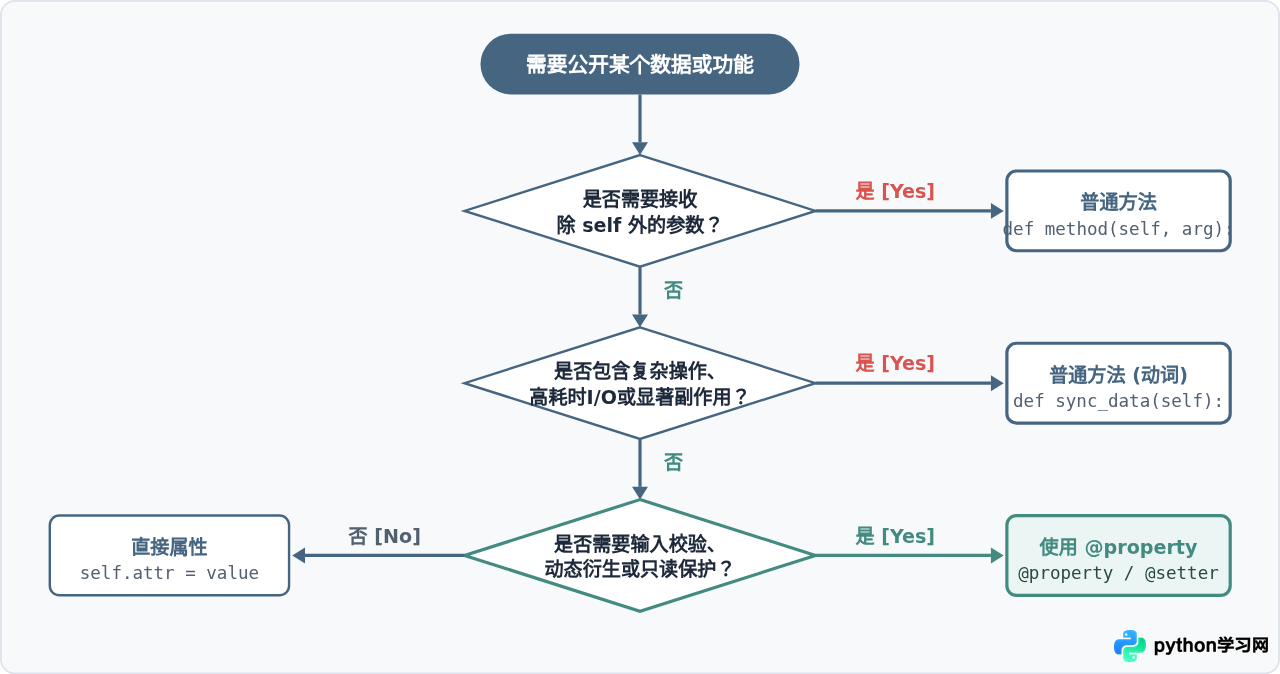
在日常代码编写中,遇到一个新特性或新字段的暴露时,可以依照以下决策流程图依次判断:
六、避免踩坑:@property 的常见陷阱
在编写 @property 时,有两处细节非常容易引发隐蔽的 Bug:
1. 属性名与底层私有变量重名引发无限递归(RecursionError)
定义 Setter 时,内部存储实际数据的变量必须加下划线前缀(如 self._value)。如果误写成了公开属性名 self.value = val,则会无限次再次调用自身 Setter,最终导致栈溢出:
class BadExample:
    def __init__(self, val):
        self.val = val

    @property
    def val(self):
        return self._val  # 注意:这里读取下划线私有变量

    @val.setter
    def val(self, new_val):
        # 严重错误示范:如果写成 self.val = new_val,会死循环触发本函数!
        # 正确写法:
        self._val = new_val
2. 忽略了 @functools.cached_property 的存在
如果动态计算逻辑没有入参、符合属性直觉,但需要消耗少量CPU(如统计一串长文本的词频哈希),每次通过 @property 读取都会重新计算一遍。此时可以使用标准库的 @functools.cached_property,只在首次访问时执行计算并缓存结果,后续访问直接返回,兼顾了属性语法与执行效率。
七、选型速查表与核心总结
为了便于在编码与代码评审中快速对照,我们可以将三者的关键考量维度总结如下:
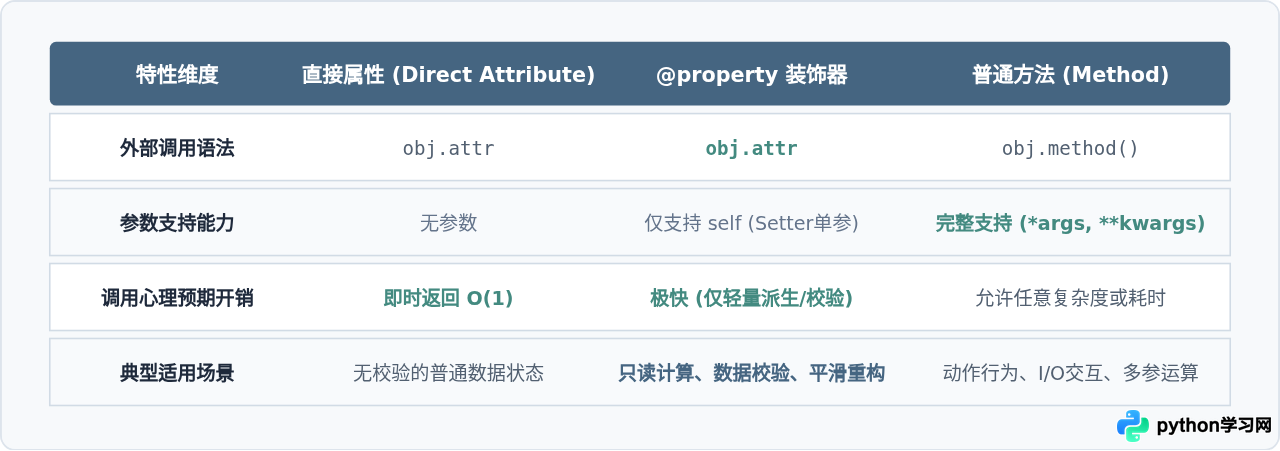
掌握直接属性、@property 与普通方法的取舍,本质上是在尊重 Python 的语言哲学:最开始保持最简单的直接属性,只在真正需要逻辑控制或数据保护时引入 @property,而在面对动作与高成本行为时显式声明为普通方法。这样设计出的类接口既优雅、符合直觉,又具备长期演进的弹性和稳健性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









