

Python函数定义与面向对象编程基础

编写高质量的 Python 程序,核心在于将散乱的操作逻辑整理为结构清晰、易于复用且符合问题本质的代码结构。函数关注的是“动作的抽象”,将输入经过明确步骤转化为输出;而面向对象编程关注的是“实体的建模”,将状态与操纵状态的行为紧密绑定。本文将从函数定义机制讲起,逐步推演到类的定义与面向对象设计,梳理两者在数据流转、内存组织与实际工程中的边界与配合。
一、Python 函数定义与核心运行机制
函数是 Python 中组织代码最直接的单元。通过 def 关键字,我们可以将一段具有独立功能的语句块包装起来,赋予其名称,并允许在程序各处按需调用。
1. 函数基本结构与执行阶段
在 Python 中,函数定义本身是一条可执行语句。当解释器运行到 def 行时,会在当前作用域中创建一个函数对象,并将函数名绑定到该对象上。此时函数体内的代码并没有立即执行,而是在调用时才会动态解析局部语句。
def calculate_tax(income, tax_rate=0.1):
    """根据收入与税率计算应纳税额"""
    if income <= 0:
        return 0.0
    return round(income * tax_rate, 2)

# 示例调用
payable = calculate_tax(12000, 0.15)
print(f"应缴税款:{payable}")  # 示例输出:应缴税款:1800.0
函数通过 return 语句将结果传递给外部调用者。如果函数内部执行完毕没有遇到显式 return,或者单独执行 return 而未带任何表达式,Python 都会隐式返回 None。
2. 形参解构与实参传递规则
Python 函数的参数体系非常灵活,按定义顺序通常包含以下几类:
- 位置参数(Positional Arguments):调用时必须按照定义位置依次传参。
- 默认参数(Default Arguments):为参数设定默认值,调用时未传该参数则采用默认值。注意:默认参数必须放在非默认参数之后。
- 可变位置参数(*args):将多余的位置参数打包为一个元组(tuple)。
- 可变关键字参数(**kwargs):将多余的键值对参数打包为一个字典(dict)。
def register_user(username, role="member", *hobbies, **metadata):
    return {
        "username": username,
        "role": role,
        "hobbies": hobbies,
        "metadata": metadata
    }

# 示例调用
user_info = register_user("Alice", "admin", "coding", "reading", city="Beijing", level=3)
# 示例结果中 hobbies 为 ("coding", "reading"),metadata 为 {"city": "Beijing", "level": 3}Python 函数的默认参数在定义阶段仅计算并创建一次,而不是每次调用时重新生成。若使用列表、字典等可变对象作为默认值,后续调用修改该对象将导致所有调用共享同一引用。严谨写法应使用
arg=None,并在函数内部判断若为 None 则新建对象。
3. 变量作用域与 LEGB 查找链
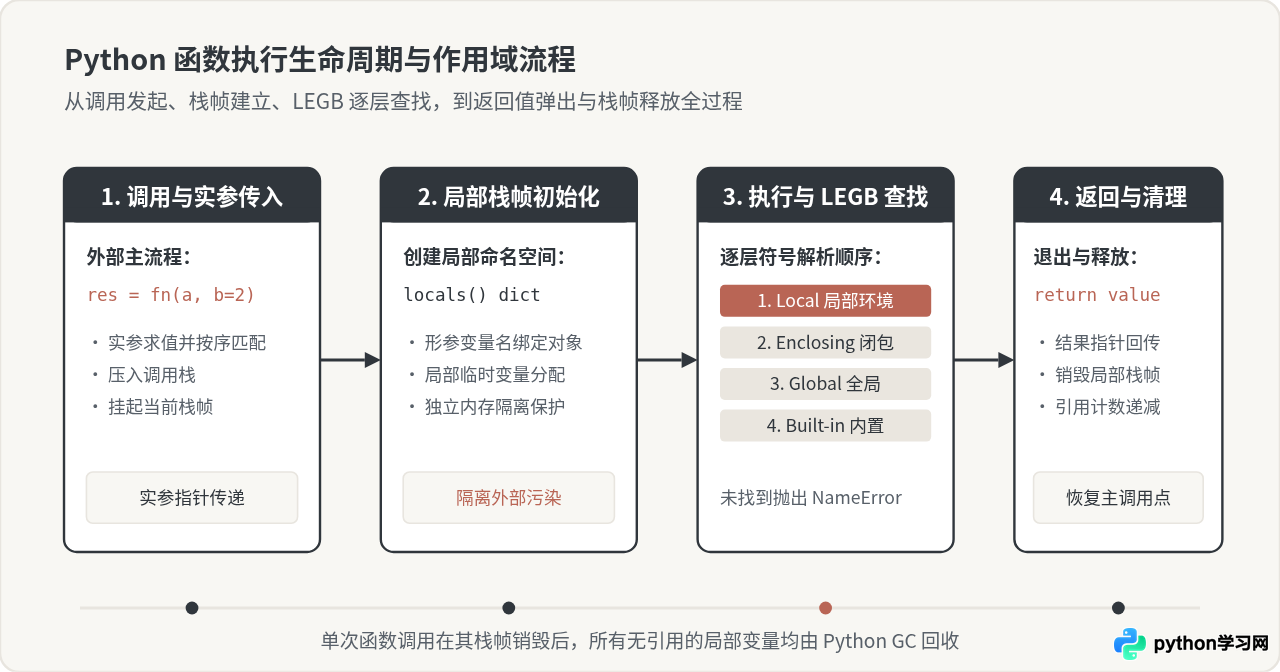
当函数被调用时,Python 会为该次调用分配一个独立的活动栈帧,生成专属于该函数的局部命名空间。变量的查找严格遵循 LEGB 规则:
- L(Local):当前函数内部定义的局部变量。
- E(Enclosing):外层嵌套函数的局部作用域(闭包环境)。
- G(Global):当前模块文件顶层定义的全局变量。
- B(Built-in):Python 内置命名空间(如
len、range、print等)。
二、从函数到面向对象:思维范式的跃迁
当业务逻辑变得复杂、数据状态越来越多时,仅依赖独立函数和散装数据结构(如字典或元组)会出现明显的组织瓶颈:
- 数据与行为割裂:数据存在字典里,操作数据的函数分散在文件各处。一旦数据字典的某个字段名变更,所有相关的外部函数都需要同步修改。
- 状态一致性难以保证:任何外部代码都能直接篡改字典中的键值,缺乏统一的校验与约束入口。
- 代码复用受限:若需要为不同类型的实体提供相似操作,单纯写函数往往只能通过层层
if-else分支判断类型,造成逻辑臃肿。
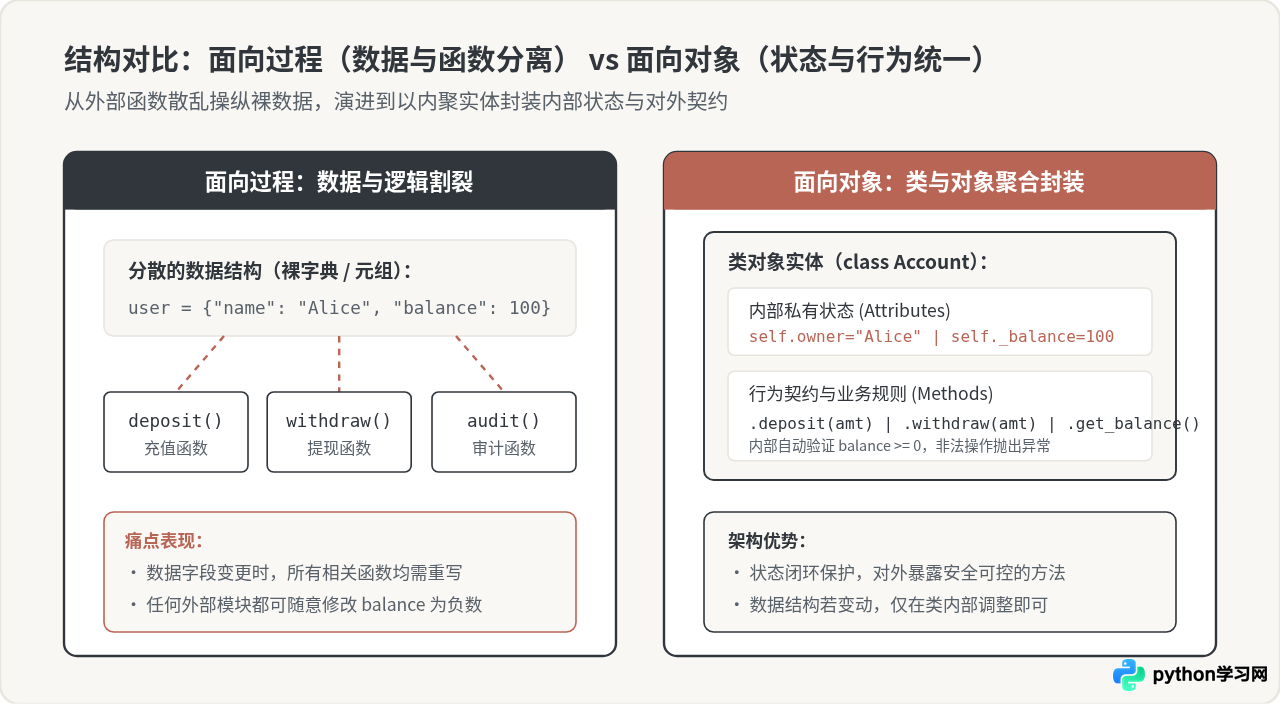
面向对象编程并不排斥函数。相反,对象的方法实质上就是绑定了特定实例状态的函数。理解这种演进关系,能让我们在面对不同场景时,做出恰当的抽象选择。
三、面向对象编程核心基础语法
在 Python 中,“一切皆对象”,类(Class)本身也是运行时的对象。我们通过 class 关键字定义模板,再通过调用类来生成具体的实例(Instance)。
1. 类的定义与 __init__ 构造方法
定义类时,最核心的特殊方法是 __init__。它在实例被创建后立即被自动调用,用于完成属性的初始化赋值。
class BankAccount:
    # 类属性(所有实例共享)
    bank_name = "开放金融银行"

    def __init__(self, owner, initial_balance=0.0):
        # 实例属性(每个实例独有)
        self.owner = owner
        self.balance = float(initial_balance)

    def deposit(self, amount):
        if amount <= 0:
            raise ValueError("存款金额必须大于零")
        self.balance += amount
        return self.balance

    def withdraw(self, amount):
        if amount > self.balance:
            raise ValueError("账户余额不足")
        self.balance -= amount
        return self.balance

# 实例化对象
acc1 = BankAccount("张三", 1000.0)
acc2 = BankAccount("李四", 500.0)

acc1.deposit(200)
print(f"{acc1.owner} 当前余额:{acc1.balance}")  # 示例输出:张三 当前余额:1200.0
print(f"{acc2.owner} 所在银行:{acc2.bank_name}")  # 示例输出:李四 所在银行:开放金融银行
2. 解密 self 参数的本质
初学者常常困惑:为什么定义方法时必须显式写出 self,而调用时却不需要传入?
在底层机制中,类中定义的常规方法只是普通的函数对象。当通过实例发起调用(如 acc1.deposit(200))时,Python 的描述符机制会将方法转化为绑定方法(Bound Method),自动将当前实例对象作为第一个参数传入给 self。
也就是说,以下两行代码在 Python 解释器内部是完全等价的:
# 语法糖调用方式
acc1.deposit(200)

# 底层真实执行方式:直接通过类调用函数,显式传递实例对象
BankAccount.deposit(acc1, 200)
3. 类属性 vs 实例属性与查找链
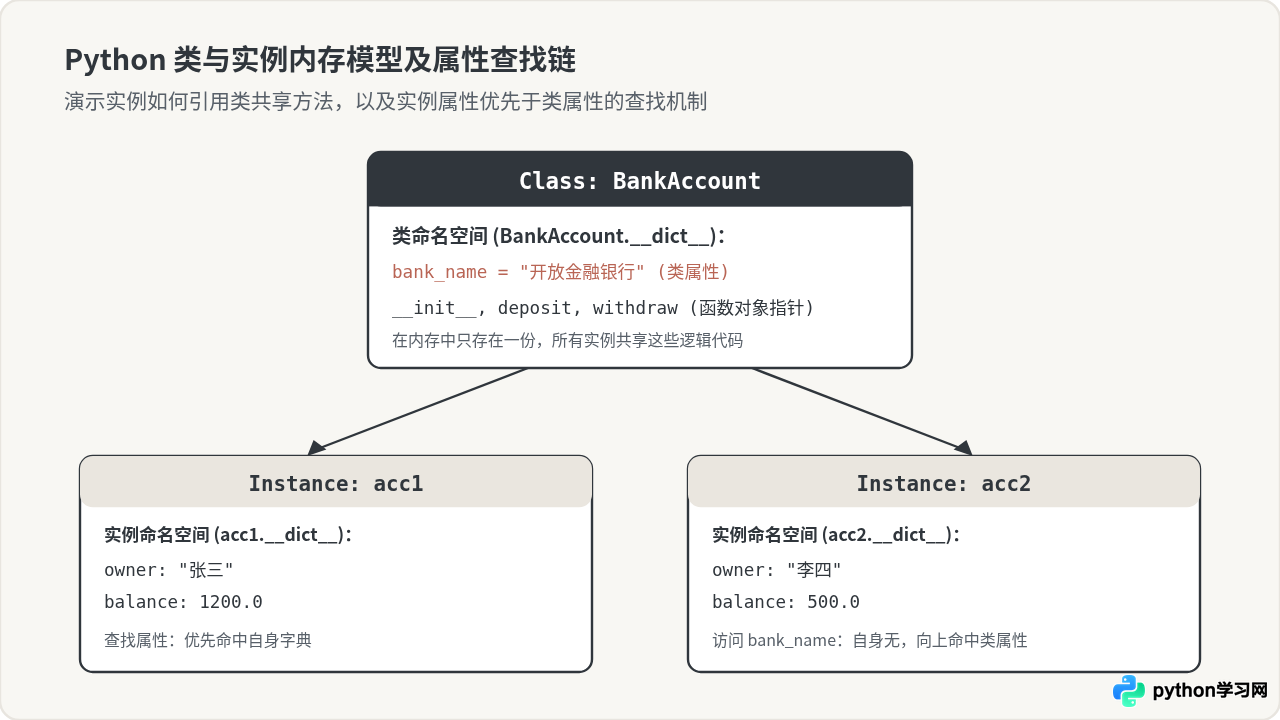
理解属性的存储位置至关重要:
- 实例属性:存储在每个实例独立的
__dict__字典中。 - 类属性:存储在类对象的
__dict__字典中,被该类派生出的所有实例共享。 - 查找顺序:当访问
instance.attr时,Python 先在实例自身__dict__中查找;若未找到,再去类对象及其父类的继承树中查找。若通过instance.attr = value赋值,则永远只会在实例自身的__dict__中写入,不会影响类属性。
四、面向对象三大核心特征在 Python 中的实践
1. 封装(Encapsulation):约定与属性保护
许多静态语言提供 private、protected 等访问控制关键字,但 Python 秉持“我们都是成年人(We are all consenting adults here)”的哲学。Python 的封装主要基于命名约定和机制控制:
- 单下划线前缀(如
_balance):一种开发者间的约定,表明该属性仅供类内部或子类使用,外部调用不应直接修改。 - 双下划线前缀(如
__secret):触发名称改写(Name Mangling),解释器会自动改名为_ClassName__secret,防止子类意外覆写。 @property装饰器:将方法包装成属性访问,实现对外部读取与设值的拦截校验。
class SecuredAccount:
    def __init__(self, owner, balance):
        self.owner = owner
        self._balance = float(balance)

    @property
    def balance(self):
        """只读或受控读取属性"""
        return self._balance

    @balance.setter
    def balance(self, value):
        """设值拦截与业务规则约束"""
        if value < 0:
            raise ValueError("账户余额不可为负数")
        self._balance = value

# 使用演示
account = SecuredAccount("王五", 300)
print(account.balance)  # 像属性一样读取,输出 300.0
# account.balance = -50  # 抛出 ValueError: 账户余额不可为负数
2. 继承(Inheritance)与方法覆写
继承允许子类派生自父类,自动继承父类的属性与方法,并可根据自身特性进行定制或重写(Override)。通过 super(),子类可以在覆写父类方法的同时安全地复用父类的基础逻辑。
class SavingsAccount(BankAccount):
    def __init__(self, owner, balance=0.0, interest_rate=0.03):
        # 调用父类构造逻辑
        super().__init__(owner, balance)
        self.interest_rate = interest_rate

    def apply_interest(self):
        """子类特有行为:计息结算"""
        interest = self.balance * self.interest_rate
        self.balance += interest
        return self.balance

# 储蓄账户使用
sa = SavingsAccount("赵六", 10000.0, 0.05)
sa.deposit(2000)  # 继承自父类
sa.apply_interest()  # 子类扩展方法
print(f"计息后总额:{sa.balance}")  # 示例输出:计息后总额:12600.0
3. 多态与鸭子类型(Duck Typing)
在传统的静态类型语言中,多态通常需要严格的接口(Interface)或抽象类定义。而在 Python 中,多态体现为“鸭子类型”:“如果它走起来像鸭子,叫起来像鸭子,那它就是鸭子”。
在编写函数时,我们关注的是传入对象是否具备所要求的方法,而不是它是否继承自某个特定的基类。
class WechatPay:
    def pay(self, amount):
        return f"微信支付结算:{amount} 元"

class AliPay:
    def pay(self, amount):
        return f"支付宝支付结算:{amount} 元"

# 统一结算网关:仅依赖传入对象是否具有 .pay() 方法
def process_order_checkout(payment_gateway, amount):
    result = payment_gateway.pay(amount)
    print(f"订单处理成功 -> {result}")

process_order_checkout(WechatPay(), 199)
process_order_checkout(AliPay(), 299)
五、工程决策:何时写函数,何时设计类?
掌握了函数与面向对象之后,许多开发者面临的最实际问题就是:在实际项目中,面对一个需求,究竟应该写成几个独立函数,还是定义一个类?
| 考量维度 | 优先选择「独立函数」 | 优先设计「类与对象」 |
|---|---|---|
| 状态生命周期 | 无状态或短期转换:数据输入、计算、输出后即可丢弃。 | 需要长期维护内部状态,且该状态在多次操作间持续变化。 |
| 代码职责 | 数学运算、格式清洗、特定步骤转换等单一功能。 | 现实实体建模(如用户、订单、连接池、游戏角色)。 |
| 复用与扩展 | 模块级工具箱(如 utils.py 中的辅助算法)。 |
需要利用继承、多态或组合来支持后续功能扩展。 |
| 复杂性代价 | 轻量直接,易于单测,无额外心智负担。 | 增加抽象层次与实例化开销,需设计良好的对外契约。 |
总结
函数与面向对象不是非此即彼的对立关系,而是 Python 开发者工具箱中互相配合的两个层级。函数以其轻量、纯粹和无副作用的特性,承担了具体业务计算与流水线处理的基础任务;面向对象则通过对状态与行为的严谨封装,承担了复杂系统架构和实体关系的建模职责。在编写 Python 代码时,不滥用过于复杂的类继承,也不把大段需要维护状态的逻辑散落在零碎函数中,根据数据状态的生命周期做出合理选择,是写出优雅、健壮 Python 代码的关键所在。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









