

Python自学路线图:从基础语法到高级特性的分阶段学习指南

自学 Python 最常见的困境并不是缺少学习资源,而是在繁杂的语法细节中迷失方向,长久停留在“看得懂示例却写不出程序”的被动状态。建立扎实编程能力的关键,是将整门语言的学习划分为四个层级分明、目标具体的阶段:基础语法与核心逻辑、面向对象与模块化设计、高级特性与惯用法、工程化交付与生态实践。本文针对每一个阶段明确指出核心掌握内容、代码思维的转变节点、易错陷阱与阶段性验收标准,帮助自学者建立系统而清晰的编程能力成长闭环。
一、学习路径全景设计:四个阶段的定位与核心任务
初学者自学 Python 时,常常把“看完一本厚教材”或“刷完一套视频”作为目标,这种线性堆砌知识的方式往往忽略了编程能力的阶段性分水岭。如果一开始就尝试理解元类、装饰器内部原理或异步并发,容易产生挫败感;而如果始终停留在基本类型的算术运算和简单判断上,又无法跨过从“脚本编写者”到“软件设计者”的门槛。
合理的自学路径应当像搭建金字塔一样,上一阶段的思维模型为下一阶段的技术抽象提供坚实支撑。下图梳理了从零基础入门到能够独立完成规范工程开发的四个演进阶段及其核心技术栈分布。
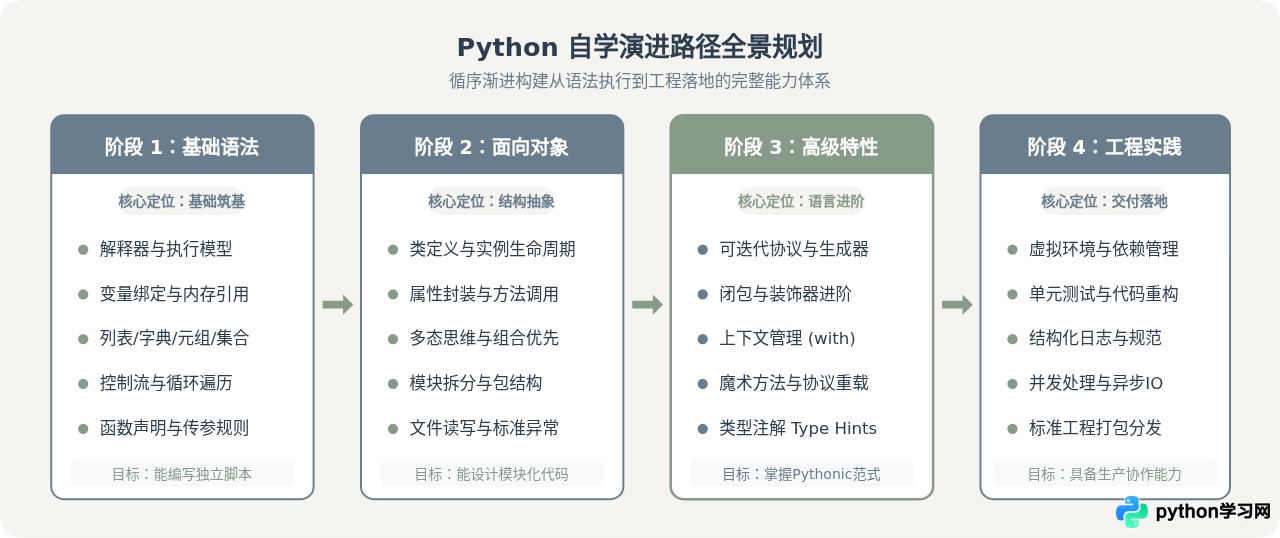
二、第一阶段:基础语法与核心内建机制
学习 Python 的第一步并非死记硬背语法糖,而是理解 Python 解释器的工作方式以及核心数据结构的物理特性。Python 属于强类型动态语言,变量本身没有类型,它只是指向具体内存对象的引用标签。
1. 环境与执行模型认知
初学者应当直接采用官方最新长期稳定版本的 CPython 解释器,在终端中通过 python -m venv .venv 创建隔离环境,而非直接修改系统全局 Python。通过理解 .py 脚本被编译为字节码(.pyc)并由虚拟机执行的过程,可以消除对“脚本语言就是按行纯文本解释”的误解。
2. 核心数据类型与内存模型差异
初学者极易在这个阶段遭遇“修改局部变量却意外改变了原始数据”的 Bug。其根源在于没有清晰分辨“可变对象(Mutable)”与“不可变对象(Immutable)”:
- 不可变对象:
int、float、str、tuple、frozenset。对不可变对象进行修改,实质上是创建了全新对象并重新绑定变量引用。 - 可变对象:
list、dict、set。变量内部持有的对象可以通过就地(In-place)方法进行修改,所有指向该对象的引用都会同步感知变化。
# 演示不可变与可变对象的引用行为差异
a = 100
b = a
b += 1
print(f"a: {a}, b: {b}")  # 输出示例:a: 100, b: 101(a 未受影响)

list_x = [1, 2, 3]
list_y = list_x
list_y.append(4)
print(f"list_x: {list_x}")  # 输出示例:list_x: [1, 2, 3, 4](list_x 随之改变)
3. 函数与参数传递边界
在 Python 中,所有参数传递均为“对象引用的值传递(Pass by Assignment)”。函数的默认参数是在函数定义阶段被求值并创建的,因此绝不能使用可变对象作为函数默认参数:
# 错误示例:默认参数共享导致状态污染
def append_item_bad(val, target=[]):
    target.append(val)
    return target

# 正确示例:使用 None 并在函数体内动态初始化
def append_item_good(val, target=None):
    if target is None:
        target = []
    target.append(val)
return target能够不借助 AI 和教程,熟练使用字典、列表、集合完成文本分词统计或数据归类脚本;能清晰解释赋值、浅拷贝(copy)与深拷贝(deepcopy)的区别,并在函数中正确使用 *args 和 **kwargs。
三、第二阶段:面向对象编程与代码组织抽象
当编写的代码超过几百行时,单纯依靠函数和全局变量会使逻辑纠缠不清。面向对象编程(OOP)的核心并不是为了刻意写出 class 关键字,而是为了实现状态(属性)与行为(方法)的高内聚,控制复杂度的蔓延。
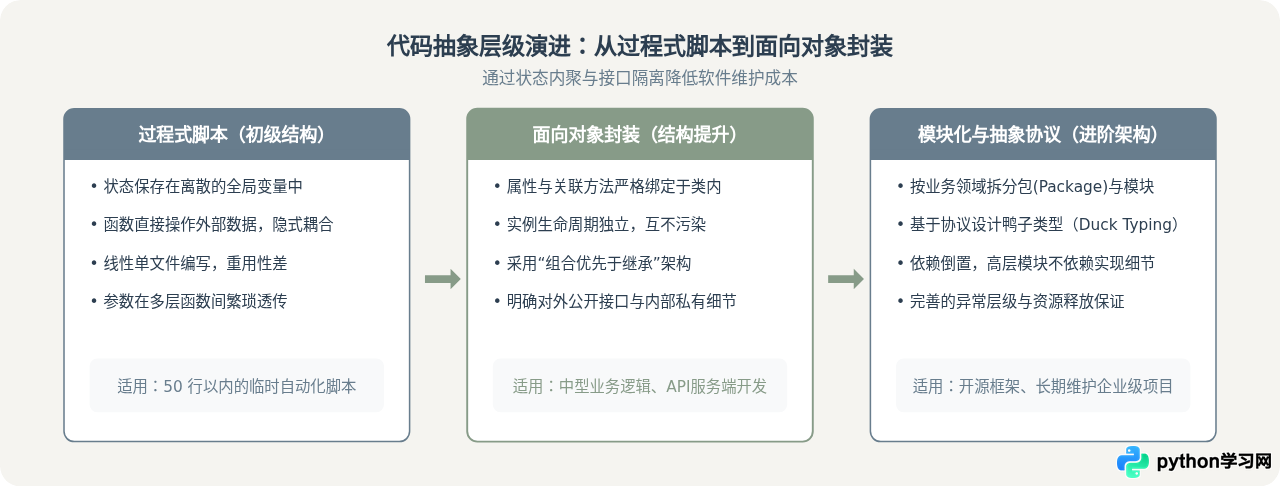
下图展示了从基础阶段的过程式脚本向模块化面向对象结构演进的过程。通过将分散的全局变量和零散函数归入具有明确职责边界的类与模块,代码的可读性与重构安全性得到了根本提升。
1. 属性与行为的封装范式
在 Python 中,不需要为了封装而盲目编写 Java 风格的 get_x() 和 set_x()。Python 提供了原生的 @property 装饰器,使代码既能保持属性访问的简洁直观,又能随时加入校验逻辑:
class BankAccount:
    def __init__(self, owner: str, balance: float = 0.0):
        self.owner = owner
        self._balance = balance  # 单下划线前缀约定为受保护属性

    @property
    def balance(self) -> float:
        return self._balance

    def deposit(self, amount: float) -> None:
        if amount <= 0:
            raise ValueError("存款金额必须大于零")
        self._balance += amount

    def withdraw(self, amount: float) -> None:
        if amount > self._balance:
            raise ValueError("账户余额不足")
        self._balance -= amount
2. 继承与组合的设计权衡
很多初学者容易滥用类的继承,构建出超过三层的复杂继承树,导致子类与父类产生脆弱的紧密绑定。在实际设计中,应恪守“组合优先于继承(Favor composition over inheritance)”原则。除非子类与父类是严苛的“IS-A”关系,否则通过将功能类作为属性注入到主对象中,往往具有更好的灵活性。
能够根据实际业务需求(例如一个简易图书管理系统或网络爬虫抓取器),抽象出 3 到 5 个职责明确的类;规范组织 __init__.py 形成多层级包结构,并能合理捕获与抛出特定的标准异常。
四、第三阶段:深入 Python 高级特性与 Pythonic 惯用法
迈入第三阶段,自学者将直面 Python 最精妙、最具表现力的语言特性。掌握这一阶段的技术,是将“用写 C 或 Java 的思路套用 Python 语法”转变为“写出真正原汁原味的 Pythonic 代码”的核心标志。
1. 核心深度对比:列表推导式 vs 生成器表达式
列表推导式(List Comprehension)与生成器表达式(Generator Expression)在语法结构上极其相似,仅有一对括号的区别(方括号 [] 与圆括号 ()),但在执行机制和底层内存分配上有着本质的不同:
- 列表推导式(及早求值,Eager Evaluation):在执行瞬间立即开辟一块连续内存空间,完整计算出所有元素并存储在内存中。
- 生成器表达式(惰性求值,Lazy Evaluation):不预先计算任何数据,仅返回一个遵守迭代器协议的生成器对象。只有在调用
next()或处于循环遍历中时,才会实时计算并产出一个元素。
通过下方真实代码可以直观验证两者的内存差距:
import sys

# 处理 100 万个整数的平方
data_range = range(1000000)

# 列表推导式:立即生成完整列表
list_comp = [x * 2 for x in data_range]
print(f"列表推导式内存占用: {sys.getsizeof(list_comp)} 字节")  # 示例输出:约 8448728 字节 (8.4MB)

# 生成器表达式:仅生成迭代器对象
gen_exp = (x * 2 for x in data_range)
print(f"生成器表达式内存占用: {sys.getsizeof(gen_exp)} 字节") # 示例输出:约 112 字节为什么这个差异至关重要?在生产环境中处理大体积文件(如几十 GB 的日志)时,如果使用列表推导式,程序会瞬间耗尽物理内存导致崩溃;而使用生成器可以将处理过程连接成流水线,内存始终保持在几十 KB 的常数级别。
2. 闭包与装饰器(Decorator)
在 Python 中,函数是一等公民(First-class citizen),可以作为参数传递,也可以作为返回值返回。装饰器利用了闭包(Closure)机制,能够在不修改原始函数定义的前提下,为函数动态注入日志记录、耗时统计、权限校验或重试等切面逻辑。
import time
from functools import wraps

def time_logger(func):
    """带参数保真的通用执行耗时统计装饰器"""
    @wraps(func)  # 保留原始函数的元数据(__name__, __doc__等)
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start_time
        print(f"函数 [{func.__name__}] 执行耗时: {duration:.4f} 秒")
        return result
    return wrapper

@time_logger
def compute_heavy_task(n: int) -> int:
    return sum(i * i for i in range(n))
3. 上下文管理器与魔术方法
Python 通过双下划线方法(Dunder Methods)定义对象的行为协议:
__enter__和__exit__:驱动with上下文管理器,无论是否发生异常均能保证系统资源(文件句柄、网络连接、数据库事务)可靠释放。__iter__和__next__:驱动for...in循环,使自定义对象无缝融入 Python 迭代体系。__repr__和__str__:提供开发调试时清晰的对象信息表述。
能够熟练编写带参数的装饰器;能够使用生成器实现多阶段数据管道;能够为自定义类实现上下文管理器或通过 contextlib.contextmanager 优雅封装资源生命周期。
五、第四阶段:工程化交付与生态实践
许多自学者在独立编写百行代码时表现良好,但一旦参与实际团队项目或尝试发布模块,便遇到各种环境冲突、测试缺失和打包失败问题。第四阶段的任务,是将“个人脚本代码”提升为符合“工业级软件交付规范”的成熟工程。
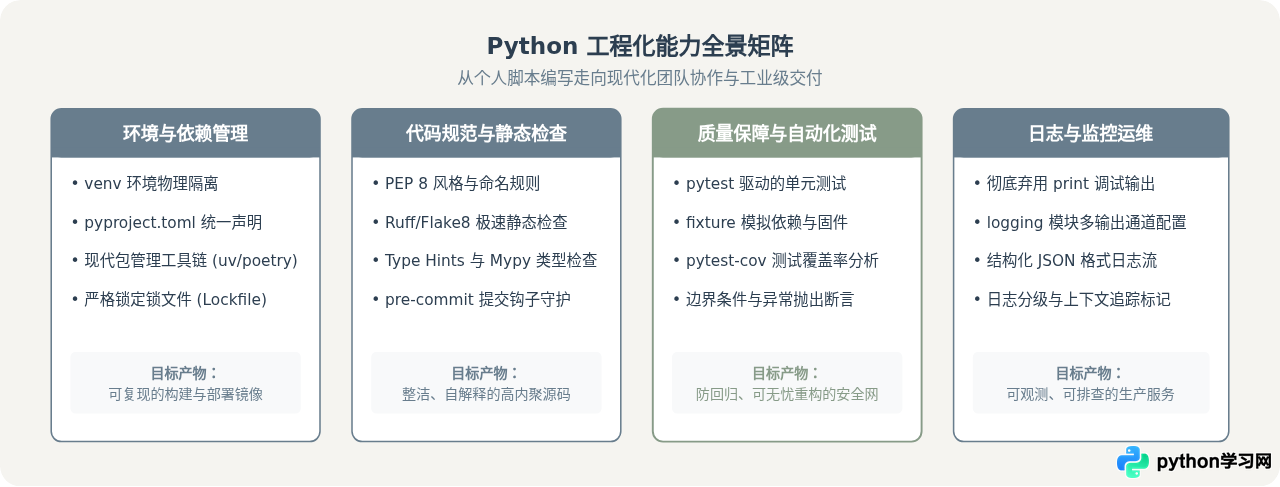
1. 现代化项目组织结构
一个标准的 Python 项目应当具备清晰的目录层次,隔离源码、测试用例与环境配置文件:
my_project/
├── src/
│   └── my_package/
│       ├── __init__.py
│       ├── core.py
│       └── utils.py
├── tests/
│   ├── __init__.py
│   └── test_core.py
├── .gitignore
├── pyproject.toml
└── README.md
2. 编写 pytest 自动化测试
在工程化阶段,任何业务函数都应有对应的自动化测试。pytest 依靠原生的 assert 断言机制,编写极为简洁:
# tests/test_core.py
import pytest
from my_package.core import BankAccount

def test_account_deposit():
    account = BankAccount(owner="Alice", balance=100.0)
    account.deposit(50.0)
    assert account.balance == 150.0

def test_account_withdraw_insufficient_funds():
    account = BankAccount(owner="Bob", balance=30.0)
    with pytest.raises(ValueError, match="账户余额不足"):
        account.withdraw(50.0)
3. 使用 logging 替代 print 输出
print() 无法控制日志级别、输出目标与格式,且在高并发下存在 I/O 阻塞。标准库的 logging 模块提供了生产级别的日志追踪体系:
import logging

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(name)s (%(filename)s:%(lineno)d): %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)
logger = logging.getLogger(__name__)

logger.info("系统初始化完成,开始处理任务")
logger.warning("外部服务响应延迟偏高: 320ms")能够使用 pyproject.toml 配置项目,依赖管理清晰;运行 pytest 时测试用例能够 100% 自动化通过;能够通过 mypy 检查所有公共接口的类型注解,且代码符合规范。
六、自学实践策略与避坑指南
掌握路线图之后,如何安排日常的自学节奏同样决定了最终的学习效率。以下是经过大量自学实践总结的核心建议:
| 常见误区 | 不良后果 | 推荐改进做法 |
|---|---|---|
| 囤积教程而不动手 | 产生“掌握了知识”的虚假认知,脱离视频后无法独立敲出有效代码。 | 遵循“看半小时,写一小时”原则。每学一个特性,立即在交互式终端或本地测试脚本中验证。 |
| 过早陷入海量第三方库 | 直接学习复杂的 Web 框架或深度学习框架,因基础薄弱无法理解框架背后的魔法机制。 | 在第一至第三阶段专注于 Python 标准库(如 pathlib、itertools、collections、functools)。 |
| 忽视 Traceback 报错提示 | 遇到报错直接复制粘贴上网搜索,缺乏从异常信息中定位代码缺陷的能力。 | 从下往上阅读报错调用栈,观察最后一行的异常类型与描述,定位自己的代码文件行号。 |
| 写代码不设版本控制 | 文件命名为 main_v1.py、main_final.py,代码改乱后无法安全回退。 |
从写第一行代码开始使用 Git 进行版本管理,养成小步提交并撰写有意义 Commit 的习惯。 |
Python 的自学过程不是一蹴而就的冲刺,而是一个由直观到抽象、由零散到工程化的系统认知进阶。按照上述四个阶段稳扎稳打,并在每个阶段通过实际代码和单元测试验证自己的掌握边界,自学者便能建立起扎实且具备长期扩展性的现代 Python 编程能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









