

数据分析师为什么首选Jupyter作为Python编程工具?
深入解析数据分析师为何普遍选择Jupyter作为Python主力编程工具,从交互式分块执行、内存驻留机制到工作流对比与工程边界,提供详尽分析。
数据分析工作的本质不是构建长时间无人值守的自动化系统,而是一场面向未知的“假设提出与即时验证”。数据分析师之所以普遍首选Jupyter(包含Jupyter Notebook与JupyterLab)作为主力Python工具,根本原因在于其独有的“单元格(Cell)分块执行、内存变量持久驻留、计算与图文结果即时内联呈现”机制,它将传统脚本编写中冗长的“修改-全量执行-等待报错-重跑”闭环缩短为秒级的渐进探索,契合了探索性数据分析(EDA)对敏捷试错的核心需求。
一、执行机制差异:内存常驻与冷启动的本质区别
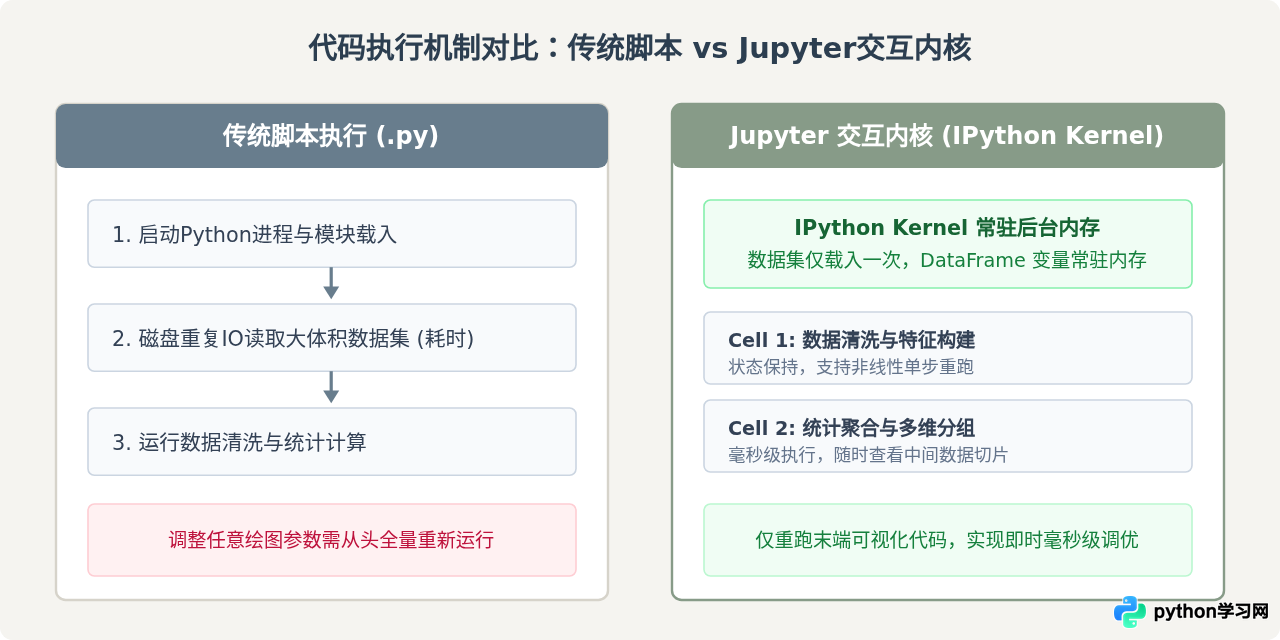
要理解Jupyter的不可替代性,首先需要对比传统.py脚本执行模式与Jupyter交互内核(IPython Kernel)的工作差异。在传统的Python集成开发环境(如VS Code或PyCharm纯脚本模式)中,每次点击“运行”,Python解释器都会经历完整的生命周期:启动进程、逐行加载依赖库、从磁盘读取原始数据、执行计算并退出进程。
当分析任务涉及GB级别的销售流水或数千万条用户日志时,仅从硬盘读取文件并将其转换为Pandas数据帧(DataFrame)就可能耗费数十秒甚至数分钟。如果分析师只是想修改图表的柱状图颜色、调整分组聚合的求和列,传统脚本模式必须从头再读一遍数据,这会严重打断分析思考节奏。
Jupyter则将“执行状态”与“代码编辑”彻底解耦。后端的IPython Kernel常驻于后台,所有已载入的数据帧、计算结果和自定义函数都安全地保留在系统内存中。分析师可以在前面的单元格中加载数据,在后续单元格中自由编写过滤、统计或绘图逻辑。即便后方代码出现拼写错误或异常,前面的内存状态丝毫不受影响,修正后只需重新执行当前单元格即可在几十毫秒内得到反馈。
二、探索性数据分析(EDA)的标准工作流
数据分析工作并非线性的流水线,而是一个充满假设、检验、否定和微调的闭环。以一个电商用户订单分析为例,分析师的操作过程通常分为四个连续阶段:
- 快速读取与架构嗅探:载入数据后,使用
df.info()和df.head()直接在代码框下方渲染出表格,核对字段类型与缺失值分布。 - 分块清洗与单点验证:将缺失值插补、时间字段解析拆分在不同单元格中,每步执行完即可通过
assert或简单的切片输出校验清洗效果。 - 假设施策与多维透视:对用户行为进行分群分组统计,频繁调整分组维度(如按月、按地区或按品类)。
- 内联可视化与洞察记录:利用Matplotlib或Seaborn绘制趋势图,图表直接锚定在代码下方,并在下方紧随Markdown单元格书写业务解读。
以下代码片段展示了一个典型Jupyter单元格的极简工作片段。分析师只需在一个单元格中执行聚合,即刻看到规整的HTML表格渲染:
import pandas as pd
import matplotlib.pyplot as plt

# 假设原始数据已经在前序单元格载入内存 df_orders
# 当前单元格仅专注进行按月销售额聚合与可视化探索
monthly_sales = df_orders.groupby('order_month')['payment_amount'].sum().reset_index()

# 单元格末尾直接书写变量名,Jupyter自动将其渲染为富文本HTML表格
monthly_sales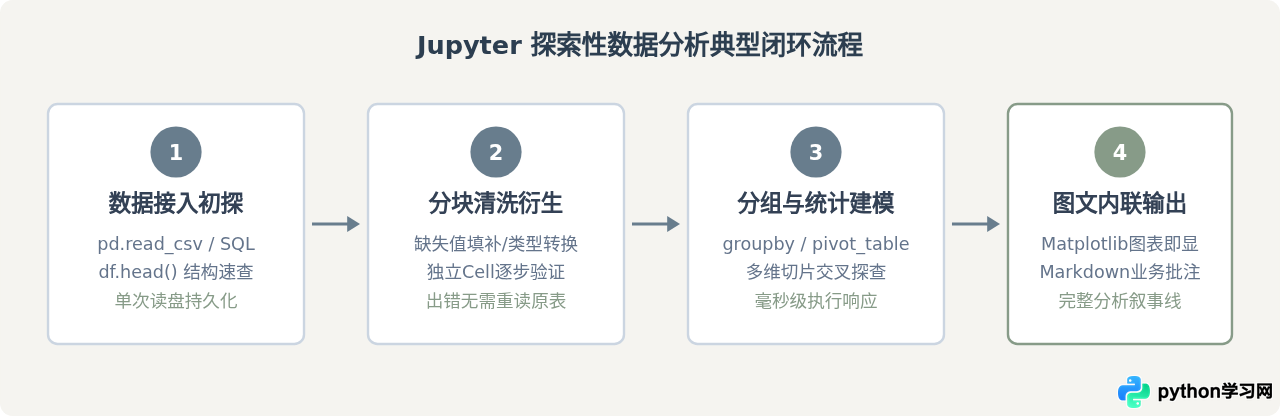
三、计算型文档:代码、输出与业务洞察的一体化混排
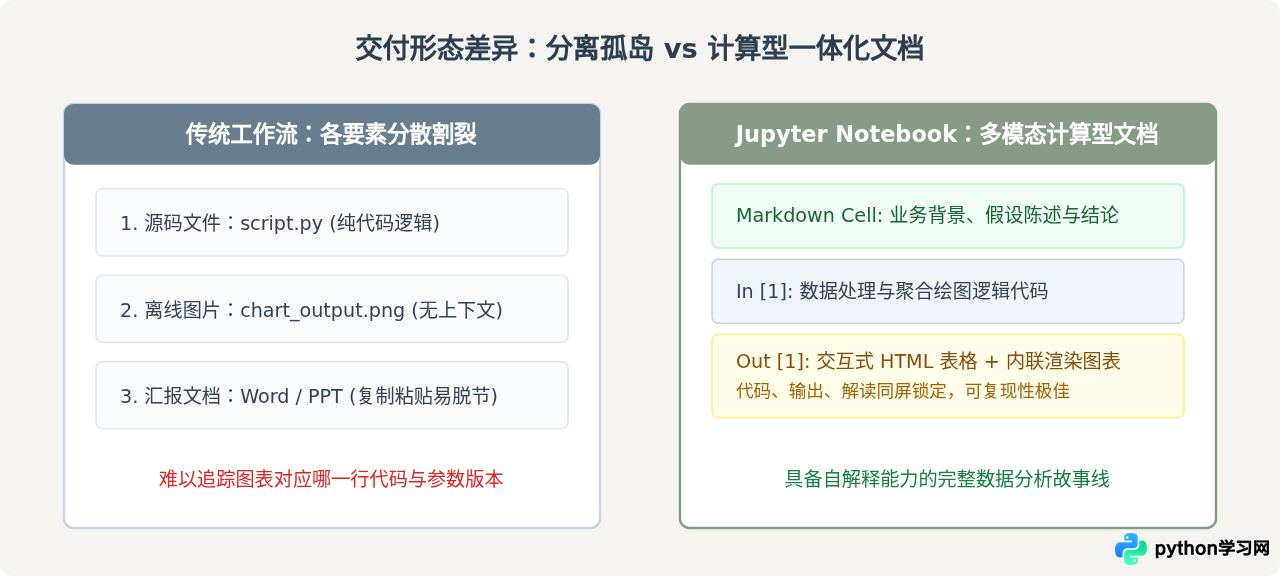
软件工程师的核心产物通常是可执行的二进制包、库或者API服务,因此纯文本代码文件(如.py或.java)是最纯粹的形式。然而,数据分析师的核心交付物是“业务洞察报告”。
如果使用传统IDE,代码保存在analysis.py中,生成的图表弹出一个临时GUI窗口或者保存到单独的figure.png,而关于图表反映出“第三季度销售额环比下滑12%”的业务解读,则必须记录在Word文档或聊天工具中。这种“计算、图表、结论”三者剥离的状态,带来了巨大的沟通与维护成本。
Jupyter Notebook从根本上实现了“计算型文档(Computational Document)”。一个.ipynb文件内同时并存三项元素:
- 逻辑源文件:清晰保留数据提取与清洗的每一步Python代码。
- 执行产物:紧随代码框展示的图表、表格与汇总指标,完全复原当时的数据现场。
- 富文本叙述:利用Markdown单元格插入标题、公式、文字说明、业务结论与行动建议。
四、工具边界与工程定位:何时不该使用Jupyter?
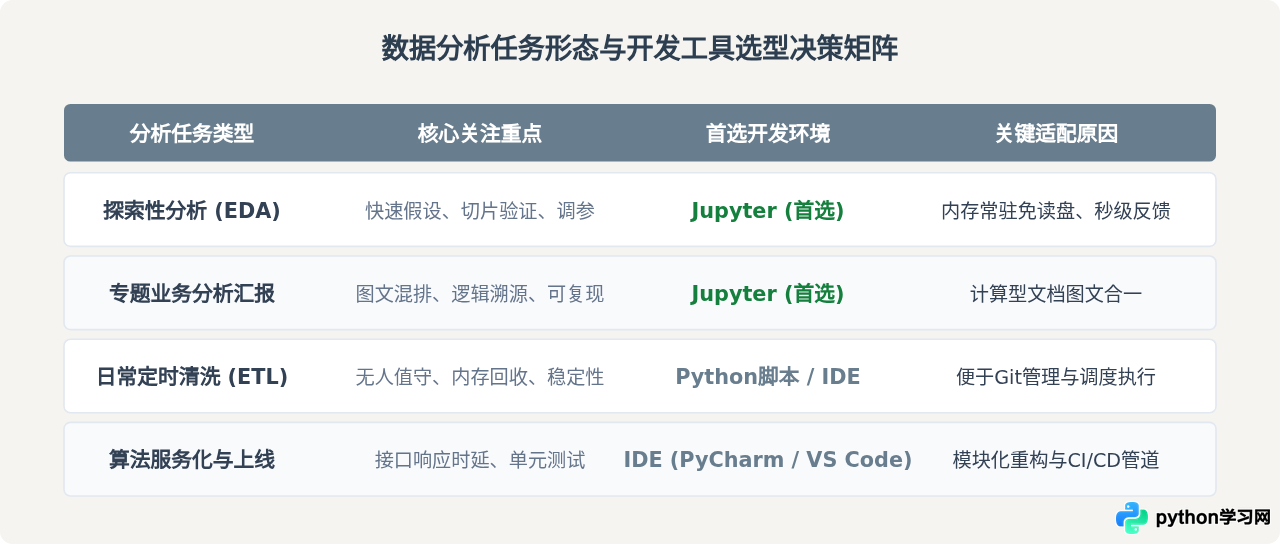
尽管Jupyter在探索分析与快速验证环节具有压倒性优势,但成熟的数据分析师必须清晰理解其边界,避免误将其作为全场景工程工具:
- 代码乱序执行(Out-of-order Execution)陷阱:Jupyter允许用户任意跳跃执行单元格。如果在Cell 3中修改了全局变量,再回过头运行Cell 1,可能导致整个Notebook的上下文处于不可预知的非确定状态。团队协作时,必须养成在交付前点击“Restart Kernel & Run All Cells”检验完整线性流程的习惯。
- Git版本控制难题:
.ipynb文件底层是复杂的JSON格式,包含了图表的Base64转码与元数据。直接进行Git diff对比时会产生海量无效冲突,增加团队代码审查(Code Review)负担。 - 生产自动化流水线:对于每天凌晨定时触发的ETL抽取、在线推荐打分或微服务部署,标准的工程化
.py模块结合调度工具(如Airflow)在稳定性、测试覆盖率和内存回收方面远优于Jupyter。
.py模块。
总结
数据分析师首选Jupyter,是因为它在人脑思考节奏与计算机执行反馈之间建立了最短的交互路径。通过后台内核保持内存状态,分析师免去了大体积数据重复加载的冷启动等待;通过分块执行单元,分析师能够从容进行局部验证与假设推演;通过计算型文档的多模态集成,分析师交付的不再是一堆冰冷孤立的代码文件,而是一份具备自解释能力、可复现、图文并茂的数据洞察成果。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









