

Python异步爬虫高性能实现:aiohttp与asyncio并发采集教程
深入讲解如何基于Python的asyncio事件循环与aiohttp客户端构建生产级高性能异步爬虫,涵盖连接池复用、Semaphore并发限流、超时控制与异常容错最佳实践。
requests 的同步阻塞爬虫往往将 90% 以上的时间耗费在等待远程服务器响应的网络 I/O 阻塞上。借助 Python 标准库中的 asyncio 事件循环与专为异步 I/O 设计的客户端 aiohttp,单个操作系统线程即可通过非阻塞套接字(Non-blocking Socket)并行调度数百上千个请求,在兼顾极低 CPU 与内存占用的同时,将爬虫的数据吞吐效率提升数十倍。
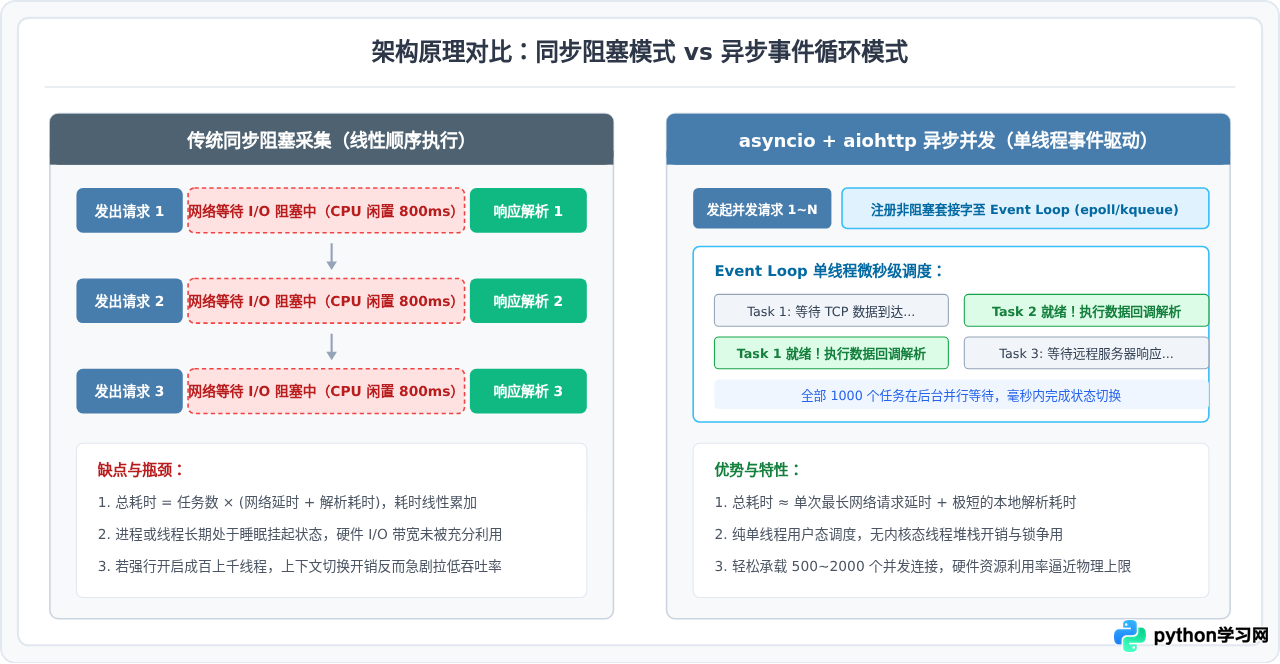
一、为什么同步多线程不适合超高并发网络采集
在编写爬虫时,许多开发者首先想到的是使用 threading 或 concurrent.futures.ThreadPoolExecutor 对同步请求进行包装。多线程模型在并发量较低(例如几十个请求)时表现尚可,但在成百上千的高并发场景下,每个系统原生线程通常需要分配数兆字节的独立栈空间,成百上千个线程会导致严重的内存膨胀。更为致命的是操作系统内核在海量线程之间进行上下文切换(Context Switch)的损耗,以及 Python 解释器全局解释器锁(GIL)带来的额外开销。
网络采集是典型的 I/O 密集型任务,CPU 计算时间极短,绝大部分时间都在等待数据包在网络中往返。异步协程(Coroutine)通过用户态的事件循环调度器,在某个网络请求发出并等待响应时,立即主动交出执行权,转而处理其他已经就绪的任务,从而在单进程单线程内实现极其紧凑高效的并发采集。
二、核心准备:开发环境与依赖组件安装
编写高性能异步爬虫需要 Python 3.8 及以上版本(推荐 Python 3.10+,其对 asyncio 核心调度器进行了大幅底层优化)。除了 aiohttp,建议搭配 aiodns 开启异步非阻塞 DNS 解析,避免系统底层的 getaddrinfo 调用阻塞事件循环。
在终端中执行以下命令安装必备依赖:
pip install aiohttp aiodns cchardet- aiohttp: 基于 asyncio 打造的异步 HTTP 客户端与服务端库。
- aiodns: 基于 c-ares 库的异步 DNS 解析引擎,避免高并发下 DNS 解析卡死主循环。
- cchardet: 高速字符集编码自动检测库,显著降低文本解码耗时。
三、关键机制:连接池管理与并发限流
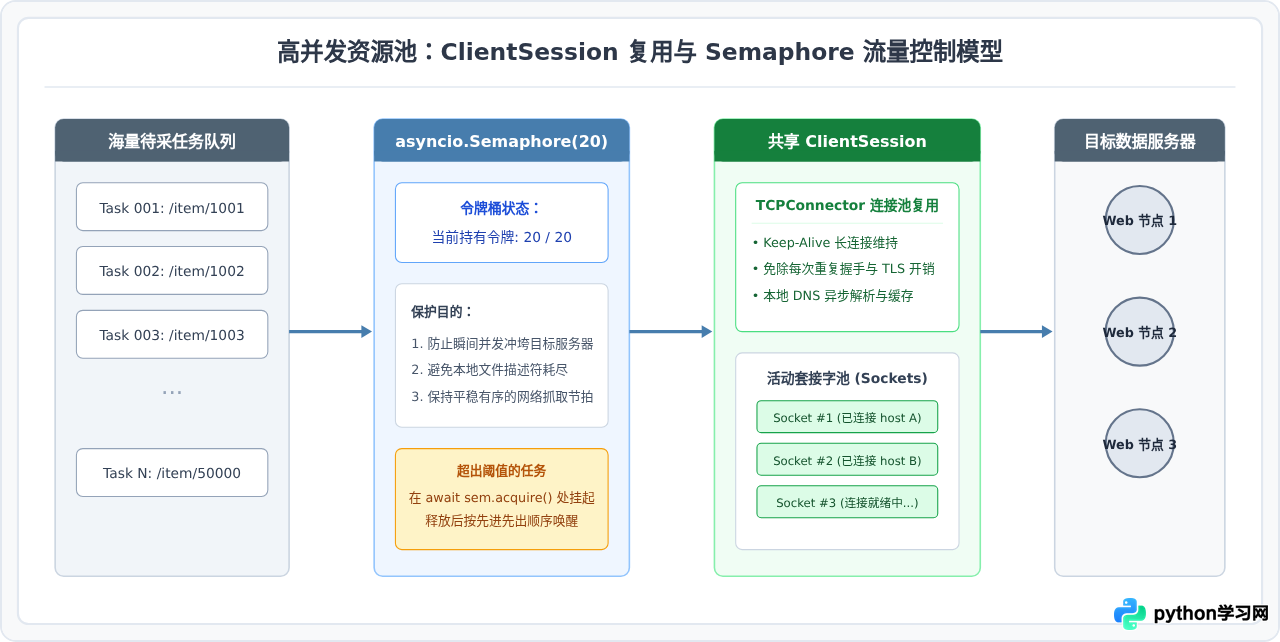
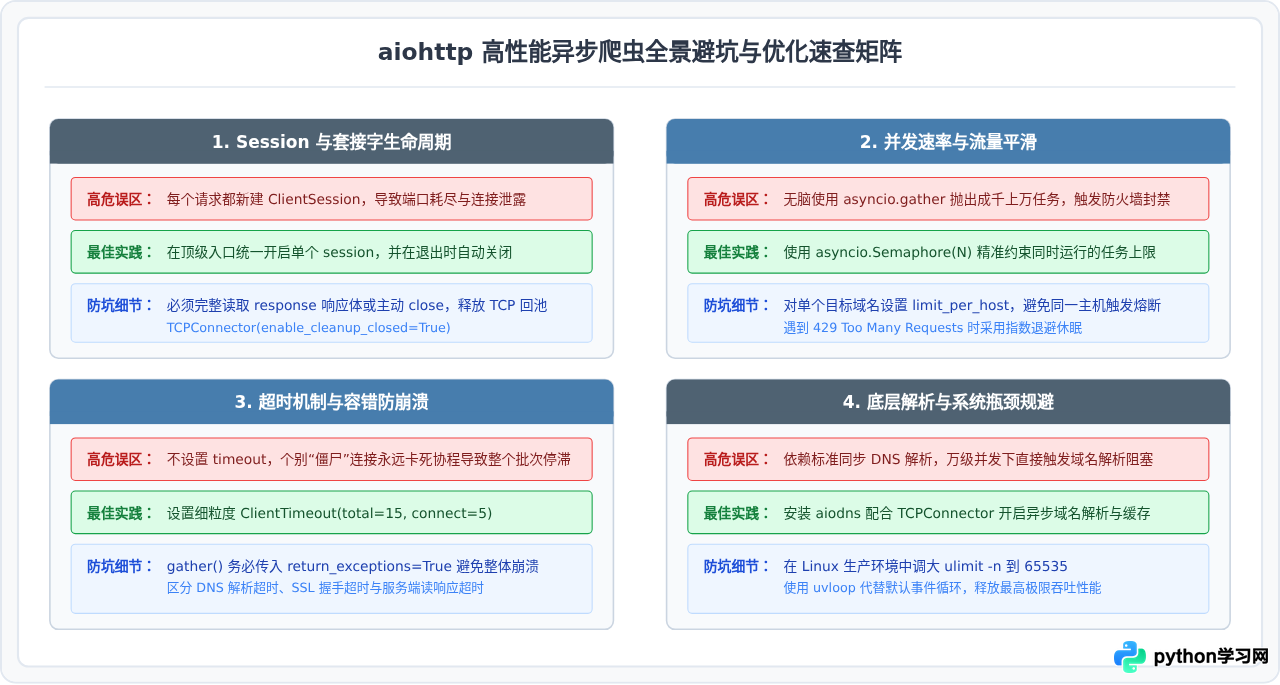
初学者在使用 aiohttp 时最容易犯的严重错误是:在每一个抓取函数内部都使用 async with aiohttp.ClientSession() 创建一个新的会话。这会导致系统频繁创建和销毁 TCP 套接字,无法享受 HTTP/1.1 连接复用(Keep-Alive)与 TLS 握手复用的红利,在高并发下甚至会因为耗尽操作系统的临时端口(Ephemeral Ports)而抛出 Cannot assign requested address 错误。
正确的做法是在爬虫生命周期内维护一个全局共享的 ClientSession,并通过 asyncio.Semaphore(信号量)精确控制当前正在并发请求的任务上限。
四、操作步骤:构建生产级异步爬虫的完整流程
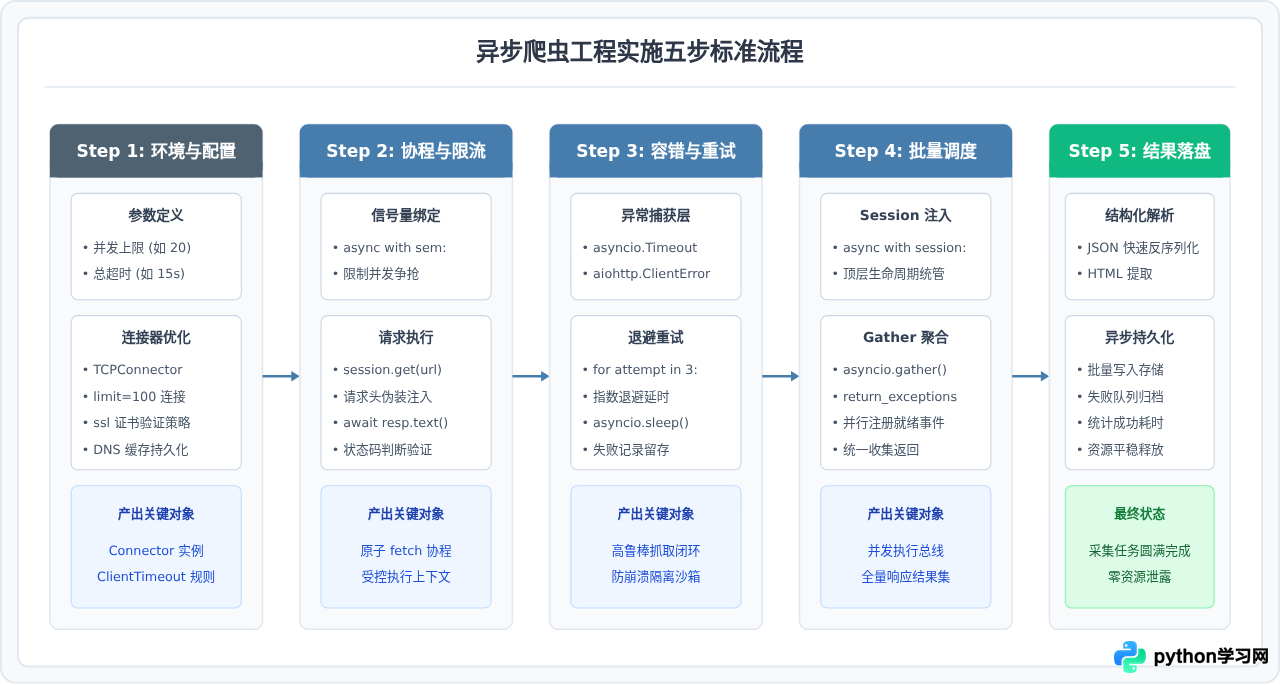
实现一套稳健、可维护的高性能异步爬虫,需要严格遵循工程化的开发步骤。从最基础的单任务封装、异常与超时隔离,到最终的连接生命周期闭环,每一步都直接决定了采集程序在面临网络抖动与海量并发时的稳定性。
完整可运行实战代码示例
以下是结合上述所有关键机制的生产级完整示例。代码中实现了信号量限制并发度、超时隔离、错误自动重试以及共享长连接池。读者可以直接保存为 Python 脚本运行验证:
import asyncio
import logging
import aiohttp
from typing import List, Optional, Dict, Any

# 配置基础日志记录
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

# 1. 单任务抓取协程(封装限流、超时与重试)
async def fetch_url(
    session: aiohttp.ClientSession,
    url: str,
    sem: asyncio.Semaphore,
    max_retries: int = 3
) -> Optional[str]:
    async with sem:  # 申请信号量令牌,限制同时发起的最大并发数
        for attempt in range(1, max_retries + 1):
            try:
                # 针对单次请求设置超时(连接 5 秒,读取 10 秒)
                timeout = aiohttp.ClientTimeout(total=15, connect=5)
                async with session.get(url, timeout=timeout) as response:
                    if response.status == 200:
                        content = await response.text()
                        logging.info(f"抓取成功 [{response.status}]: {url} (长度: {len(content)})")
                        return content
                    else:
                        logging.warning(f"请求非200状态 [{response.status}]: {url},尝试重试 ({attempt}/{max_retries})")
            except (aiohttp.ClientError, asyncio.TimeoutError) as err:
                logging.error(f"网络异常 [{err.__class__.__name__}]: {url},第 {attempt} 次重试")

            # 指数退避等待后重试,避免瞬间反复冲击
            if attempt < max_retries:
                await asyncio.sleep(1.5 * attempt)

        logging.critical(f"彻底抓取失败: {url}")
        return None

# 2. 批量调度主任务
async def run_crawler(urls: List[str], max_concurrency: int = 15):
    # 配置底层 TCP 连接器,开启 DNS 缓存与连接池限制
    connector = aiohttp.TCPConnector(
        limit=100,             # 连接池总连接上限
        limit_per_host=10,     # 单个目标域名最大连接上限
        ttl_dns_cache=300,     # DNS 缓存保留 300 秒,减少重复解析
        enable_cleanup_closed=True
    )

    # 统一定义通用请求头
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept-Encoding": "gzip, deflate"
    }

    # 初始化信号量,严格控制并发协程数量
    semaphore = asyncio.Semaphore(max_concurrency)

    # 在生命周期内仅初始化一个共享 ClientSession
    async with aiohttp.ClientSession(connector=connector, headers=headers) as session:
        # 创建待执行任务列表
        tasks = [
            asyncio.create_task(fetch_url(session, url, semaphore))
            for url in urls
        ]

        # 并发聚合调度所有任务,return_exceptions=True 保证个别任务崩溃不会打断整体流程
        results = await asyncio.gather(*tasks, return_exceptions=True)

        # 统计有效抓取结果
        valid_results = [r for r in results if isinstance(r, str)]
        logging.info(f"批量采集完成!总目标数: {len(urls)},成功抓取数: {len(valid_results)}")
        return valid_results

# 入口运行示例
if __name__ == "__main__":
    # 模拟生成 50 个待抓取目标接口
    sample_urls = [
        f"https://httpbin.org/delay/1" for _ in range(30)
    ]

    # 启动 Python 异步事件循环
    asyncio.run(run_crawler(sample_urls, max_concurrency=10))
asyncio.run() 是 Python 3.7+ 推荐的顶层入口,它会自动处理事件循环的创建、运行和最终优雅关闭。在代码中,TCPConnector 设置了 ttl_dns_cache=300,这意味着目标站点的 IP 地址在 5 分钟内只需通过操作系统解析一次,从而极大地缓解了海量并发带来的 DNS 服务器限流与延迟问题。
五、生产级性能调优与避坑检查指南
在实际工程落地过程中,异步爬虫常常面临各种“看似运行顺畅,实则暗藏隐患”的问题。以下是在规模化生产环境中必须核验的四项核心要点:
-
防范内存泄露:及时消费响应体
调用session.get()获取到response对象后,如果仅获取状态码而没有执行await response.read()、await response.text()或显式调用response.close(),底层的 TCP 套接字将无法归还给连接池,连接将长期处于挂起状态并逐渐耗尽操作系统的句柄。 -
Linux 环境下升级 uvloop 事件循环
在类 Unix 系统(Linux / macOS)上,标准库的asyncio事件循环基于纯 Python 与 C 封装实现。如果需要追求极限的吞吐性能,可以在运行脚本前安装uvloop,它由 Cython 编写且底层直接依赖高性能网络库libuv:import uvloop uvloop.install() # 在 asyncio.run() 之前调用,事件循环性能提升 2~4 倍 -
合理配置操作系统文件描述符(ulimit)
大多数 Linux 发行版默认对单个进程限制最大打开 1024 个文件描述符。一个 TCP 连接就会占用一个套接字描述符。当并发度设计超过 500 时,必须在服务器端通过ulimit -n 65535调高上限,否则将触发OSError: [Errno 24] Too many open files。 -
分布式架构下的速率与反爬对冲
异步的高性能往往是一把双刃剑。瞬间 500 个并发请求极易触发目标服务器的 WAF(如 Cloudflare、阿里云盾)或限流熔断机制,导致 IP 遭到封禁。在爬虫代码中,应针对特定域名设定合理的limit_per_host,并在必要时引入异步代理轮换池。
六、总结与选型建议
Python 异步生态中的 asyncio 与 aiohttp 为网络爬虫开发提供了极其出色的并发性能解决方案。通过单线程非阻塞 I/O,开发者无需承担多线程带来的高昂内存开销与锁竞争,即可轻松管理数百乃至上千个并发 HTTP 会话。
在实际技术选型中:
- 如果任务规模在百个页面以内,且对采集速度没有严苛要求,传统的
requests配合简易多线程即可满足需求,开发和调试心智负担最小; - 如果面对的是十万乃至数百万级别的接口请求,且目标服务器支持高并发接入,
aiohttp + asyncio是当前 Python 技术栈中性能最佳、资源消耗最低的纯原生首选方案; - 而对于需要复杂动态渲染、点击交互的现代前端页面,则应考虑将
Playwright Python的异步接口(playwright.async_api)接入到同一个asyncio事件循环中,兼顾渲染能力与异步并发调度。
只要严格遵循本文总结的“共享单一 Session 实例、Semaphore 约束最大并发、细粒度超时与异常隔离、异步 DNS 与连接池复用”四大核心法则,便能构建出在生产环境中高吞吐、低延迟且极其坚固的 Python 异步爬虫。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









