

Python爬虫在SEO关键词排名监控中的实战用途
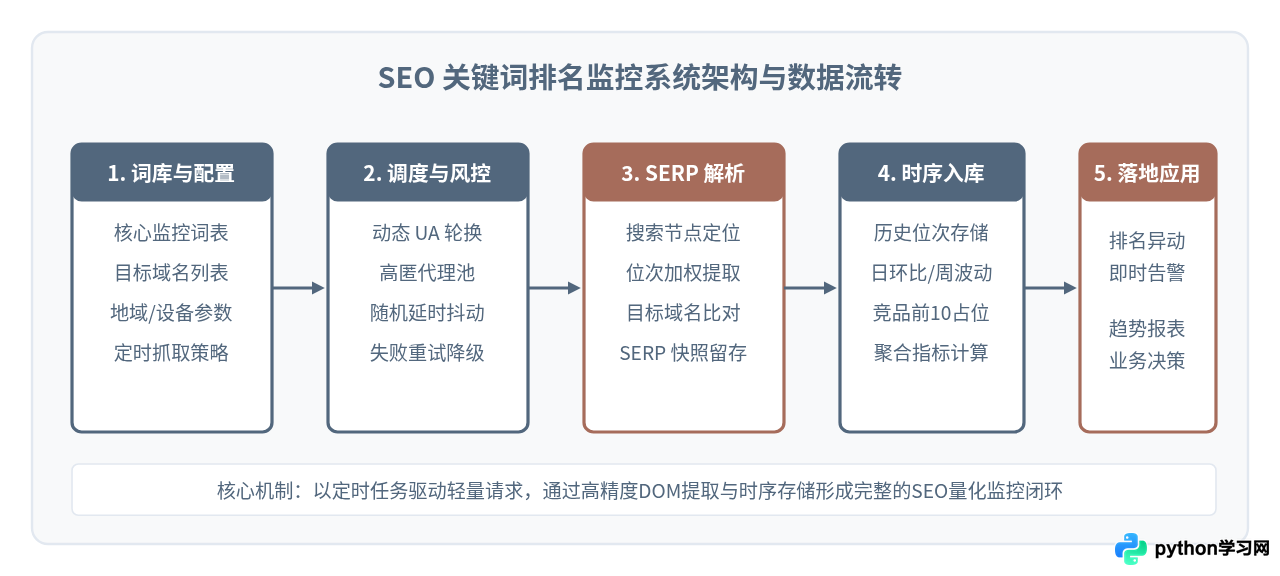
深入解析Python爬虫在SEO关键词排名监控中的实战用途,涵盖系统架构设计、请求与防风控策略、SERP节点解析、时序数据入库与业务预警闭环。
一、为什么自建Python爬虫监控关键词排名
很多SEO从业者会发现一个普遍现象:同一关键词在不同时间、不同设备、甚至不同IP地址下查询时,展现的结果序列差异明显。通用型商业监控平台为了降低自身运行成本,通常只提供每日固定一次的全国聚合快照,无法满足精细化运营需求。通过自建Python爬虫,主要能够在以下四个实战场景中发挥核心作用:
- 长尾词高频矩阵追踪:企业核心业务可能涵盖数千至数万个长尾词。自建爬虫可以根据词条的重要程度进行分层调度,核心大词按小时级监控,长尾词按天级追踪,避免盲目消耗第三方商业额度。
- 精确定向参数模拟:通过构造特定请求头与查询字符串,模拟特定移动设备(User-Agent)、特定地区DNS或Cookie环境,准确掌握特定目标客群所看到的真实排名位次。
- 竞品占位与SERP结构监控:不仅记录自身站点的名次,还能一并保存搜索结果前10位的竞品域名、富媒体摘要卡片(Featured Snippet)及百度“大家还在搜”等聚合内容,评估SERP版面挤占情况。
- 核心算法调整与改版验证:当站点发布新功能、改版上线或搜索引擎更新核心算法时,通过爬虫的高频采集能够比第三方平台早12至24小时发现位次剧烈震荡,为紧急回滚或针对性修复争取时间。
二、爬虫采集与排名的核心操作步骤
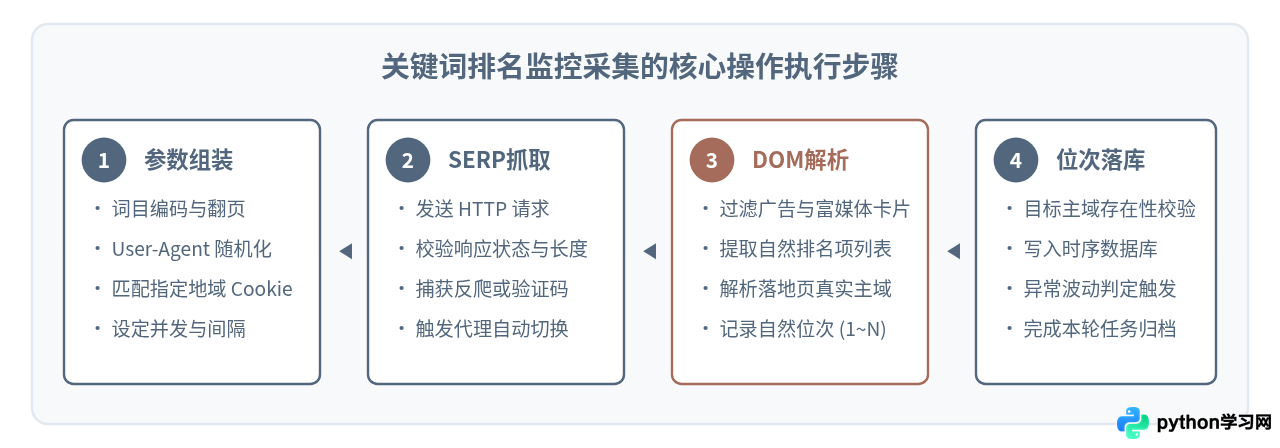
构建一个稳定的排名抓取脚本,核心不是盲目并发,而是建立清晰的执行流程。整体执行过程可以归纳为准备参数、请求抓取、解析DOM及结果入库四个标准环节:
1. 目标URL与请求参数构造
以常规搜索引擎为例,请求参数中必须妥善处理查询关键字(如 URL 编码)、每页结果展示条数(如 rn=10 或 num=10)以及翻页偏移量(如 pn=0, 10, 20)。为了防止请求被判定为自动化脚本,需要随机轮换真实的浏览器 User-Agent,并维持适当的请求间隔(建议在 2.5 秒至 5.0 秒之间加入随机抖动)。
2. SERP 节点定位与自然排名计算
搜索引擎页面中通常混杂着商业推广(竞价广告)、聚合智能推荐块(如知识图谱、百家号聚合、聚合问答)和自然搜索结果。直接按 DOM 中的整体子节点次序计数会导致自然排名虚高。在解析时,需要根据页面特定容器的 Class 或属性先过滤掉商业赞助标志,仅对符合自然结果特征的条目进行累加自增。
3. 落地页域名提取与比对
现代搜索引擎出于数据统计与防外链刷量目的,SERP 中的 href 往往是加密重定向链接(例如百度的 https://www.baidu.com/link?url=...)。在不发起二级跳转的前提下,通常可以通过提取搜索卡片底部展示的来源域名文本(如包含目标主域名的文本节点)或直接在内存中建立重定向解析缓存,从而快速确定当前排名项归属的站点。
三、轻量级实战代码示例
以下为一个可运行的轻量级 Python 监控实现示例。使用 requests 库建立会话,并借助 BeautifulSoup 进行 DOM 解析。代码封装了自然排名识别与目标域名搜索逻辑:
import time
import random
import requests
from bs4 import BeautifulSoup
from urllib.parse import quote, urlparse

class SEORankMonitor:
    def __init__(self, target_domain):
        self.target_domain = target_domain.lower()
        self.session = requests.Session()
        self.headers = {
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                          "(KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
        }

    def fetch_serp(self, keyword, page=0):
        """抓取指定关键字的搜索结果页"""
        encoded_kw = quote(keyword)
        # 以标准搜索结果请求为例,pn 表示分页起始索引
        url = f"https://www.baidu.com/s?wd={encoded_kw}&pn={page * 10}&rn=10"
        try:
            time.sleep(random.uniform(2.0, 4.0)) # 随机抖动避免高频封禁
            resp = self.session.get(url, headers=self.headers, timeout=10)
            if resp.status_code == 200:
                return resp.text
            return None
        except requests.RequestException as e:
            print(f"请求失败 [{keyword}]: {e}")
            return None

    def parse_rank(self, html_content, max_check=20):
        """解析页面中的自然搜索结果并确定目标域名位次"""
        if not html_content:
            return None, []

        soup = BeautifulSoup(html_content, "html.parser")
        # 定位搜索结果条目容器(以常见结果卡片结构为例)
        result_cards = soup.select(".result.c-container, .c-container")

        current_rank = 0
        ranked_items = []
        found_rank = None

        for card in result_cards:
            # 过滤包含商业推广或广告标记的条目
            if card.select(".ec_tuiguang_ppim, .f13 .m"):
                continue

            title_node = card.select_one("h3 a")
            if not title_node:
                continue

            current_rank += 1
            title = title_node.get_text(strip=True)
            link = title_node.get("href", "")

            # 提取卡片底部的真实展示来源域
            source_node = card.select_one(".c-showurl, .source-wrap, .c-color-gray")
            source_text = source_node.get_text(strip=True) if source_node else ""

            ranked_items.append({
                "rank": current_rank,
                "title": title,
                "source": source_text
            })

            # 判断是否命中目标域名
            if self.target_domain in source_text.lower() and found_rank is None:
                found_rank = current_rank

            if current_rank >= max_check:
                break

        return found_rank, ranked_items

# 示例调用
if __name__ == "__main__":
    monitor = SEORankMonitor(target_domain="example.com")
    keyword = "Python爬虫教程"
    html = monitor.fetch_serp(keyword, page=0)
    target_rank, top_items = monitor.parse_rank(html)

    if target_rank:
        print(f"关键词 '{keyword}' 监控结果:目标域名位列第 {target_rank} 名")
    else:
print(f"关键词 '{keyword}' 监控结果:前 {len(top_items)} 名未发现目标域名")四、技术方案对比与反爬攻防权衡
在设计关键词爬虫时,技术选型直接决定了监控架构的服务器成本与运行稳定性。主要的技术路径分为两类:基于轻量 HTTP 请求库(如 Requests、Httpx)和基于无头浏览器(如 Playwright、Selenium)。两者在资源占用、吞吐量和抗反爬能力上有显著差异:
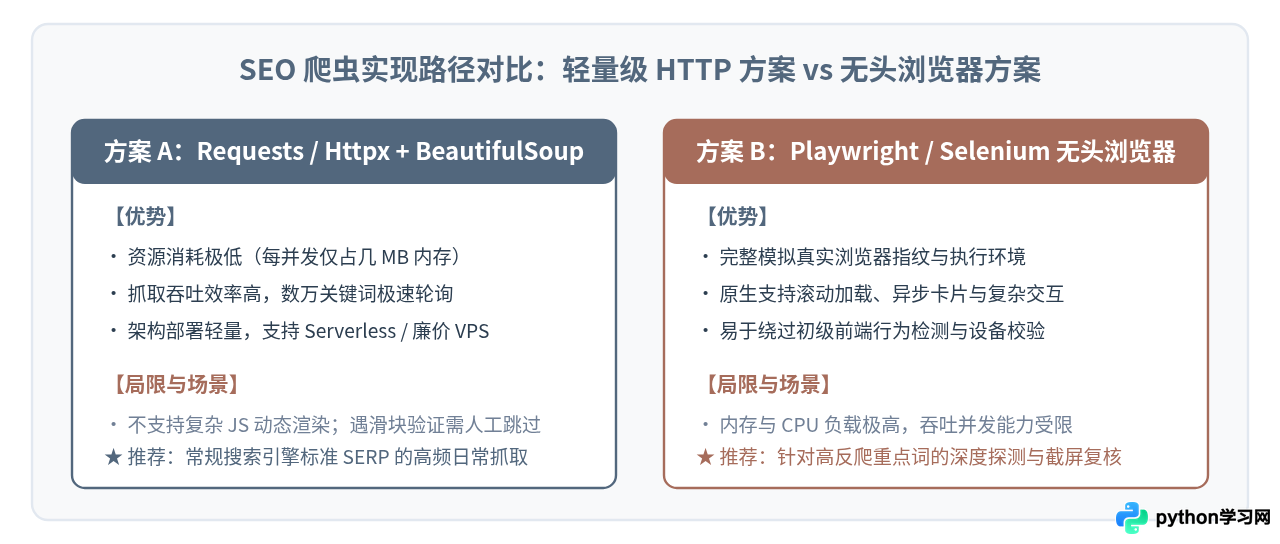
| 评估维度 | 轻量级 HTTP 方案 | 无头浏览器方案 | 实际选型建议 |
|---|---|---|---|
| 单节点内存开销 | 约 50MB ~ 150MB | 1GB ~ 3GB 以上 | 大规模词库优先选择轻量请求方案 |
| 单词抓取延迟 | 0.3s ~ 1.2s | 3.5s ~ 8.0s | 常规监控场景轻量方案效率高 5~10 倍 |
| 反爬验证应对 | 需依赖代理池轮换及请求头伪装 | 可注入 JS 脚本规避指纹检测 | 出现复杂验证码时降级至浏览器处理 |
| 部署维护复杂度 | 极低,无环境依赖 | 高,需要浏览器二进制文件及驱动 | 生产环境通常采取“轻量为主,无头兜底”架构 |
五、监控数据驱动业务决策的闭环实践
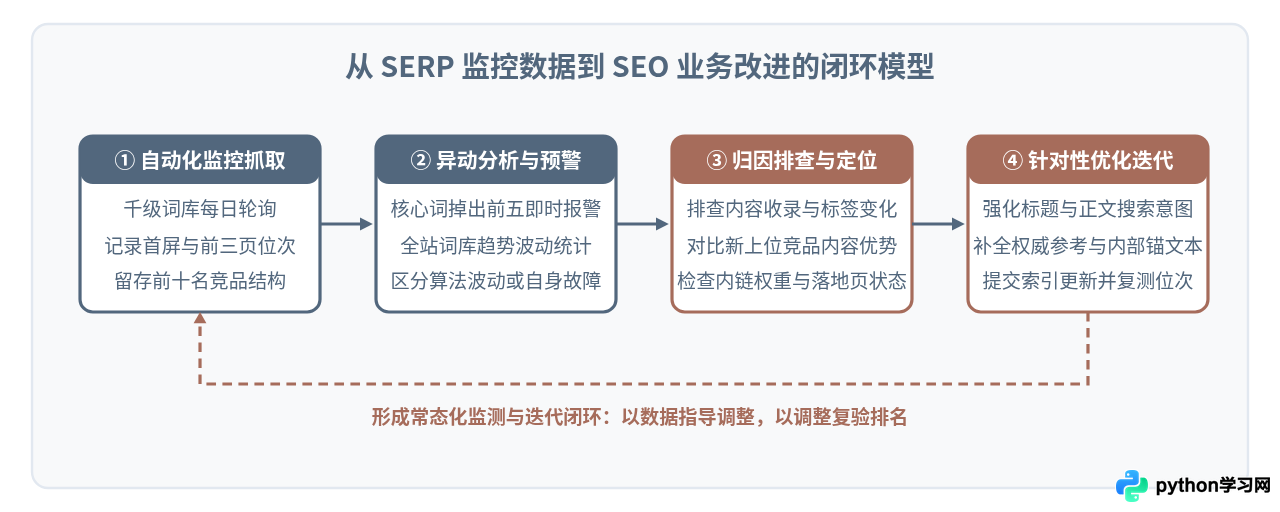
抓取排名数据只是技术手段,真正产生商业价值的是基于这些数据形成的响应机制。如果排名发生变动无法及时反馈到内容与技术团队,监控就失去了意义。完整的业务闭环应当覆盖从数据采集到优化落地的全流程:
1. 设定关键阈值与异动告警
并非所有排名波动都需要人工介入。日常搜索结果往往存在 1~2 位的正常摆动。系统应设置差异化阈值规则:
- 核心主词掉出首页:当长期排在第 1~3 位的高转化主词跌落至第 6 名以后甚至第二页时,触发即时 Webhook 告警(如企业微信、钉钉或邮件群发通知)。
- 批量子词同步下滑:如果某个专题或频道的数十个相关长尾词同时出现位次下降,通常意味着该目录的模版结构存在技术故障(如死链增多、TDK 标签被覆盖)或遭到搜索引擎降权。
2. 归因诊断与策略迭代
收到报警后,结合爬虫记录的历史 SERP 快照,可以快速完成三步归因分析:首先查看替代当前位次的新页面是谁,分析竞品在近期是否补充了更全面、时效性更强的内容;其次检查自身落地页的 HTTP 状态码与抓取时间戳,排除服务器宕机或防盗链误拦截导致的快照缺失;最后根据归因结果更新正文内容、调整内部锚文本,并在更新后通过爬虫持续观察位次复苏曲线。
六、实践总结与合规建议
自建 Python 关键词排名爬虫赋予了团队对 SEO 核心指标的完全掌控力。在实际部署和日常运行中,应始终遵守以下原则:
- 克制并发频率:监控爬虫的目标是获取排位快照,而非做全量离线镜像。保持合理的随机请求延时与分布式调度,既保护了搜索引擎的服务器资源,也保障了爬虫任务的长期存活。
- 定期维护解析规则:搜索引擎前端界面每隔数月会微调 DOM 结构或 Class 命名。系统应当建立“解析失败率警报”,一旦连续多个关键词未能匹配到有效排名项,提示工程师跟进校验选择器规则。
- 轻量入库与增量归档:对历史位次采用时序数据格式(如每条记录包含
timestamp, keyword_id, rank, domain, title),按月进行归档汇总,保证图表渲染和长周期对比分析的高效流畅。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









