

Python爬虫下载断点续传怎么实现?Range请求头详解
系统讲解Python爬虫如何利用HTTP Range请求头实现大文件断点续传,涵盖Accept-Ranges、Content-Range头解析、206与416状态码处理、文件追加写入及完整健壮代码实现。
在网络爬虫下载大型文件(如数据集、视频或安装包)时,网络波动、超时或程序意外退出是极为常见的现象。断点续传的核心思路是:获取已下载的本地字节数,并在发起下一次网络请求时通过 HTTP 的 Range 请求头告知服务端从中断位置继续传输剩余数据,最后以追加模式将数据拼接写入文件。本文将系统拆解该机制的协议原理、核心状态码流转、关键代码实现以及在生产环境中必须防御的边界陷阱。
一、HTTP Range 机制与断点续传协议原理
传统的 HTTP GET 请求默认请求资源的全部内容(从第 0 字节到最后一个字节)。如果下载在 90% 时发生连接中断,重新发起普通 GET 请求将迫使客户端从头下载,既浪费带宽又延长传输时间。HTTP/1.1 标准引入了分段传输控制机制,允许客户端只请求指定区间的字节流。
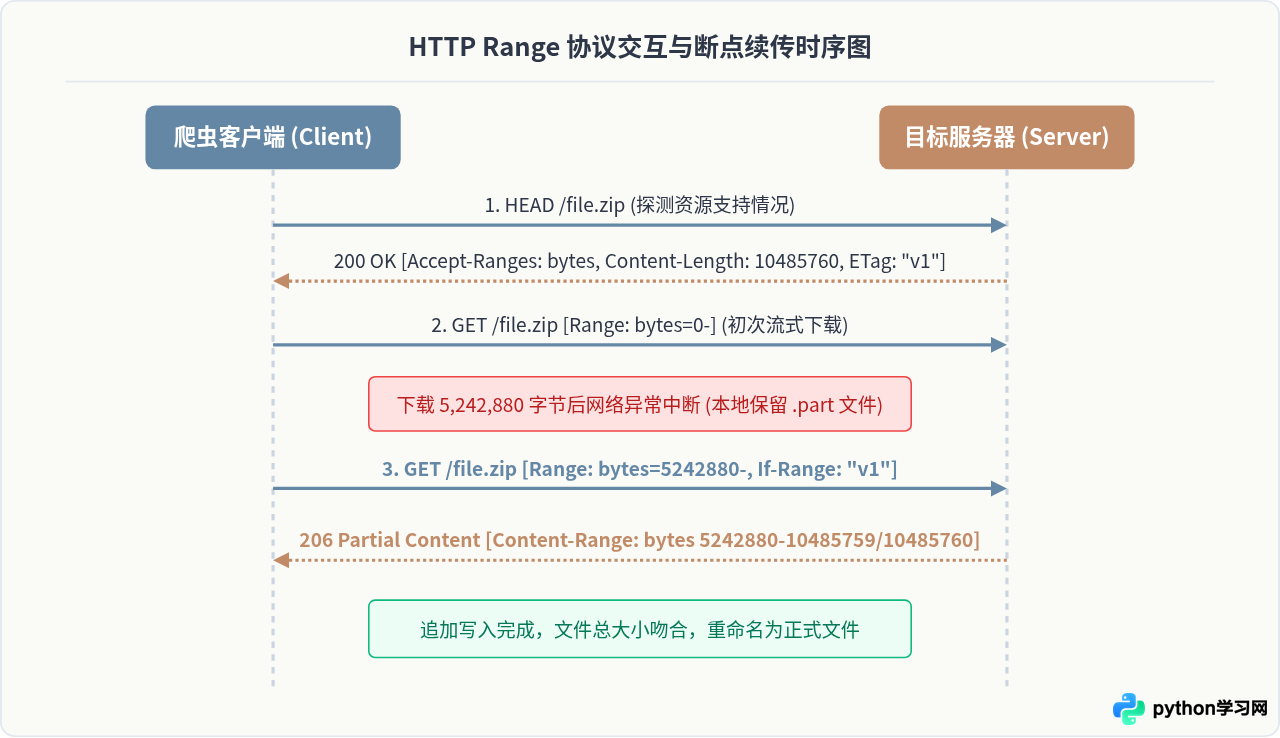
断点续传通常包含三个关键交互阶段:
- 探针阶段:客户端向服务器发起 HEAD 或轻量级 GET 请求,检查响应头中是否包含
Accept-Ranges: bytes,确认服务器支持按字节区间请求,并记录资源的完整大小(Content-Length)以及资源指纹(ETag或Last-Modified)。 - 分段传输阶段:客户端根据本地已有文件的字节大小(例如已下载 5MB),在请求头中加入
Range: bytes=5242880-。若服务端支持该区间,将返回状态码 206 Partial Content 及对应的分段字节流。 - 校验与组装阶段:客户端以追加写入方式将新字节写入磁盘,下载完毕后比对总大小或哈希值,确保文件完整无损。
二、核心请求头、响应头与状态码解析
实现断点续传前,必须严格厘清与分段下载相关的关键协议头与状态码含义:
1. 请求头参数
Range: bytes=start-end:请求指定闭区间字节。例如bytes=0-499表示前 500 个字节。Range: bytes=start-:从start字节一直请求到文件末尾。断点续传最常用该语法,如Range: bytes=1024-。If-Range: <ETag> | <Date>:条件请求头。如果资源未变更,服务端返回 206 续传数据;如果资源已被修改,服务端直接返回 200 及完整新资源,防止新旧数据片段混拼造成损坏。
2. 响应头参数
Accept-Ranges: bytes:表明服务端支持按字节单位分段请求。如果返回none或缺失,说明服务端不支持断点续传。Content-Range: bytes start-end/total:指示当前响应主体所覆盖的字节区间与资源总大小。例如bytes 500-999/5000表示当前返回 500 个字节,完整文件为 5000 字节。如果总大小未知,total 位置可能显示为星号*。
3. 响应状态码的含义与处理
| 状态码 | 标准名称 | 在断点续传中的含义与处理策略 |
|---|---|---|
| 206 | Partial Content | 服务端成功解析 Range 头,仅返回指定区间数据。此时客户端应以追加写入(ab)方式接收。 |
| 200 | OK | 服务端不支持 Range 或忽略了 Range 头,重新返回全部数据。客户端必须清空本地已有文件并从头保存。 |
| 416 | Range Not Satisfiable | 请求的字节区间超出文件范围(如本地已有大小等于或大于服务端文件总大小)。客户端应视为已完成或校对后修复。 |
三、断点续传的执行逻辑与流程控制
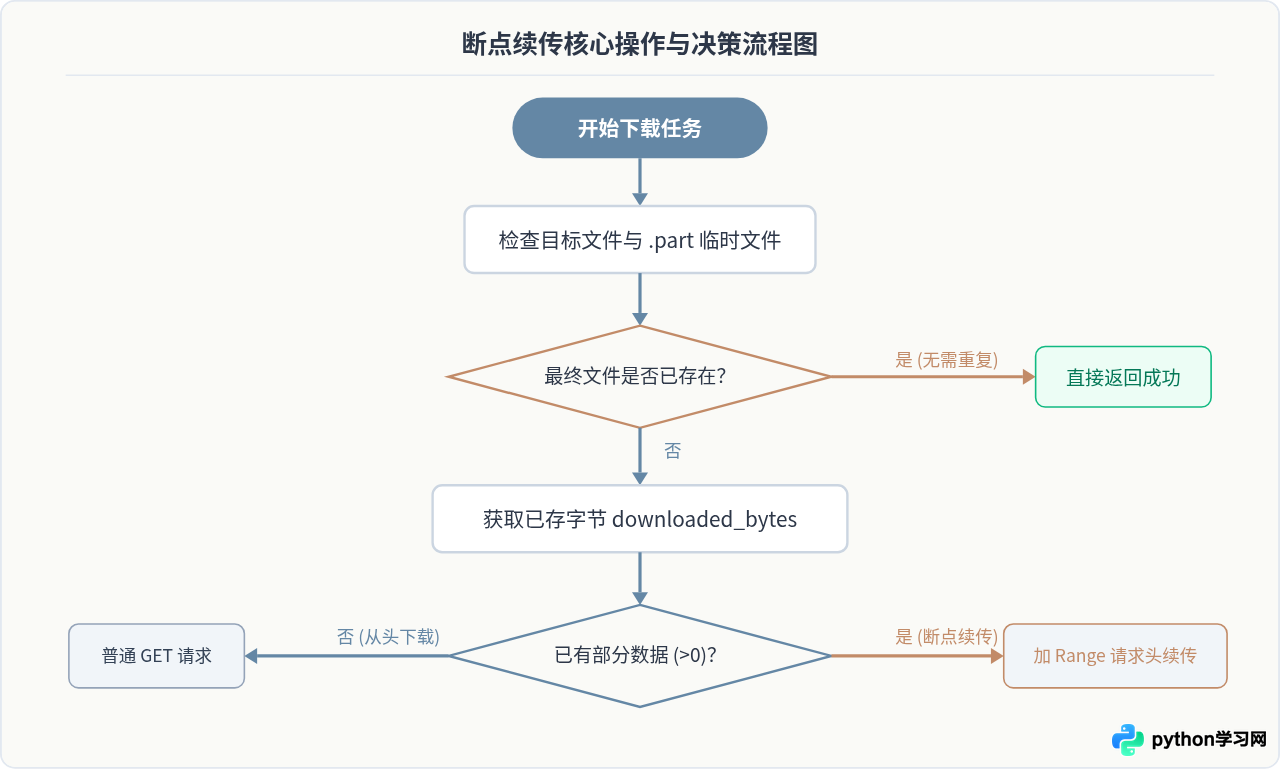
编写爬虫下载器时,逻辑的严密性远比单一网络请求重要。断点续传必须处理首次下载、中途重连、服务端不支持、本地文件已存在等多种分支情况。
四、文件存储模型与追加写入机制
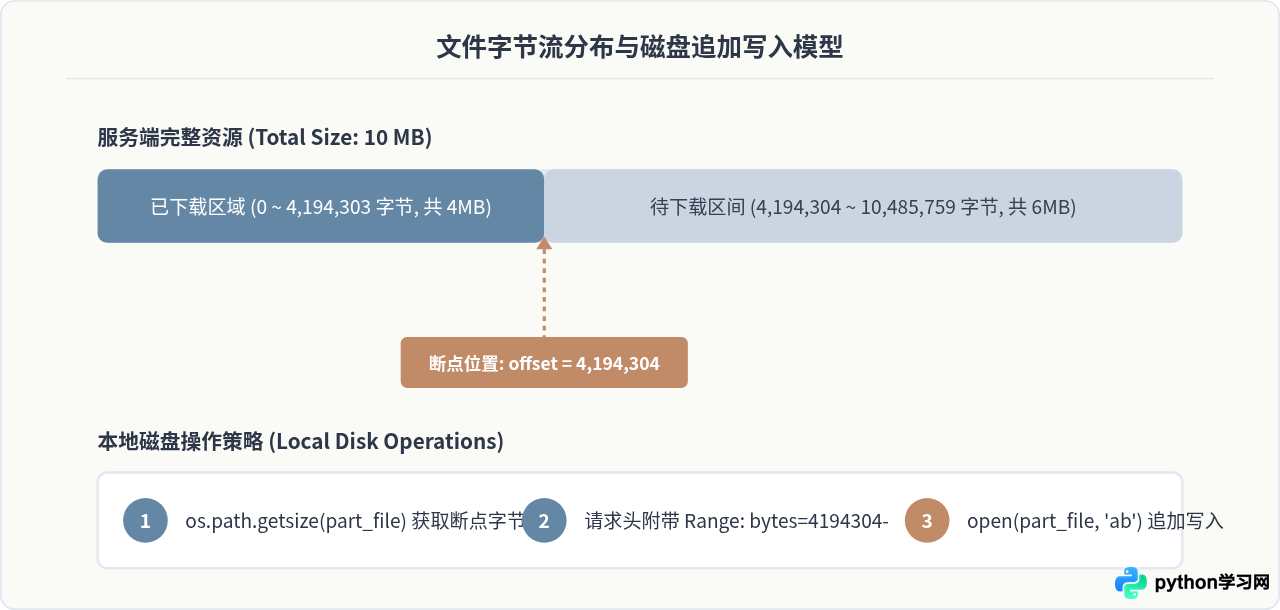
在磁盘层面,断点续传不仅依赖 HTTP 协议头的协作,还取决于本地文件打开模式与写入位置的对应关系。
常见误区是直接使用 open(filename, 'w') 或 open(filename, 'wb'),这会在打开瞬间清空文件原本的所有内容,导致之前的下载成果付诸东流。在断点续传场景中:
- 使用临时文件扩展名:下载未全部完成前,将文件命名为
filename.part或filename.downloading。这样能避免其他进程误读取未完整的半成品文件。 - 以追加模式(
ab)写入:Python 的'ab'模式会将文件指针直接自动定位到文件末尾。每次通过iter_content读入一个数据块(chunk),调用write()即刻追加至末尾。 - 网络与磁盘字节对齐:如果本地已存在 5,000,000 字节,网络请求必须明确指定
Range: bytes=5000000-。由于数组索引从 0 开始,5000000 正好是第 5000001 个字节的偏移位置,两者严格吻合无重叠。
五、完整的 Python 实现代码
以下是使用标准 requests 库实现的稳健断点续传函数。该实现包含了网络重试机制、状态码分支处理(206/200/416)、流式追加写入以及下载完成后的原子替换重命名。
import os
import time
import requests

def download_file_with_resume(url: str, target_path: str, chunk_size: int = 8192, max_retries: int = 5) -> bool:
    """
    使用 Range 请求头实现断点续传下载
    :param url: 资源下载链接
    :param target_path: 最终目标文件路径
    :param chunk_size: 流式传输单块大小(默认 8KB)
    :param max_retries: 异常重试次数
    :return: 下载成功返回 True,失败返回 False
    """
    # 如果目标文件已存在且完整,无需重复下载
    if os.path.exists(target_path):
        print(f"[提示] 目标文件已存在,无需重复下载: {target_path}")
        return True

    # 临时文件,避免半途失败留下损坏的目标文件
    part_path = f"{target_path}.part"

    for attempt in range(1, max_retries + 1):
        try:
            # 1. 检查已下载的本地字节数
            downloaded_bytes = os.path.getsize(part_path) if os.path.exists(part_path) else 0

            # 2. 构造请求头,按需加入 Range
            headers = {
                "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
            }
            if downloaded_bytes > 0:
                headers["Range"] = f"bytes={downloaded_bytes}-"
                print(f"[续传] 正在尝试从字节 {downloaded_bytes} 处续传 (第 {attempt} 次尝试)...")
            else:
                print(f"[下载] 开始全新下载 (第 {attempt} 次尝试)...")

            # 3. 发起流式请求 (stream=True 必须开启)
            with requests.get(url, headers=headers, stream=True, timeout=(5, 30)) as resp:
                status = resp.status_code

                # 情况 A:416 Range Not Satisfiable
                # 说明本地大小可能已经达到甚至超出了服务端文件总长度
                if status == 416:
                    print("[检测] 收到 416,说明本地字节可能已等于或超出资源大小,执行最终校对...")
                    # 尝试发起一次 HEAD 请求验证实际大小
                    head_resp = requests.head(url, headers={"User-Agent": headers["User-Agent"]}, timeout=10)
                    total_len = int(head_resp.headers.get("Content-Length", 0))
                    if total_len > 0 and downloaded_bytes >= total_len:
                        os.rename(part_path, target_path)
                        print("[完成] 文件校验完毕并成功保存。")
                        return True
                    else:
                        # 本地文件大小异常大于服务端或服务端不支持,重置临时文件
                        print("[警告] 字节校验异常,清空临时文件并从头重新下载。")
                        if os.path.exists(part_path):
                            os.remove(part_path)
                        continue

                # 情况 B:206 Partial Content (断点续传成功触发)
                if status == 206:
                    mode = "ab"  # 追加写入
                    content_range = resp.headers.get("Content-Range", "")
                    print(f"[连接] 服务端支持断点续传,Content-Range: {content_range}")

                # 情况 C:200 OK (服务端忽略 Range 或初次下载)
                elif status == 200:
                    if downloaded_bytes > 0:
                        print("[注意] 服务端不支持 Range 请求头,回退为全量重新下载...")
                    mode = "wb"  # 必须使用覆盖写入,不可追加
                    downloaded_bytes = 0
                else:
                    print(f"[错误] 服务器返回异常状态码: {status}")
                    time.sleep(2)
                    continue

                # 4. 流式分块写入磁盘
                with open(part_path, mode) as f:
                    for chunk in resp.iter_content(chunk_size=chunk_size):
                        if chunk:  # 过滤 keep-alive 新行心跳
                            f.write(chunk)

                # 本次流正常读完,将临时文件重命名为正式目标文件
                os.rename(part_path, target_path)
                print(f"[成功] 文件下载完成: {target_path}")
                return True

        except (requests.RequestException, IOError) as exc:
            print(f"[异常] 第 {attempt} 次请求失败: {exc}")
            if attempt < max_retries:
                sleep_time = attempt * 2
                print(f"[等待] {sleep_time} 秒后重试...")
                time.sleep(sleep_time)
            else:
                print("[失败] 达到最大重试次数,下载任务终止。")
                return False

    return False

# 示例调用 (仅作为演示代码,实际执行时请替换为具体下载链接)
if __name__ == "__main__":
    demo_url = "https://speed.hetzner.de/100MB.bin"
    output_filename = "download_sample.bin"
    download_file_with_resume(demo_url, output_filename)
代码核心细节要点说明:
1. stream=True:这是下载大文件的核心参数。如果不设为 True,requests 会在内存中一次性加载全部响应体,可能瞬间导致内存溢出(OOM)。
2. 状态码 200 时的回退处理:如果客户端请求了 Range: bytes=1000- 但服务器返回 200(而非 206),必须切换为 'wb' 模式从头覆盖写入,否则将错误地把新的一整份文件追加到旧数据之后,导致最终文件体积翻倍且损坏。
六、关键问题与防御清单
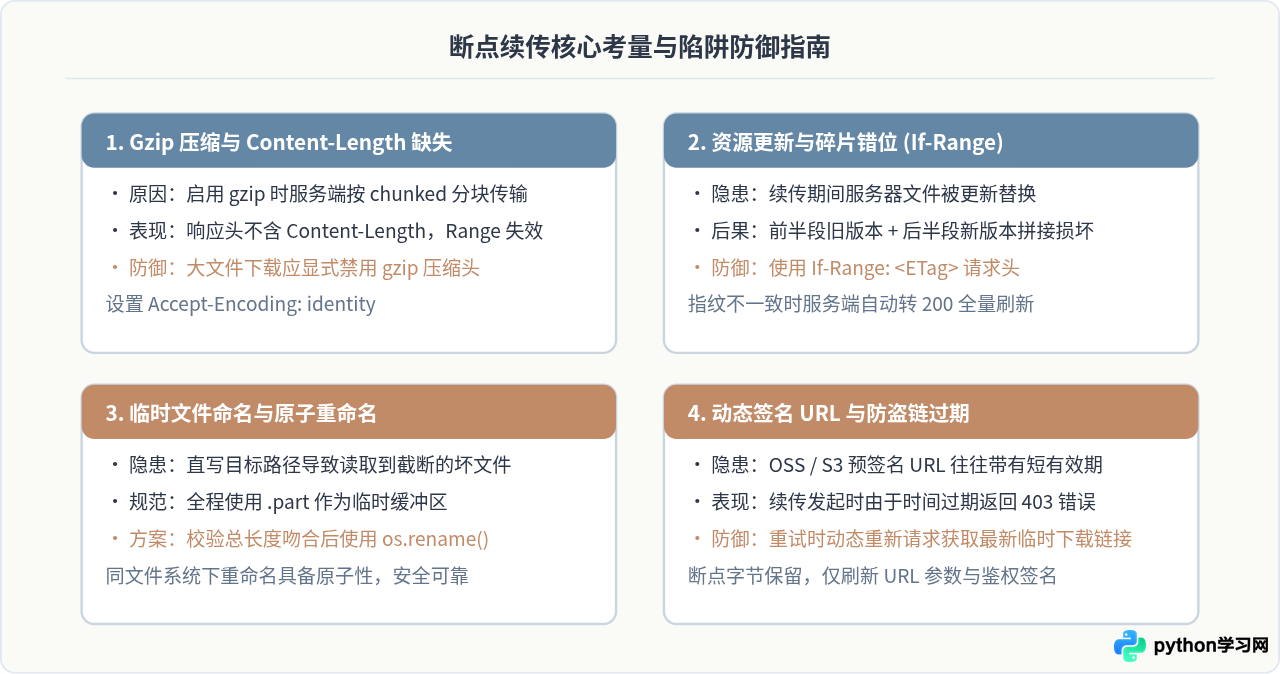
在实际生产部署中,简单的 HTTP 请求往往会受到 CDN 缓存、压缩算法及反爬策略的影响。开发爬虫断点续传模块时,必须排查并防御以下隐蔽问题:
七、总结
Python 爬虫实现断点续传的本质并不复杂,其核心链条可以归纳为四步:
- 本地感知:利用
os.path.getsize()精准获取当前已经持久化落盘的有效字节数。 - 协议对齐:向服务端发送格式为
Range: bytes={offset}-的 HTTP 请求头,要求服务端仅回传剩余数据。 - 状态自适应:严密拦截 HTTP 响应,正确识别 206 Partial Content(以
ab模式追加写)、200 OK(以wb模式全量写)与 416 Range Not Satisfiable(已满或越界校对)。 - 落盘防御:借助
.part临时文件机制结合原子重命名,确保不会将损坏或半截的无效文件交付给下游业务。
掌握这套基于 HTTP 规范的标准处理机制,能让爬虫系统在面对几百兆甚至数十吉字节(GB)的海量文件采集任务时,具备极高的网络弹性和资源节约能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









