

Python怎么反向遍历列表
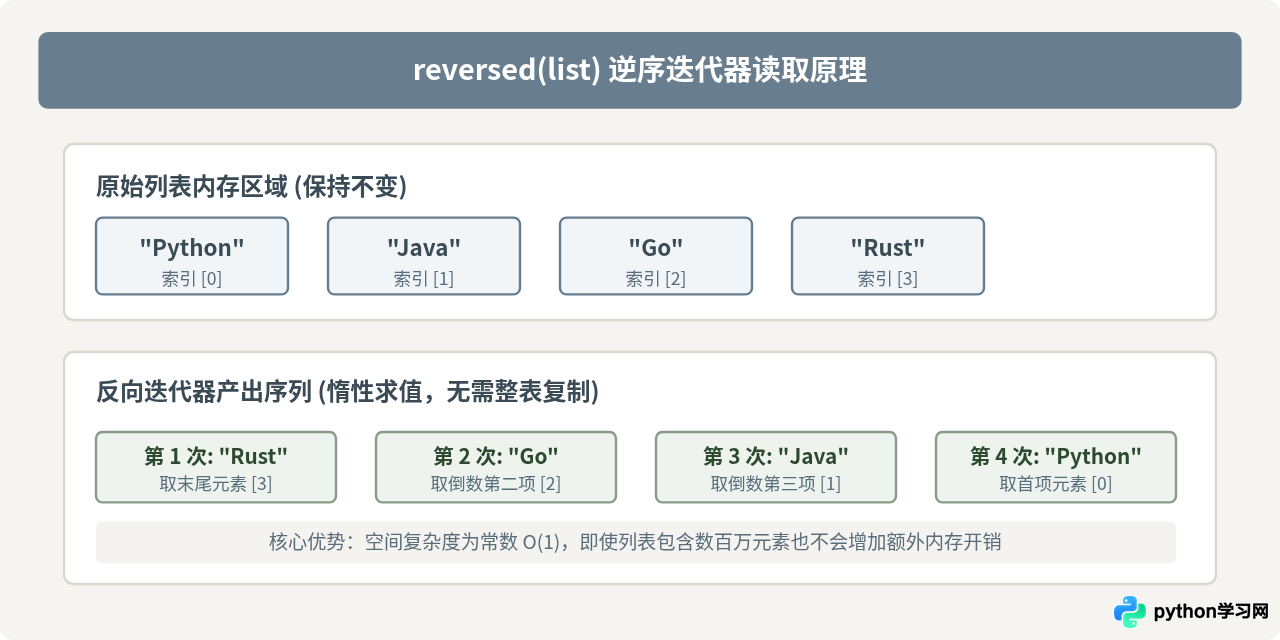
reversed()。它返回一个逆序迭代器,直接从列表末尾向前产出元素,既不会修改原始列表,也不会产生额外的内存拷贝。若需要同时获取元素索引,可配合 range() 或负索引;若需要独立生成逆序副本,则可以使用切片步长 [::-1]。
方法一:使用内置函数 reversed()(首选方案)
当只需要按从后往前的顺序读取列表元素时,reversed() 是官方推荐的惯用语法。它接受一个序列作为参数,并返回一个反向迭代器(list_reverseiterator)。
以下是使用 reversed() 进行反向遍历的完整示例:
# 示例:使用 reversed() 从尾部向前遍历列表
languages = ["Python", "Java", "Go", "Rust"]

for lang in reversed(languages):
print(lang)Rust
Go
Java
Python
遍历结束后,原始列表 languages 没有任何改变,依然保持原本的 ["Python", "Java", "Go", "Rust"]。这保证了数据访问的只读安全性。
方法二:使用切片语法 [::-1] 反转遍历
切片是 Python 处理序列的常见特性。通过将切片的第三个参数(步长 step)设为 -1,可以快速构造列表的反转切片:
# 示例:通过切片 [::-1] 进行反向遍历
scores = [85, 92, 78, 99]

for score in scores[::-1]:
print(score)99
78
92
85
关键差异解析:reversed() 与 [::-1] 为什么不同?
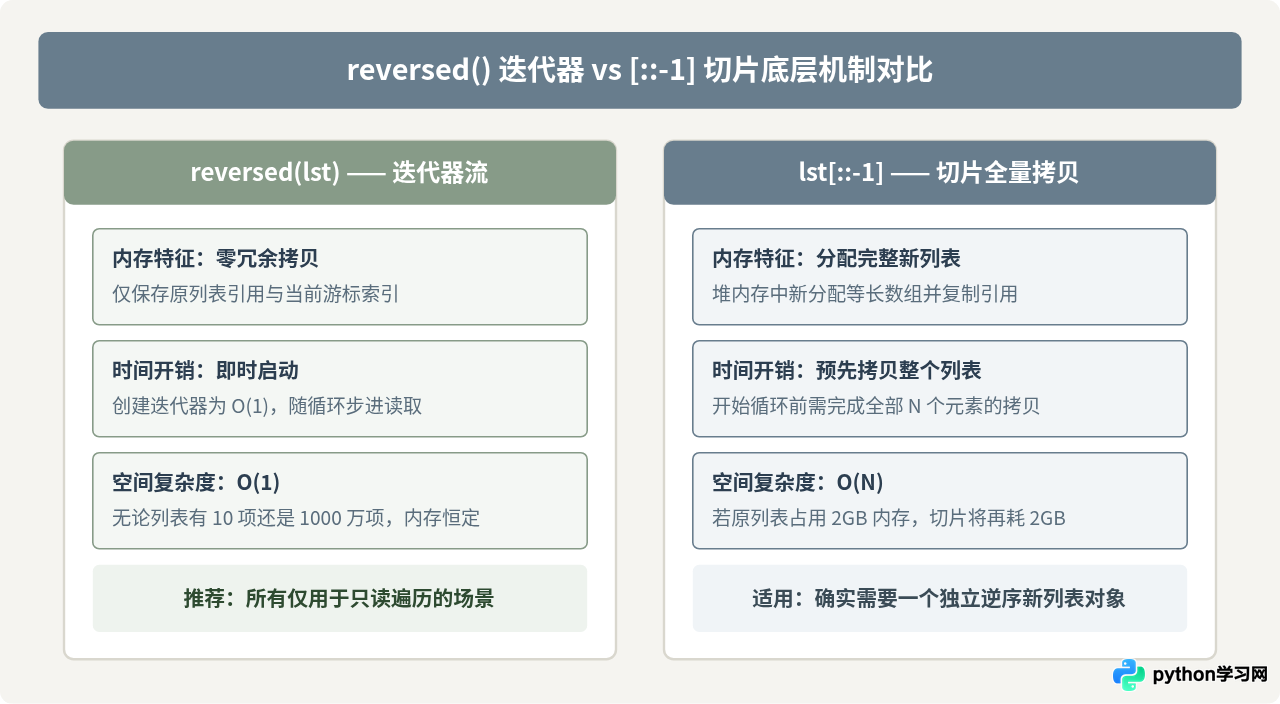
很多初学者会疑惑:既然 scores[::-1] 语法更简短,为什么还要使用 reversed()?两者的关键差异在于内存分配与数据持久化机制:
- 内存占用不同:
reversed(scores)只在现有列表上维护一个反向游标,没有复制元素,空间复杂度恒为O(1);而scores[::-1]会在内存中开辟一块全新的空间,把所有元素完整拷贝一份生成全新列表,空间复杂度为O(N)。 - 执行效率不同:在列表长度达到数十万或数百万时,切片拷贝不仅消耗大量额外内存,还需要耗费时间在内存分配和元素引用拷贝上;而
reversed()则是即时创建并开始逐项迭代。 - 适用目的不同:如果后续还需要保留反转后的列表独立使用(例如传参或反复查询),切片
scores[::-1]更直接;如果仅仅是为了for循环消费一遍数据,则必须优先选用reversed()。
方法三:需要索引时的反向遍历
在实际编码中,我们有时不仅要拿到元素值,还需要知道该元素在原列表中的下标位置(例如根据下标就地替换或记录位置)。
方式 1:使用 range(len(lst) - 1, -1, -1)
通过向 range(start, stop, step) 传入负步长,可以直接生成从列表末尾索引递减到 0 的序列:
# 示例:通过反向数字索引访问元素与下标
items = ["Alpha", "Beta", "Gamma"]

# 起点为 len-1,终点为 -1 (不含),步长为 -1
for i in range(len(items) - 1, -1, -1):
print(f"索引 {i} -> 对应值 {items[i]}")索引 2 -> 对应值 Gamma
索引 1 -> 对应值 Beta
索引 0 -> 对应值 Alpha
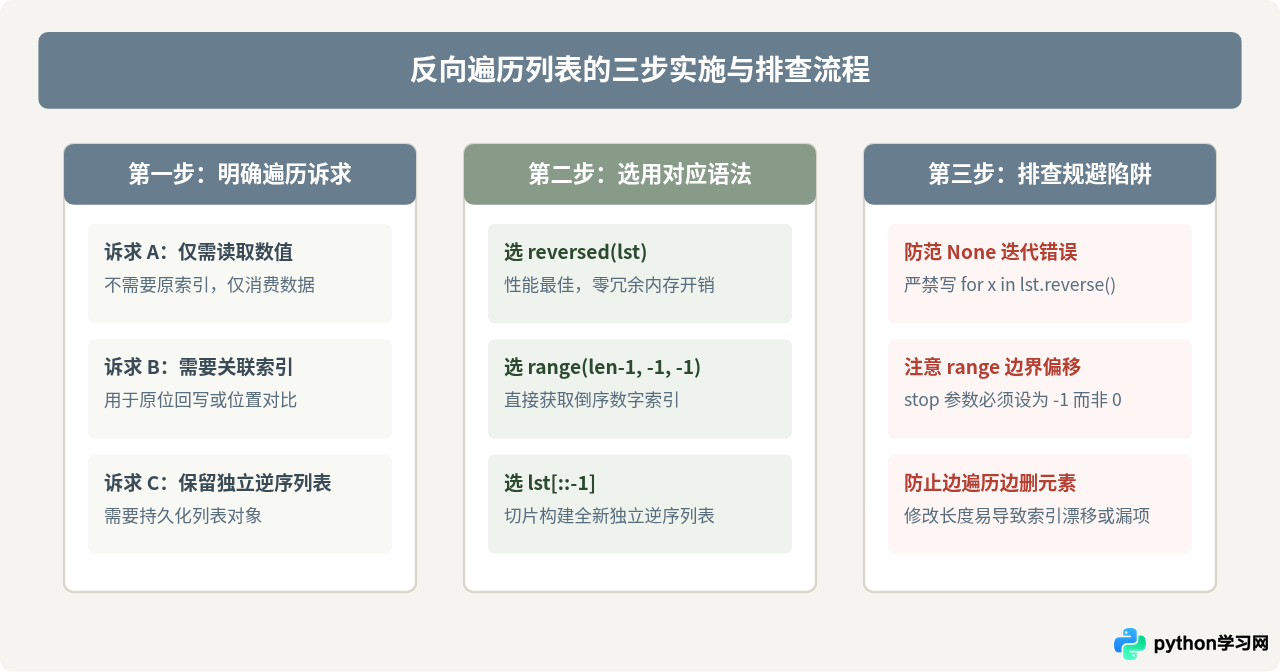
range() 生成的区间是左闭右开的。由于要遍历到索引 0,因此 stop 参数必须写为 -1,不能写成 0,否则循环会在到达索引 1 时提前停止。
方式 2:使用 enumerate 配合 reversed()
如果不习惯手写容易混淆的 range 负索引参数,可以先用 enumerate() 将列表打包为 (索引, 元素) 元组,再整体调用 reversed():
# 示例:使用 reversed(list(enumerate(items)))
items = ["Alpha", "Beta", "Gamma"]

for idx, val in reversed(list(enumerate(items))):
    print(f"原索引 {idx} -> 对应值 {val}")
这种方式代码语义更清晰,不容易在 range 的上下界边界值上犯错。
常见误区与注意事项
误区一:混淆 list.reverse() 与 reversed()
这是 Python 初学者极易踩中的高频语法陷阱。列表的方法 list.reverse() 是一个原地修改(In-place)操作,它的返回值是 None,而不是反转后的列表:
# 错误示范:在 for 循环中直接调用 lst.reverse()
data = [1, 2, 3]

# 抛出异常:TypeError: 'NoneType' object is not iterable
for item in data.reverse():
print(item)data.reverse(),再正常遍历 for item in data:;如果仅仅是反向访问而不改变原列表,请使用 for item in reversed(data):。
误区二:在反向遍历过程中随意删除或插入元素
在正向 for 循环中通过 remove() 或 pop() 删除元素会导致索引漂移,导致漏项。虽然使用倒序索引在删除元素时相对安全(因为删除末尾元素不会影响前序索引),但如果直接在 reversed(lst) 迭代器驱动的循环内部删除元素,依然可能引发预期之外的遍历错乱。最安全可靠的策略是使用列表推导式过滤生成新列表:
# 推荐做法:通过条件过滤生成过滤后的列表,而非在循环中边遍历边删除
raw_data = [12, -5, 45, -3, 80]
filtered = [x for x in reversed(raw_data) if x >= 0]
print(filtered)  # 示例输出:[80, 45, 12]
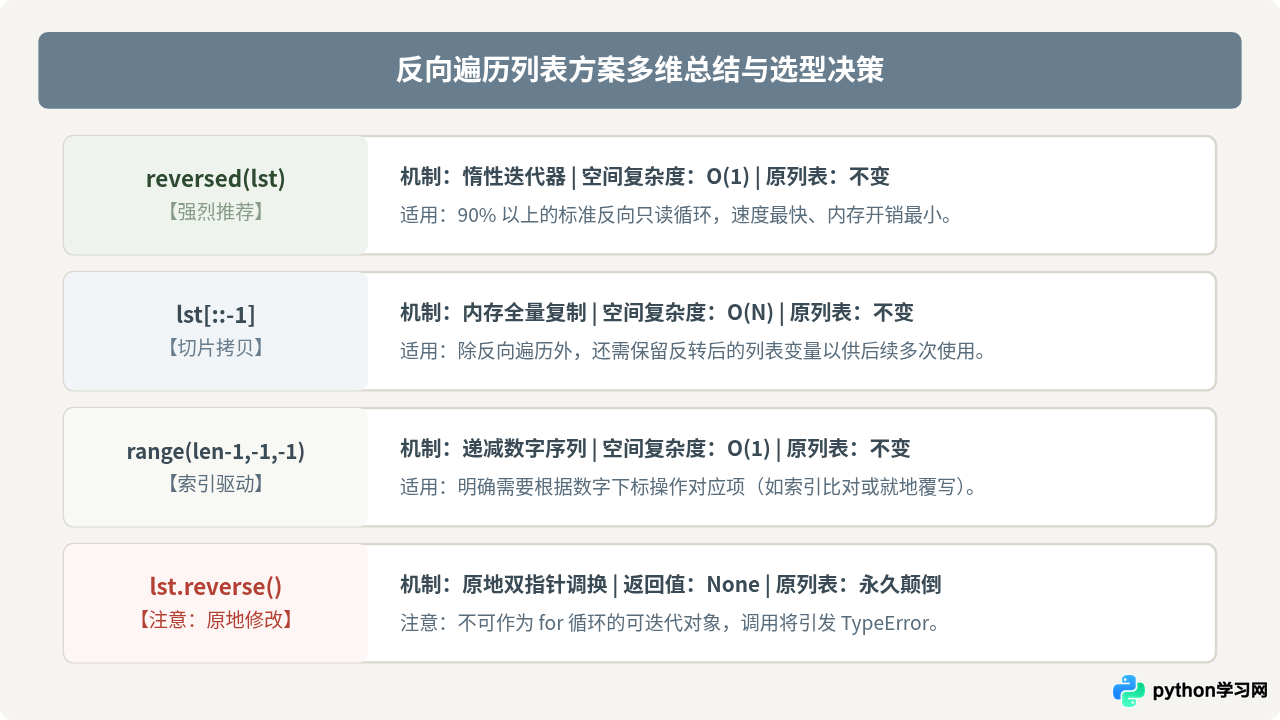
反向遍历常用方法综合对比与选型建议
为了帮助大家在日常编码中快速决断,下表汇总了四种处理方式的各维度指标:
| 语法写法 | 时间复杂度 | 额外空间 | 原列表状态 | 主要应用场景 |
|---|---|---|---|---|
for x in reversed(lst): |
O(N) | O(1) | 完全不变 | 最推荐。常规从后向前读取数据,性能最高。 |
for x in lst[::-1]: |
O(N) | O(N) | 完全不变 | 不仅要遍历,还需后续长期持有逆序新列表副本。 |
for i in range(len-1, -1, -1): |
O(N) | O(1) | 完全不变 | 需要精确掌控原列表下标进行定位或原地修改。 |
lst.reverse() |
O(N) | O(1) | 原地改变 | 需要永久改变列表顺序,注意不能直接放在 for in 后面。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









