

Python虚拟环境能直接调用本地GPU吗
深入解答Python虚拟环境能否直接调用本地GPU,详细阐述虚拟环境的隔离机制、底层驱动调用链、配置验证步骤及常见排障方法。
直接给出核心答案:能,Python虚拟环境完全可以直接调用本地GPU。Python虚拟环境(如官方内置的 venv、第三方常用的 virtualenv 或 conda)本质上只是对解释器路径和第三方库依赖目录的隔离机制,它并不是硬件隔离的沙盒虚拟机。只要宿主机安装了与物理显卡兼容的官方驱动,并且虚拟环境中安装了具备GPU支持的计算库(如适配CUDA的PyTorch或TensorFlow),Python代码就能无缝利用本地GPU算力执行计算。
一、核心原理:虚拟环境的隔离机制与GPU调用链
很多初学者之所以担心“虚拟环境调用不到GPU”,往往是因为把Python虚拟环境与传统的虚拟化技术(如VirtualBox、VMware等完整虚拟机)混淆了。完整虚拟机会虚拟出一整套CPU、内存和外设总线,宿主机的PCIe物理显卡默认无法穿透进入客户机操作系统。但Python虚拟环境的工作机制截然不同。
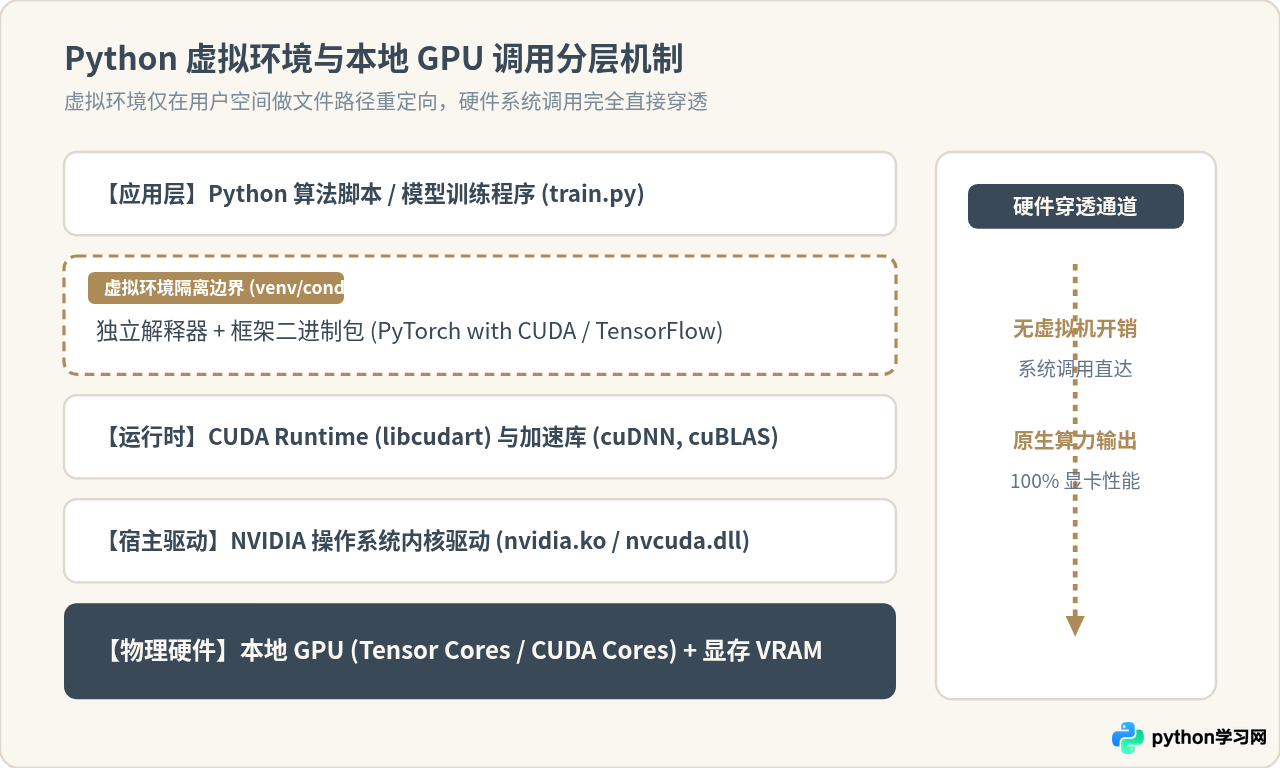
Python虚拟环境的全部秘密,仅仅在于改变了环境变量 PATH 和模块搜索路径 sys.path。当激活虚拟环境时,终端只是优先调用了该目录下的Python可执行程序,并把 pip install 下载的软件包限制存放在该目录的 site-packages 文件夹中。对于操作系统内核、系统系统调用接口以及硬件驱动程序,虚拟环境中的进程与直接在宿主机上运行的普通Python进程处于完全平等的地位。
在深度学习框架调用本地GPU的完整链路中,硬件访问呈现自上而下的穿透结构:
- Python应用层:用户编写的模型代码,发起张量运算与设备调度指令。
- 依赖框架层(位于虚拟环境):包含PyTorch或TensorFlow等Python接口及底层的C++核心动态链接库。
- 运行时加速库:框架捆绑或系统安装的CUDA Runtime(libcudart)和深度学习加速库(cuDNN)。
- 操作系统驱动层(位于宿主机系统):NVIDIA官方内核驱动(Linux下的
nvidia.ko,Windows下的nvlddmkm.sys)与用户态驱动API。 - 物理硬件层:主板PCIe插槽中的物理GPU计算核心与显存。
二、虚拟环境成功调用本地 GPU 的三个必要条件
虽然虚拟环境自身不阻碍GPU访问,但要让Python代码真正跑在显卡上,必须确保以下三个必要条件全部满足:
- 宿主机驱动完备:操作系统的硬件管理器中能识别到显卡,且已正确安装NVIDIA显卡驱动。驱动提供了用户态与内核态的通信接口(即
nvidia-smi能够正常工作)。 - 安装了GPU编译版本的计算框架:在虚拟环境中安装框架时,必须安装内置了CUDA二进制模块的版本,而不是默认的纯CPU版本。
- 驱动版本对CUDA运行时的向下兼容:NVIDIA驱动向下兼容CUDA Toolkit。宿主机驱动所支持的最高CUDA版本必须大于或等于框架内置的CUDA运行时版本。
三、实操指南:从创建环境到 GPU 验证的完整步骤
以下按照标准工业实践,演示如何在Linux或Windows终端中完成从环境搭建到GPU调用的完整过程。
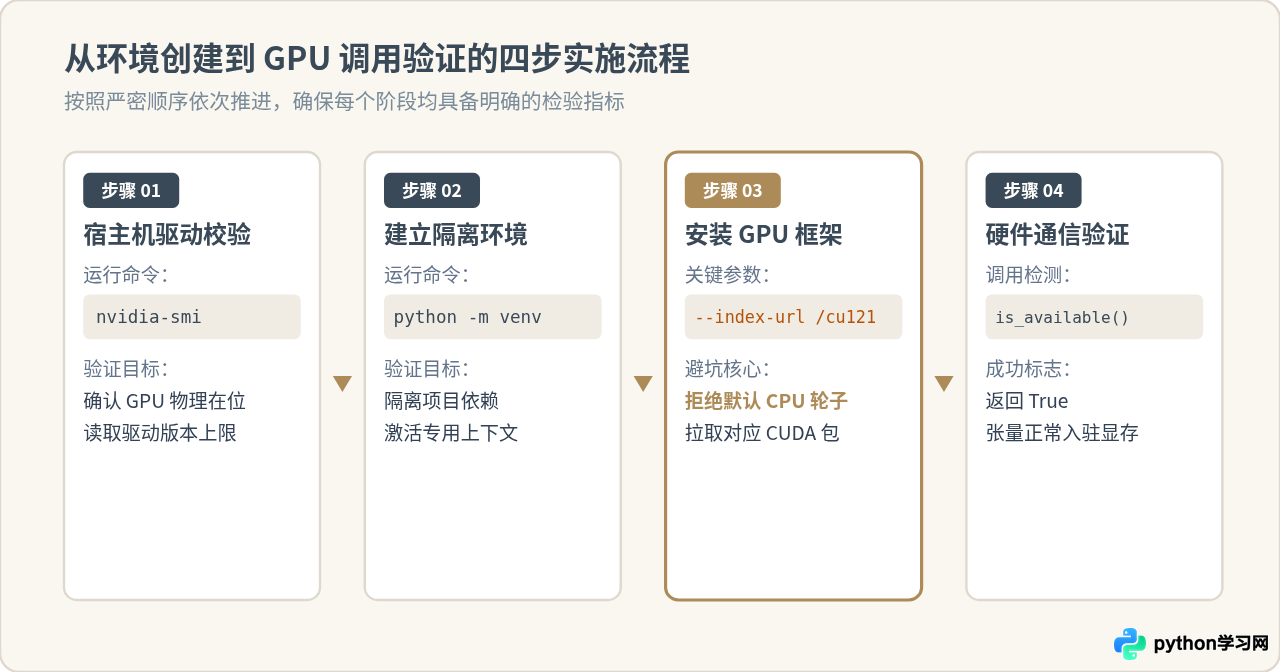
步骤 1:在宿主机终端检查驱动与显卡状态
首先打开系统终端(Windows使用PowerShell或CMD,Linux使用Bash),输入以下命令检查本地显卡:
nvidia-smi若终端输出类似以下结果表格,说明物理GPU与底层驱动均已就绪。请重点关注右上角的 CUDA Version: 12.4,这代表当前驱动最高可支持CUDA 12.4版本的框架运行:
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 550.54.14              Driver Version: 550.54.14      CUDA Version: 12.4     |
|-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 4090        Off |   00000000:01:00.0 Off |                  Off |
| 31%   38C    P8             18W /  450W |       0MiB /  24564MiB |      0%      Default |
+-----------------------------------------+------------------------+----------------------+
步骤 2:创建并激活隔离的 Python 虚拟环境
使用Python自带的 venv 模块创建名为 dl_env 的独立环境:
# Linux / macOS 环境下
python3 -m venv dl_env
source dl_env/bin/activate

# Windows PowerShell 环境下
python -m venv dl_env
.\dl_env\Scripts\Activate.ps1
激活后,命令行提示符前方会出现 (dl_env) 前缀,证明当前所有包安装与执行都已被约束在该环境中。
步骤 3:在虚拟环境中安装支持 GPU 的计算框架
这是绝大多数人踩坑的关键步骤。如果在激活虚拟环境后直接执行 pip install torch,在部分操作系统或网络源下,pip可能会默认拉取无CUDA模块的轻量级CPU版本。必须显式指定PyTorch官方的CUDA专用源:
# 安装适配 CUDA 12.1 的 PyTorch GPU 完整版
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
步骤 4:编写最小化验证脚本测试 GPU 通信
在虚拟环境中执行以下单行Python代码,验证PyTorch是否成功探测并驱动本地GPU:
python -c "import torch; print('CUDA 可用性:', torch.cuda.is_available()); print('显卡型号:', torch.cuda.get_device_name(0) if torch.cuda.is_available() else '无可用GPU')"进一步,可以通过一段简短脚本分配显存并执行一次张量矩阵乘法运算:
import torch

if torch.cuda.is_available():
    device = torch.device("cuda:0")
    print(f"正在使用设备: {torch.cuda.get_device_name(device)}")

    # 在 GPU 显存中创建两个 4096 x 4096 的张量并执行矩阵乘法
    x = torch.randn(4096, 4096, device=device)
    y = torch.randn(4096, 4096, device=device)
    z = torch.matmul(x, y)

    # 打印当前分配的显存量
    allocated_mb = torch.cuda.memory_allocated(device) / (1024 ** 2)
    print(f"矩阵计算完成,当前占用显存: {allocated_mb:.2f} MB")
else:
    print("未检测到可用的 GPU 设备,请检查驱动与框架版本。")
当输出显示显卡具体型号(如 NVIDIA GeForce RTX 4090)且显存成功分配时,即完全证明虚拟环境已经直接且高效地调用了本地GPU。
四、机制辨析:Python 虚拟环境与 Docker 容器在 GPU 访问上的差异
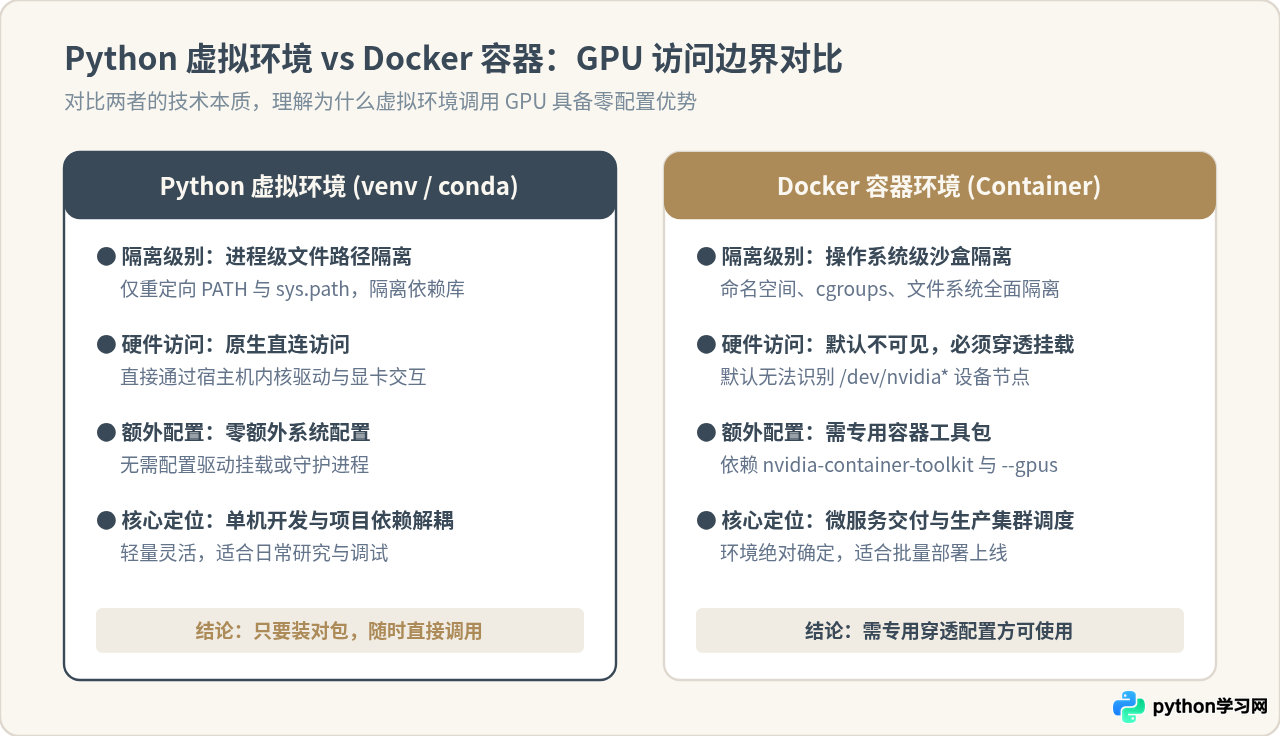
为了加深理解,对比一下深度学习中另一项常用隔离工具——Docker容器。很多开发者在容器中跑GPU任务时经历过复杂的排错,因此误以为虚拟环境也同样复杂。实际上两者的底层隔离边界完全不同:
- Python 虚拟环境:仅在进程层重定向路径。它不隔离 Linux 命名空间(Namespaces),不限制 cgroups,不拦截
/dev/nvidia*设备文件。因此,只要安装了支持GPU的库,它对GPU的调用完全是原生、零配置、无障碍穿透的。 - Docker 容器:属于操作系统级隔离。容器内部默认拥有独立的设备树与命名空间,根本看不到宿主机的物理显卡设备节点。为了在容器中使用GPU,必须在宿主机安装
nvidia-container-toolkit,并在启动容器时显式声明--gpus all参数进行设备映射挂载。
五、为什么有时在虚拟环境中会提示“找不到 GPU”?高频排查排障
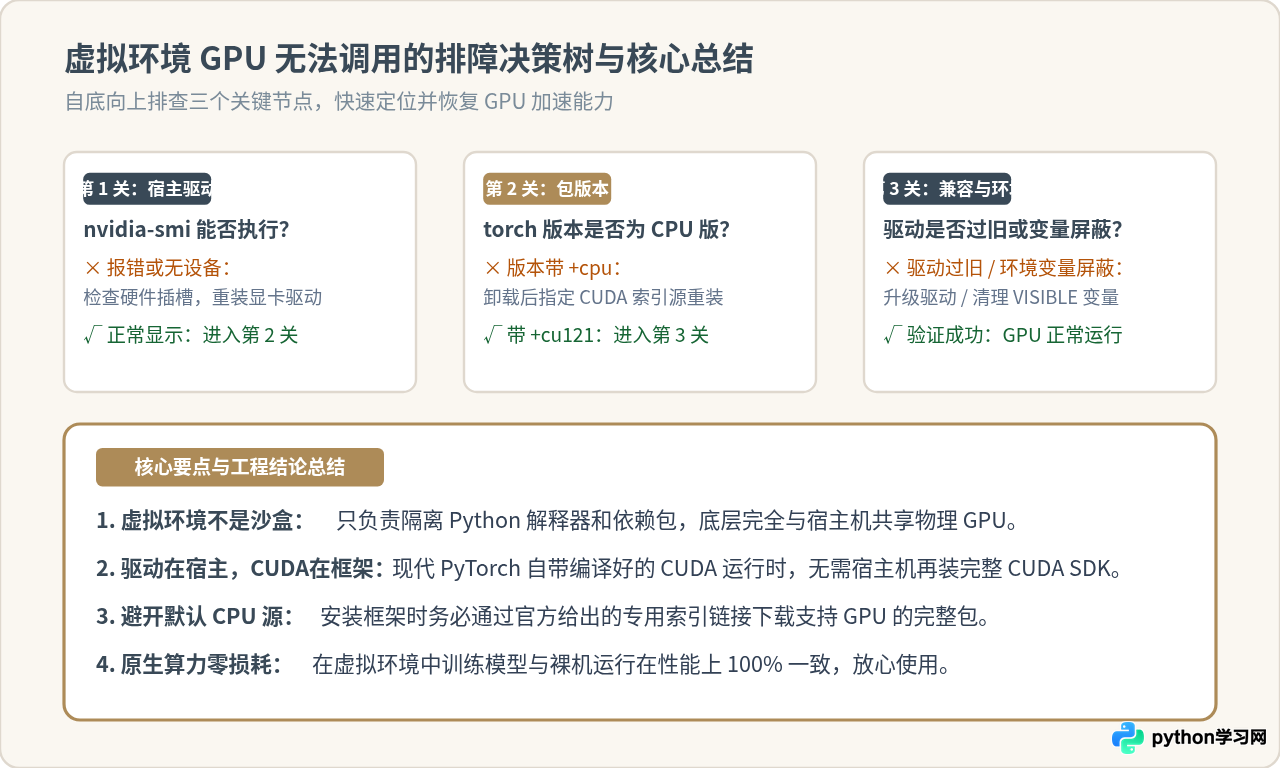
如果读者在自己的虚拟环境中测试 torch.cuda.is_available() 时返回了 False,请不要怀疑虚拟环境本身的能力。根据实际运维经验,99% 的问题都可以通过以下三个排查点快速定位:
在激活的虚拟环境中运行 python -c "import torch; print(torch.__version__)"。如果版本号末尾带有 +cpu(例如 2.2.0+cpu),说明当前包根本没有编译CUDA算子与驱动通信模块。解决方法是卸载后重新按照官方提供的带 --index-url 的命令重新安装。
如果虚拟环境安装了 CUDA 12.1 版本的 PyTorch,但宿主机显卡驱动版本过旧(例如驱动支持的 CUDA 版本最高仅为 11.4),PyTorch 在初始化 CUDA 上下文时便会直接报错失败。解决方法是前往 NVIDIA 官网将显卡驱动升级到稳定新版本。
如果在当前终端或脚本中设置了 CUDA_VISIBLE_DEVICES="" 或设置了不存在的设备索引(如 CUDA_VISIBLE_DEVICES="1" 但系统只有单卡),CUDA 运行时会自动隐藏所有物理设备。可在 Python 中运行 import os; print(os.environ.get('CUDA_VISIBLE_DEVICES')) 确认当前可见性配置。
六、工程实践建议
在日常AI研究与工程实践中,推荐遵循“宿主机保持单一且较新的稳定显卡驱动,项目按需创建独立Python虚拟环境并安装特定CUDA版框架”的分层原则:
- 宿主机只需维护一个支持较新CUDA标准的显卡驱动,无需在操作系统全局安装乱七八糟的多个CUDA Toolkit。
- 每个算法项目建立一个专属的虚拟环境,有的项目安装适配 CUDA 11.8 的 PyTorch,有的项目安装适配 CUDA 12.1 的 PyTorch。由于现代深度学习框架在打包时已经将运行时动态库(CUDART、cuDNN等)内嵌进Python包中,不同的虚拟环境之间互不干扰,却能同时完美调用同一张物理显卡。
综上所述,Python虚拟环境不仅能够直接调用本地GPU,而且凭借其无虚拟化开销、依赖隔离干净、配置轻巧的优势,是开展本地深度学习和GPU计算的首选开发模式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









