

Python openpyxl不加载数据直接获取Excel最大行数
在处理数十兆甚至数百兆的庞大 Excel 工作簿时,默认的加载方式会一次性将单元格全部载入内存,极易造成程序卡顿甚至内存溢出。最直接且高效的解决方案是在调用 openpyxl.load_workbook() 时开启 read_only=True 模式,随后直接读取工作表的 max_row 属性。这种方式利用了工作表底层的元数据标记,无需构建单元格对象即可在毫秒级内获取行数。
一、常规模式的性能瓶颈与只读模式原理
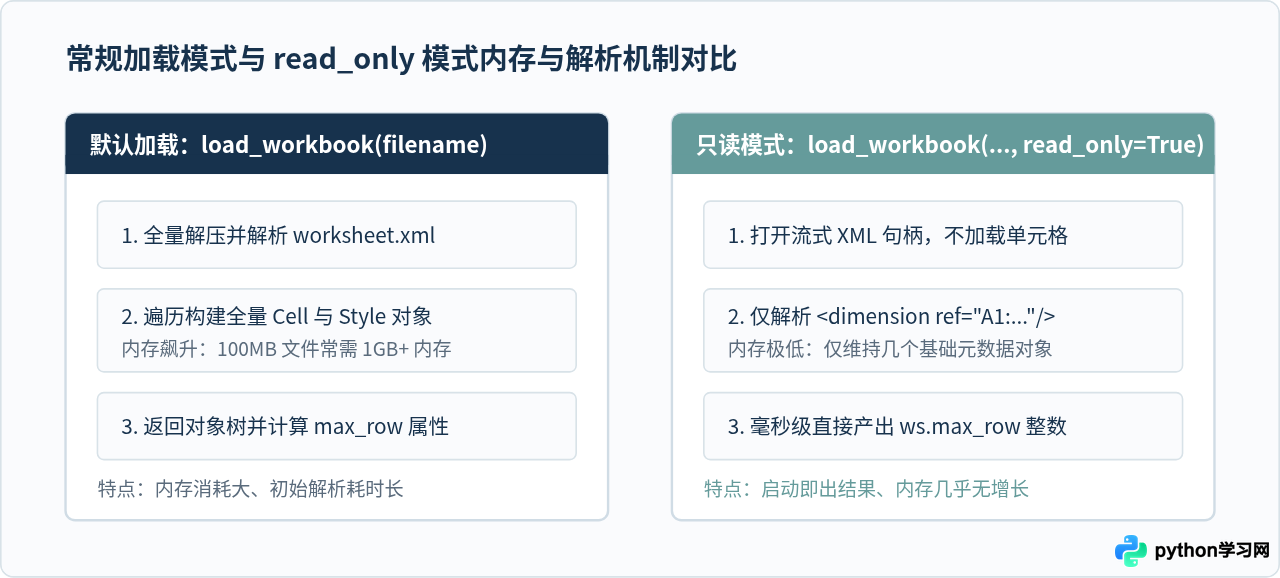
日常使用 openpyxl 读取表格时,很多读者习惯直接调用 wb = openpyxl.load_workbook("data.xlsx")。在默认情况下,openpyxl 会以 DOM 树的形式解析整个工作表 XML 文件,为每一个非空单元格实例化 Python 的 Cell 对象,并同步解析字体、颜色、边框和公式等样式信息。对于包含几十万行数据的表格,这种解析行为会占用数百兆至数吉字节的内存,耗时往往在数秒甚至数十秒以上。
如果业务诉求仅仅是判断数据规模、记录处理进度或为后续分页提供总行数依据,完全不需要解析具体内容。openpyxl 提供了 read_only=True 参数。开启只读模式后,工作簿进入流式惰性加载状态,底层只解析工作表的骨架信息。Excel 文件本身是一个 zip 压缩包,其内部工作表 XML 的顶部通常包含一个 <dimension ref="A1:F50000"/> 标记,用来记录当前表格的数据边界。openpyxl 在只读模式下读取 ws.max_row 时,会优先从该元数据标签中提取行号,因此耗时极短,内存占用基本保持恒定。
二、标准操作步骤与代码实现
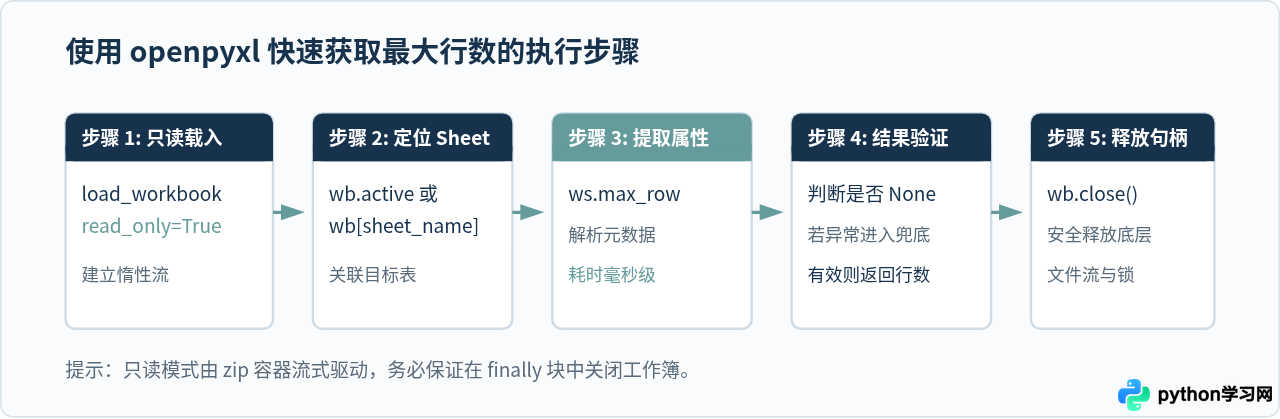
在实际编码中,直接获取最大行数的操作非常简洁。核心步骤分为:引入库、只读加载、指定工作表、读取属性、关闭文件。以下是完整的推荐代码范例:
import openpyxl

def get_excel_max_row_fast(file_path, sheet_name=None):
    """
    通过只读模式快速获取 Excel 工作表的最大行数
    """
    # 步骤 1:以 read_only=True 打开工作簿,跳过单元格解析
    wb = openpyxl.load_workbook(file_path, read_only=True, data_only=True)
    try:
        # 步骤 2:获取指定工作表或默认活跃工作表
        if sheet_name:
            ws = wb[sheet_name]
        else:
            ws = wb.active

        # 步骤 3:直接读取维度元数据属性 max_row
        row_count = ws.max_row
        return row_count
    finally:
        # 步骤 4:显式关闭工作簿以释放文件底层句柄
        wb.close()

# 示例调用
if __name__ == "__main__":
    path = "large_dataset.xlsx"
    total_rows = get_excel_max_row_fast(path)
    print(f"表格最大行数为: {total_rows}")
在这段代码中,有两处细节需要特别注意:
- 必须调用
wb.close():在默认模式下,openpyxl 读取完毕后会关闭内部文件流。但在read_only=True模式下,底层采用延迟流式读取,文件句柄始终处于占用状态。如果在循环中处理多个表格而未显式关闭,容易引发操作系统文件描述符耗尽或文件被占用的问题。使用try...finally结构能确保资源安全回收。 - 参数
data_only=True的搭配:虽然仅读取行数时公式求值不起决定性作用,但指定data_only=True可以避免库去加载复杂的公式结构,进一步降低初始开销。
三、边界陷阱与兜底处理方案
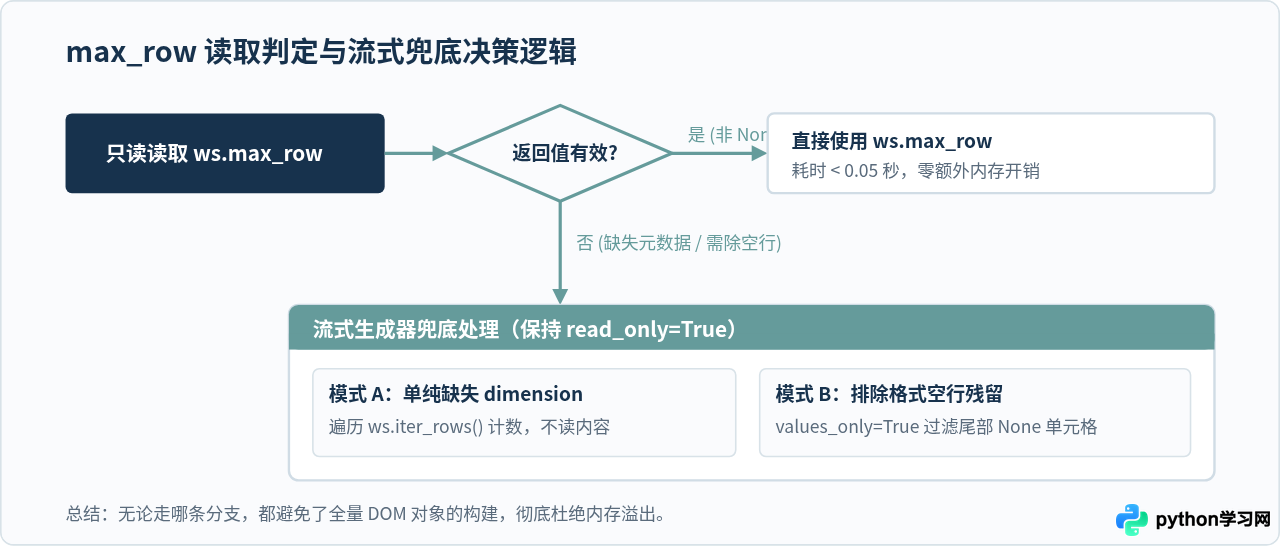
虽然通过只读模式的 ws.max_row 能解决绝大多数场景的问题,但在面对某些特殊来源的 Excel 文件时,读者可能会遇到两种典型边界问题:
1. ws.max_row 返回值为 None
当表格不是通过微软官方 Excel 正常保存,而是由部分早期版本的第三方导出组件生成,或者在生成时被剥离了维度标记时,底层 XML 中可能缺少 <dimension> 标签。在默认全量模式下,openpyxl 通过遍历所有单元格后能自动补齐行数;但在 read_only=True 模式下,由于并未预先扫描单元格,缺失该标签会导致 ws.max_row 直接返回 None。
2. 最大行数虚高(格式残留空行)
Excel 用户在日常操作中,若对大范围空行设置了背景色、边框,或仅仅选中多行按 Delete 键清除了内容而非右键“删除行”,Excel 的内部 dimension 仍会将这些带有格式样式的空行算入有效范围。此时直接读取的 max_row 会明显大于实际包含有效数据的行数。
当遇到 ws.max_row is None 或必须过滤尾部空白行时,切忌直接退回到默认的 load_workbook()。正确的做法是继续保持 read_only=True,使用 ws.iter_rows() 生成器进行流式扫描。生成器每次只产生一行数据,处理完立即丢弃,内存开销依旧在 10MB 左右,兼顾了准确度与安全性。
def get_excel_max_row_robust(file_path, sheet_name=None, check_blank=False):
    """
    兼顾缺失元数据与末尾空行的稳健行数获取函数
    """
    wb = openpyxl.load_workbook(file_path, read_only=True, data_only=True)
    try:
        ws = wb[sheet_name] if sheet_name else wb.active
        max_row = ws.max_row

        # 情况 A:元数据完备且无需过滤尾部纯空行
        if max_row is not None and not check_blank:
            return max_row

        # 情况 B:max_row 为 None 或需要排除空白行残留
        actual_max_row = 0
        if not check_blank:
            # 仅在 max_row 为 None 时流式计数,不检查内容,速度极快
            for row_idx, _ in enumerate(ws.iter_rows(), start=1):
                actual_max_row = row_idx
        else:
            # 过滤尾部纯空行:记录最后一行包含非空值的行号
            for row_idx, row in enumerate(ws.iter_rows(values_only=True), start=1):
                if any(cell is not None for cell in row):
                    actual_max_row = row_idx

        return actual_max_row
    finally:
        wb.close()
四、方案对比与技术选型总结
为了在实际项目开发中做出合理的技术选型,我们可以将 openpyxl 获取最大行数的几种常见手段进行量化横向对比:
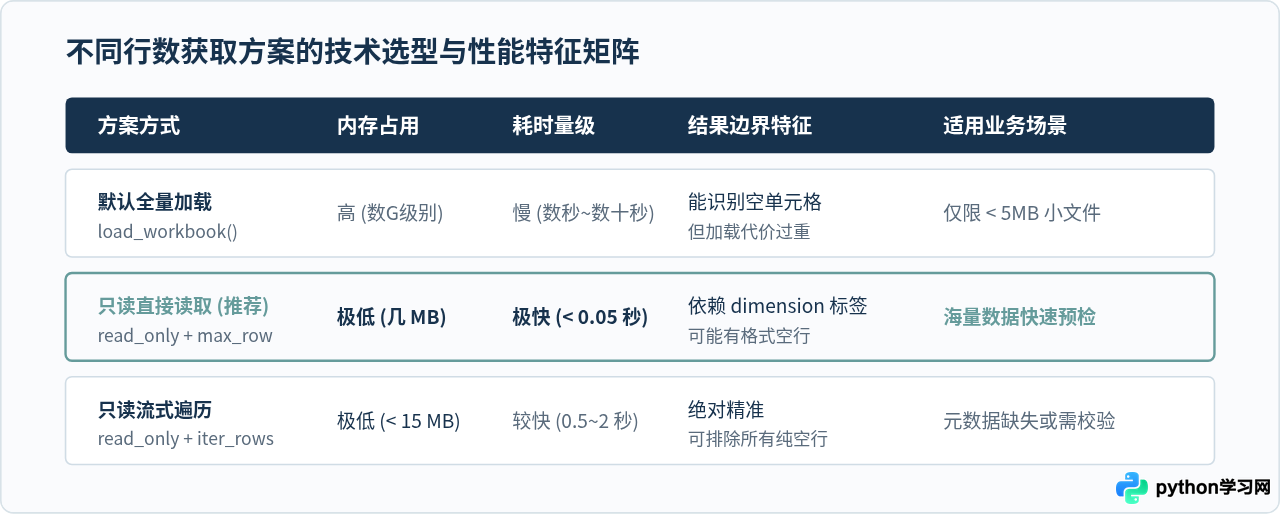
综上所述,当你的首要目标是在不加载全部数据的前提下获取 Excel 最大行数时:
- 首选方案:使用
openpyxl.load_workbook(filename, read_only=True)后直接取ws.max_row。这是性能最好、开销最小的方式。 - 必须配套:操作完成后必须显式调用
wb.close(),确保底层的 zip 句柄即时关闭。 - 遇到异常:如果
ws.max_row返回None,说明当前工作表缺少边界标记,此时通过ws.iter_rows()进行惰性计数即可安全兜底,无需退回沉重的全量加载模式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









