

Python非参数检验常见报错解决:处理NaN值、结(ties)与数据格式
在利用 Python(主要是 scipy.stats)进行非参数统计检验时,由于数据并不服从正态分布,分析者往往寄希望于非参数方法的鲁棒性。然而,在实际运行曼-惠特尼 U 检验、Wilcoxon 符号秩检验或 Kruskal-Wallis 检验时,控制台经常会抛出 ValueError、产生 nan 输出或弹出结值(ties)相关的精度警告。本文针对这三类核心问题,逐层梳理其产生的具体机制,并提供针对性的排查步骤与代码解决方案。
一、排查全景:非参数检验常见报错触发点
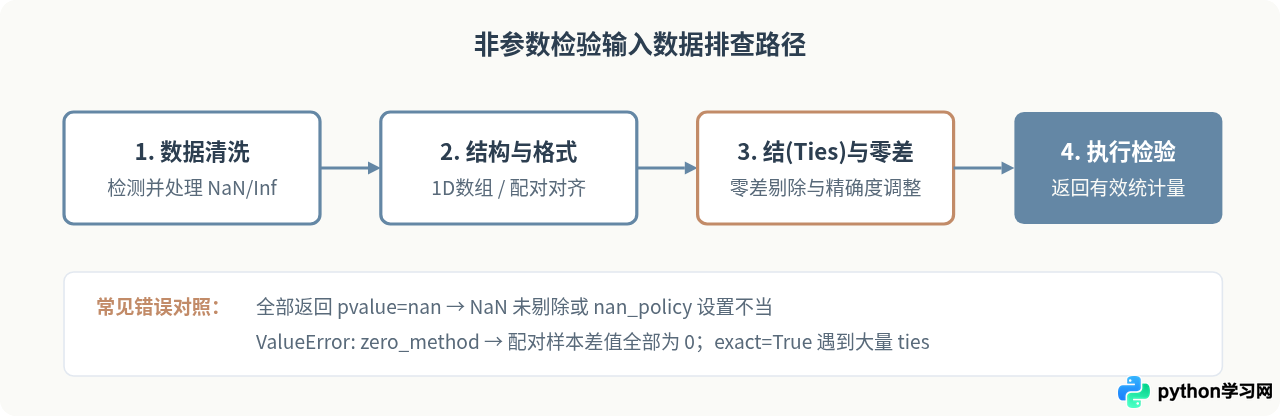
非参数检验通常依赖对原始观测值进行排序并计算秩次(Rank)。这一底层数学特性使得非参数函数对输入数据的连续性、成对性以及数值有效性有特定约束。常见的错误与警告主要集中在三处:
- 空值渗透(NaN/None):导致计算出的检验统计量和 p 值均为
nan,或者直接抛出输入验证错误。 - 相同数值与结值(Ties):多组相同数值在计算中被赋予平局秩(tied ranks),使得默认的精确分布算法失效,触发渐近近似警告或零差值报错。
- 数据格式错配(Format & Shape):长宽表转换不当、传入非一维数组,或者包含未转换的字符串类型。
二、NaN 与缺失值报错:污染链与解决参数
在默认配置下,scipy.stats 中的多数统计函数对 NaN 采用“传播”(propagate)策略。只要样本中存在一个 np.nan,排序阶段的比较操作就会失效,最终返回 MannwhitneyuResult(statistic=nan, pvalue=nan),而不会直接抛出异常中断运行,这极易导致后续分析静默出错。
1. 使用 nan_policy 参数
在较新版本的 scipy.stats 中,如 mannwhitneyu 和 kruskal,函数原生提供了 nan_policy 参数,可选值包括:
'propagate'(默认):存在 NaN 时直接返回包含 nan 的统计结果。'raise':一旦输入含 NaN 即主动抛出ValueError,方便提早截获异常。'omit':在计算前自动滤除各组内的 NaN 值。
import numpy as np
from scipy import stats

group_a = np.array([12.3, 14.5, np.nan, 18.2, 15.0])
group_b = np.array([10.1, 11.8, 13.5, 12.0])

# 默认情况下会输出 nan
res_default = stats.mannwhitneyu(group_a, group_b)
print("默认行为:", res_default)
# 示例输出: MannwhitneyuResult(statistic=nan, pvalue=nan)

# 指定 nan_policy='omit' 自动剔除
res_clean = stats.mannwhitneyu(group_a, group_b, nan_policy='omit')
print("剔除缺失值:", res_clean)
# 示例输出: MannwhitneyuResult(statistic=18.0, pvalue=0.0317...)
注意成对检验的陷阱:在进行 stats.wilcoxon 等成对非参数检验时,不能对两组分别简单执行 group[~np.isnan(group)]。成对数据必须保证 index 对齐,剔除时必须同时丢弃在任一侧出现 NaN 的对应观测对(成对完全案例分析),否则会导致样本量失配并错位。
# 配对样本的正确清洗方式
before = np.array([20.1, np.nan, 22.4, 25.0, 19.8])
after  = np.array([18.5, 17.2,  21.0, 24.5, np.nan])

# 构建有效掩码
valid_mask = (~np.isnan(before)) & (~np.isnan(after))
clean_before = before[valid_mask]
clean_after = after[valid_mask]

# 执行 Wilcoxon 检验
res_wilcoxon = stats.wilcoxon(clean_before, clean_after)
print("配对清理后检验结果:", res_wilcoxon)
三、结值(Ties)与零差值:原理差异与参数调节
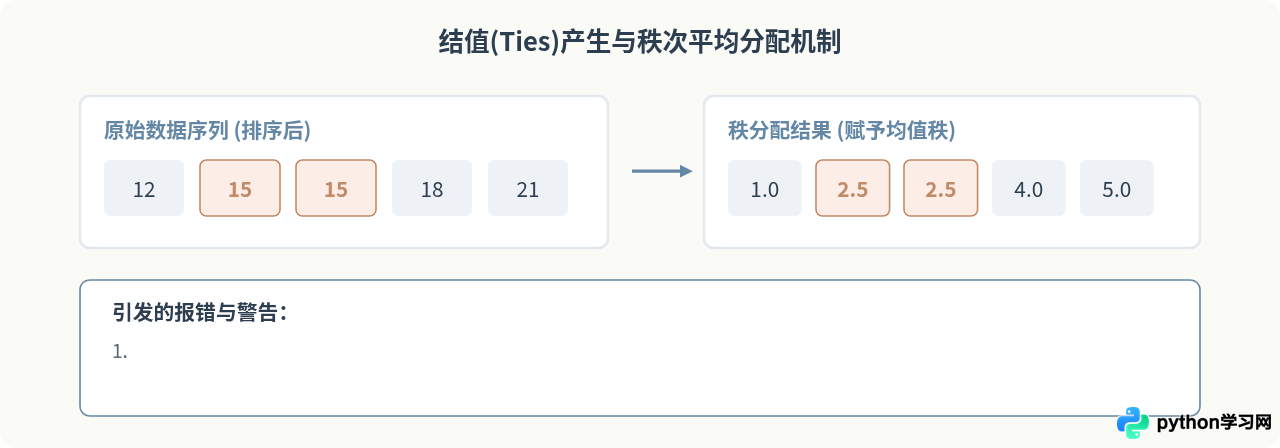
“结”(ties)指的是数据集中存在多个完全相同的取值。在正态分布检验中,连续变量理论上不会出现完全相等的两点,但在实际业务、问卷打分或低精度测量中,重复值极为常见。非参数检验分配秩次时,需要为平局值计算平均秩(Average Rank),这会对统计量的方差带来修正影响。
1. exact 参数与渐近近似
在样本量较小(如每组小于 20)时,mannwhitneyu 默认尝试使用 method="exact" 来计算精确 p 值。然而,当数据中出现结(ties)时,精确算法的组合分布假设被打破。SciPy 会回退到渐近正态近似或发出警告。显式声明计算方式可以避免非预期行为:
# 显式指定 method 规避 ties 引起的不确定行为
x = [1, 2, 2, 3, 4]
y = [2, 3, 3, 5, 6]

# 当存在结值时,推荐明确设置为 'asymptotic' 或 'auto'
res = stats.mannwhitneyu(x, y, method='asymptotic')
print(res)
2. Wilcoxon 中的零差值(Zero Differences)
配对样本进行 Wilcoxon 检验时,若某个受试在前后两次观测中的值完全一致(如 before[i] == after[i]),差值为 0,无法直接分配符号秩。SciPy 的 wilcoxon 提供了 zero_method 参数用于处理该情况:
| 选项 | 处理逻辑 | 适用场景 |
|---|---|---|
'wilcox' (默认) |
直接丢弃差值为 0 的所有样本对,仅在非零差值上进行秩次分配 | 标准教科书做法,但若 0 很多会导致样本量锐减 |
'pratt' |
对所有样本(包含 0)赋予秩次,在最后求和统计量时剔除 0 对应的秩 | 保留整体秩分布结构,适用于具有较多平局的量表数据 |
'zsplit' |
将 0 的秩分成两半,分别平均加入正秩和负秩中 | 对称惩罚,保留全部样本量 |
特别地,如果清洗后所有观测对的差值全为 0,程序将抛出:ValueError: zero_method 'wilcox' cannot be used with zero differences only。在调用检验前,应先验证数据是否存在方差:
diff = np.array(x) - np.array(y)
if np.all(diff == 0):
    print("所有样本配对完全相同,无需进行假设检验,两组完全无差异。")
else:
    res = stats.wilcoxon(x, y, zero_method='pratt')
四、数据格式与维度陷阱
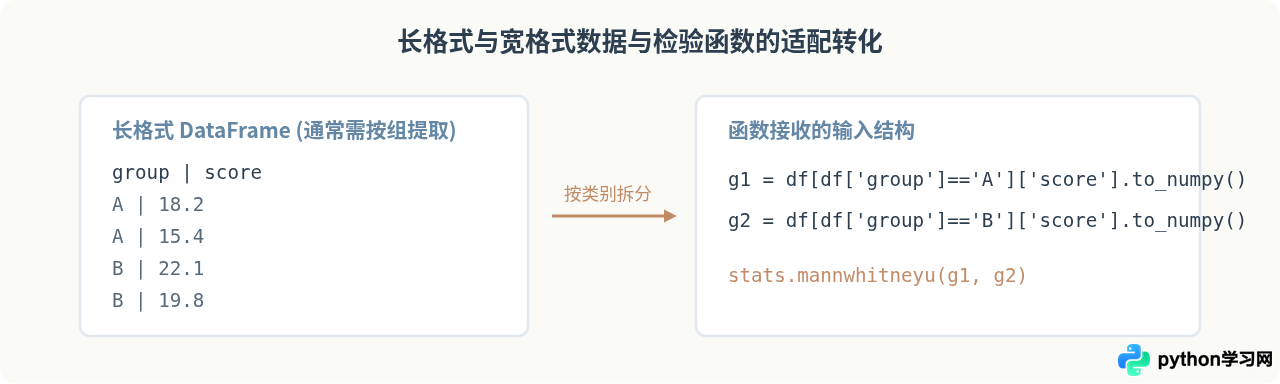
除数学条件外,数据容器的形状与类型是抛出 ValueError 最频繁的来源。
1. 混入字符串对象(Object 类型)导致比较报错
若从 CSV 文件中读取数据时存在未转义的空字符或空格,Pandas 可能会将整列解析为 object。直接调用检验会触发 TypeError: '<' not supported between instances of 'str' and 'float'。在检验前,强制转换类型:
import pandas as pd

# 强制将非数值转换为 NaN 并转为 float
clean_series = pd.to_numeric(df['metric'], errors='coerce')
2. 二维与多维数组形状不匹配
传入 df[['col']](DataFrame 二维形态)而非 df['col'](Series 一维形态)时,某些函数会因为广播机制导致维度错误。确保输入为标准一维数组:
# 保证扁平化
arr1 = np.asarray(group1).ravel()
arr2 = np.asarray(group2).ravel()
五、综合防御模板与总结
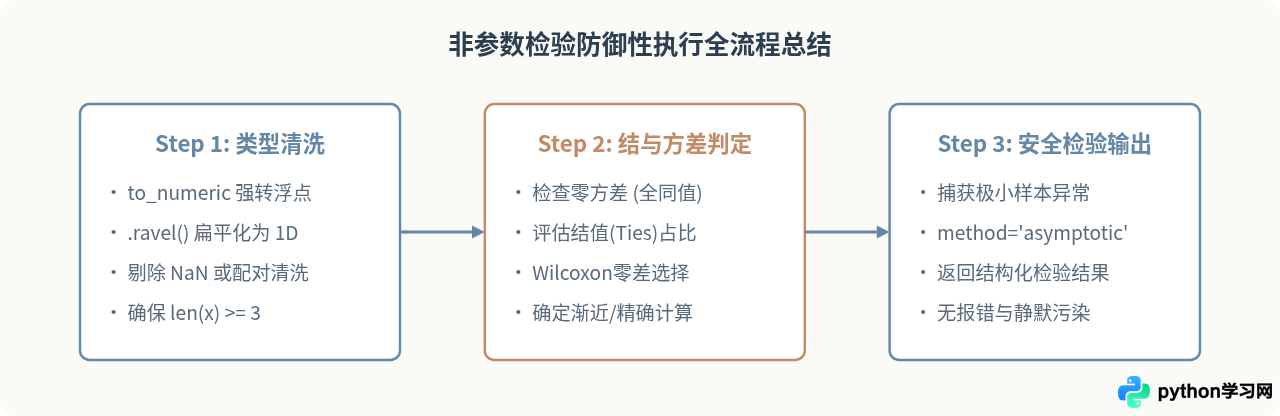
为了在工程化批处理脚本或探索性数据分析中稳定运行非参数检验,建议封装统一的安全验证前置函数:
def safe_mannwhitneyu(x, y):
    """
    鲁棒的曼-惠特尼 U 检验封装
    """
    # 1. 扁平化并清洗非数值
    x_clean = pd.to_numeric(pd.Series(x), errors='coerce').dropna().to_numpy()
    y_clean = pd.to_numeric(pd.Series(y), errors='coerce').dropna().to_numpy()

    # 2. 检查有效样本量
    if len(x_clean) < 2 or len(y_clean) < 2:
        return {"error": "样本量不足 (n < 2)", "statistic": None, "pvalue": None}

    # 3. 检查零方差情况
    if np.all(x_clean == x_clean[0]) and np.all(y_clean == y_clean[0]) and x_clean[0] == y_clean[0]:
        return {"error": "两组所有取值完全恒等", "statistic": None, "pvalue": 1.0}

    # 4. 执行检验并处理结值
    res = stats.mannwhitneyu(x_clean, y_clean, alternative='two-sided', method='auto')
    return {"error": None, "statistic": res.statistic, "pvalue": res.pvalue}
通过先行明确缺失值处理模式、主动评估数据是否存在平局与零差,并保证一维数值型数组输入,即可彻底解决 Python 非参数检验中的报错与统计量失真问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









