

Python切片省略start或stop时的默认规则
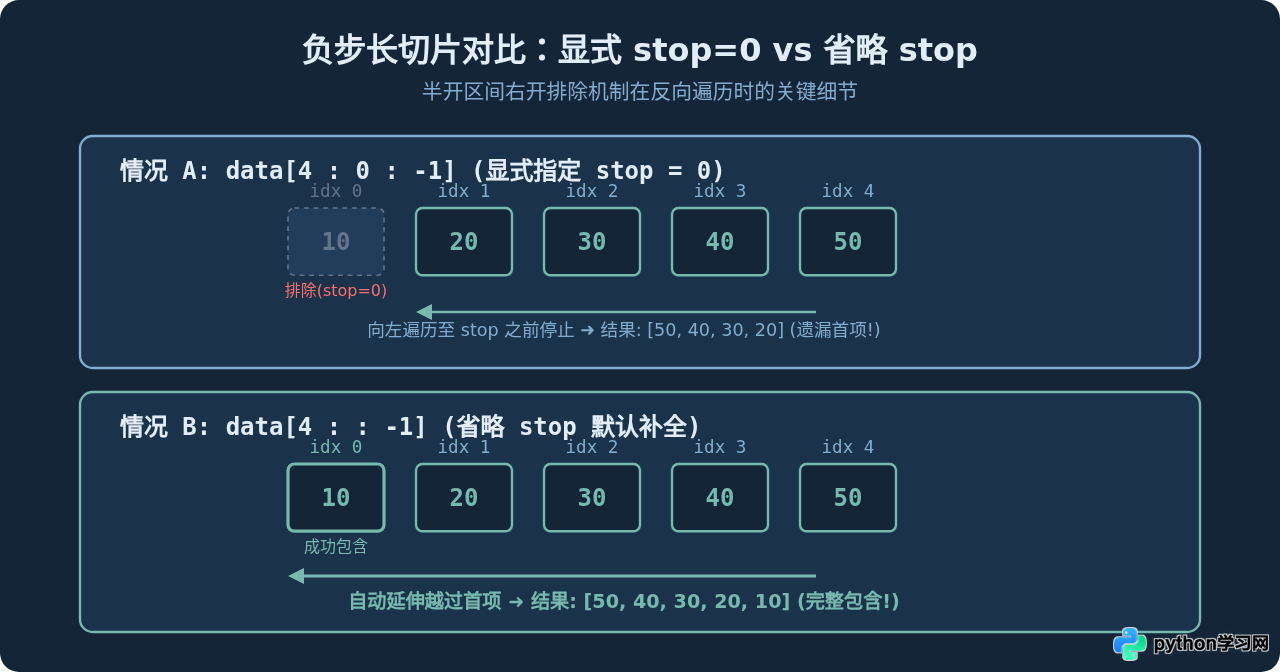
假设你正在处理一份包含五个元素的时间序列列表 timestamps = [10, 20, 30, 40, 50],你需要按从后往前的倒序提取所有数据。按照直觉,你指定切片起始为最后一位索引 4,终止为第一位索引 0,步长为 -1,写下了 timestamps[4:0:-1]。然而程序返回的却是 [50, 40, 30, 20]——位于第 0 位的值 10 神秘消失了;而如果你直接省略终止索引写成 timestamps[4::-1] 或 timestamps[::-1],第 0 项却能被完整保留。这一现象背后的核心原因在于:Python 切片在省略 start 或 stop 时的默认补全值并非固定不变,而是完全由步长 step 的正负符号决定的动态边界规则。
一、切片基本结构与半开区间的底层逻辑
在 Python 中,序列切片的通用语法形式为 sequence[start:stop:step]。这三个参数分别代表切片的起始索引、终止索引和提取步长。理解默认规则的前提,是明确切片的核心机制——左闭右开区间(Half-open Interval)。
数学上,正向切片选择 [start, stop) 结构,即包含 start 所在位置的元素,但不包含 stop 所在位置的元素。这种设计带来了两大优势:首先,切片提取出的元素个数恰好等于 stop - start(在步长为 1 时);其次,相邻两个切片 seq[:k] 与 seq[k:] 能够实现无缝拼接而互不重叠。而在代码中若不传入参数(写为冒号占位),Python 解释器就会调用默认逻辑将缺失值补齐。
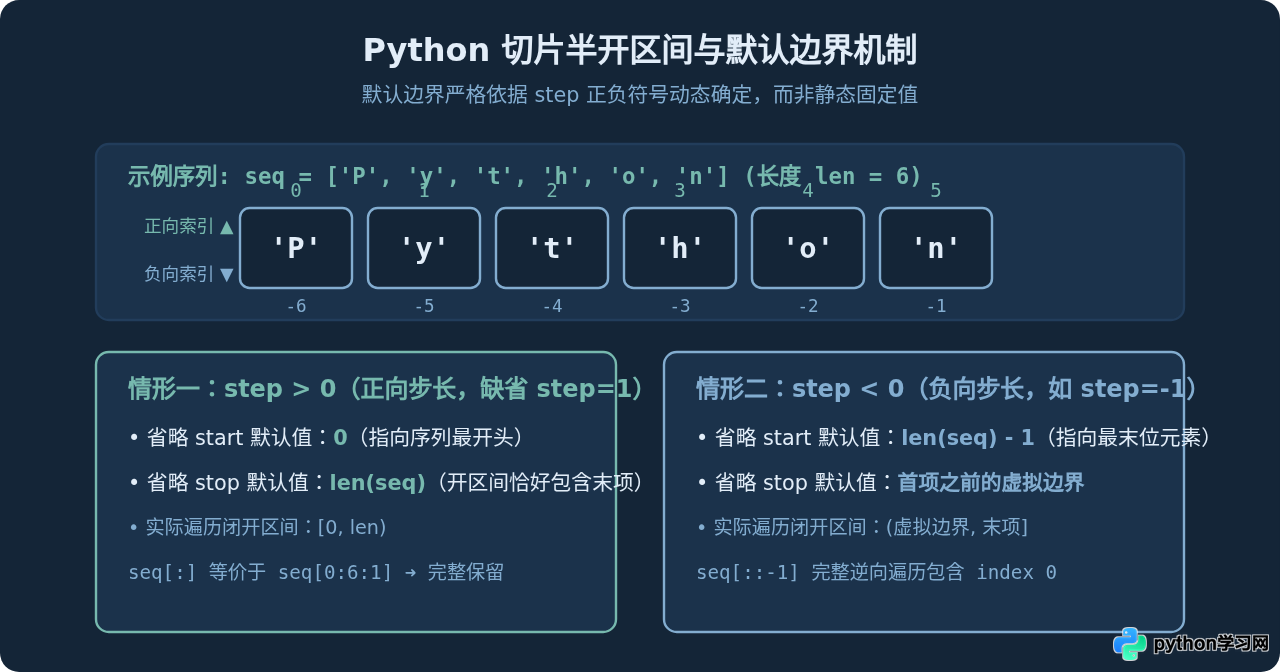
二、正向步长(step > 0)时的默认规则与实例
当切片未指定 step,或者显式指定 step > 0 时,序列遍历方向为自左向右。此时的缺省补全规则最为符合初学者的直觉:
- 省略 start:默认补全为
0。即切片从序列的首个元素开始提取。 - 省略 stop:默认补全为序列的总长度
len(sequence)。因为右边界不包含在结果中,只有将stop设为len(sequence),最后一个元素(索引为len - 1)才能被安全纳入结果。
常见正向切片代码解析
items = ['A', 'B', 'C', 'D', 'E']

# 1. 省略 start:从序列头部开始提取至索引 3 之前
print(items[:3])     # 等价于 items[0:3] ➜ ['A', 'B', 'C']

# 2. 省略 stop:从索引 2 提取至末尾(包含最后一个元素)
print(items[2:])     # 等价于 items[2:5] ➜ ['C', 'D', 'E']

# 3. 同时省略 start 和 stop:获取整个序列的浅拷贝
print(items[:])      # 等价于 items[0:5] ➜ ['A', 'B', 'C', 'D', 'E']

# 4. 指定正步长且省略边界:每间隔 1 个元素提取一个
print(items[::2]) # 等价于 items[0:5:2] ➜ ['A', 'C', 'E']初学者容易产生疑问:既然最后一个有效索引是 len - 1,为什么默认补全值不是 len - 1?原因正是半开区间的右排除特性。如果 stop 默认为 len - 1,那么 items[:] 展开为 items[0:4],最终输出将缺少末尾的 'E'。因此,必须将右边界设置为 len,才能保证完整覆盖。
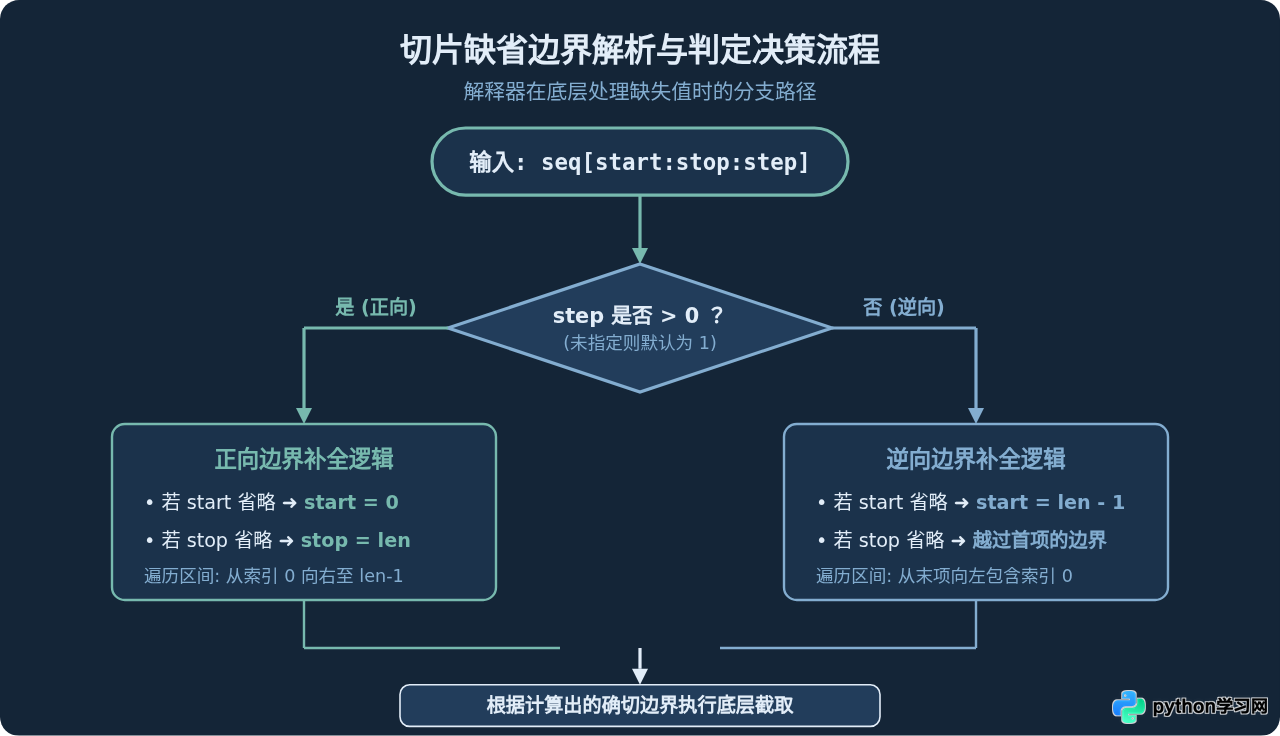
三、切片缺省边界判定的决策流程
在 Python 内部,当遇到切片语法时,解释器并非简单替换数字,而是遵循一套系统化的条件判定逻辑。下面的判定流程图清晰展示了从代码表达式输入到最终有效区间确定的完整逻辑树:
四、负向步长(step < 0)时的反向默认规则与常见陷阱
当 step 小于 0 时,切片的提取顺序被彻底反转为自右向左。此时很多开发者容易产生思维定势,误以为省略 start 依然代表 0。但如果从 0 开始并以负步长向左移动,切片只会立刻撞上边界而得到空列表。
负步长下的两大反转规则
- 省略 start 时的默认值:自动设为
len(sequence) - 1(即末尾元素的索引)。切片将从序列的最后一个元素开始反向提取。 - 省略 stop 时的默认值:自动设为“越过第 0 位”的特殊边界标记(在 CPython 底层表现为负方向延伸至第 0 位左侧)。这确保了当遍历到达索引
0时,索引0的元素依然能被包含进来。
这是最容易产生 Bug 的场景。根据半开区间定义,切片到达 stop 时会立即终止且不包含 stop 自身。如果写成 seq[4:0:-1],当游标递减到 0 时,0 处的元素被排除在外,提取在 1 处就截断了!若想完整反向提取至第 0 项,必须将 stop 留空(例如 seq[4::-1])或者显式传递 None(例如 seq[4:None:-1])。
五、CPython 底层实现验证:slice.indices()
在 Python 中,切片语法 seq[start:stop:step] 本质上是构建了一个内置的 slice 对象并传递给对象的 __getitem__ 方法:
# 以下两种写法完全等价:
res1 = seq[start:stop:step]
res2 = seq[slice(start, stop, step)]
当参数被省略时,传递给 slice 构造函数的值实际上就是 None。想要精确查看 Python 是如何将包含 None 的切片映射为真实的整数索引,可以使用 slice.indices(length) 方法。该方法接收一个序列长度,并返回标准规范化后的 (start, stop, step) 三元组:
length = 5  # 对应长度为 5 的序列

# 1. 验证常规正向切片 items[:]
s1 = slice(None, None, None)
print(s1.indices(length))
# 输出结果: (0, 5, 1) -> 确认 start=0, stop=5, step=1

# 2. 验证正向省略 stop: items[2:]
s2 = slice(2, None, None)
print(s2.indices(length))
# 输出结果: (2, 5, 1) -> 确认 stop=5 (即 len)

# 3. 验证逆向反转 items[::-1]
s3 = slice(None, None, -1)
print(s3.indices(length))
# 输出结果: (4, -1, -1) -> start 映射为 4 (len-1), stop 映射为 -1
请特别注意第 3 个输出中的 stop = -1。在正向索引中,-1 表示末尾元素;但在步长为 -1 的负向迭代循环中(等价于 for (i = 4; i > -1; i--)),循环结束的条件是 i > -1,因此 i = 0 可以被顺利执行。这也从源码机制层面彻底证实了为什么省略 stop 能完美囊括第 0 位。
六、切片缺省规则速查全景与速记口诀
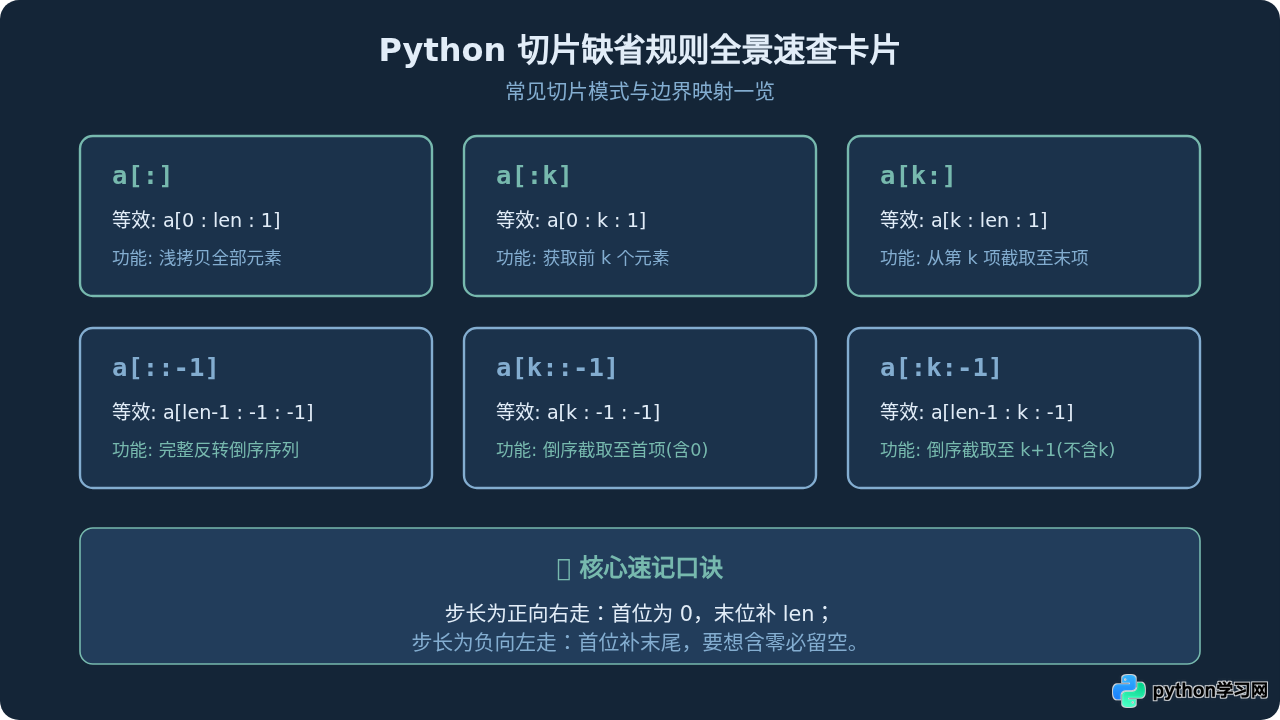
为了在实际编码中不再混淆边界,下表整理了各种常见切片缺省形态的等效展开及其实际行为:
| 语法形式 | 步长方向 | 底层等效映射 | 实际功能与适用场景 |
|---|---|---|---|
a[:] |
正向 (+1) | a[0 : len(a) : 1] |
获取整个序列的浅拷贝(常用于列表复制) |
a[k:] |
正向 (+1) | a[k : len(a) : 1] |
从索引 k 截取到序列末尾 |
a[:k] |
正向 (+1) | a[0 : k : 1] |
从序列开头截取前 k 个元素 |
a[::-1] |
反向 (-1) | a[len-1 : -1 : -1] |
完整反转序列(字符串或列表倒序) |
a[k::-1] |
反向 (-1) | a[k : -1 : -1] |
从索引 k 倒序提取至开头(含第 0 项) |
a[:k:-1] |
反向 (-1) | a[len-1 : k : -1] |
从末尾倒序提取至 k+1 项(不含第 k 项) |
七、总结
掌握 Python 切片省略 start 或 stop 的本质,关键在于跳出“参数是静态数值”的思维定势:
- 切片的默认值始终是由
step的正负号动态派生的。 - 在正向(
step > 0)时,start缺省为0,stop缺省为len(seq)。 - 在反向(
step < 0)时,start缺省为len(seq) - 1,而stop必须通过留空(缺省)来触发解释器延伸至索引0之前,从而实现包含首项元素的目的。
在日常编写生产代码时,建议在需要倒序包含整个开头的场景中一律采用 seq[::-1] 或 seq[k::-1],切勿显式写出 stop=0,即可彻底杜绝首项数据丢失的隐蔽缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









