

Python用secrets模块生成1到100的安全随机数
secrets 的 secrets.randbelow(100) + 1。本文将系统讲解生成安全随机数的核心方法、底层熵源机制、半开区间偏移推导,以及它与通用 random 模块的本质区别。
一、为什么生成安全随机数必须用 secrets 模块
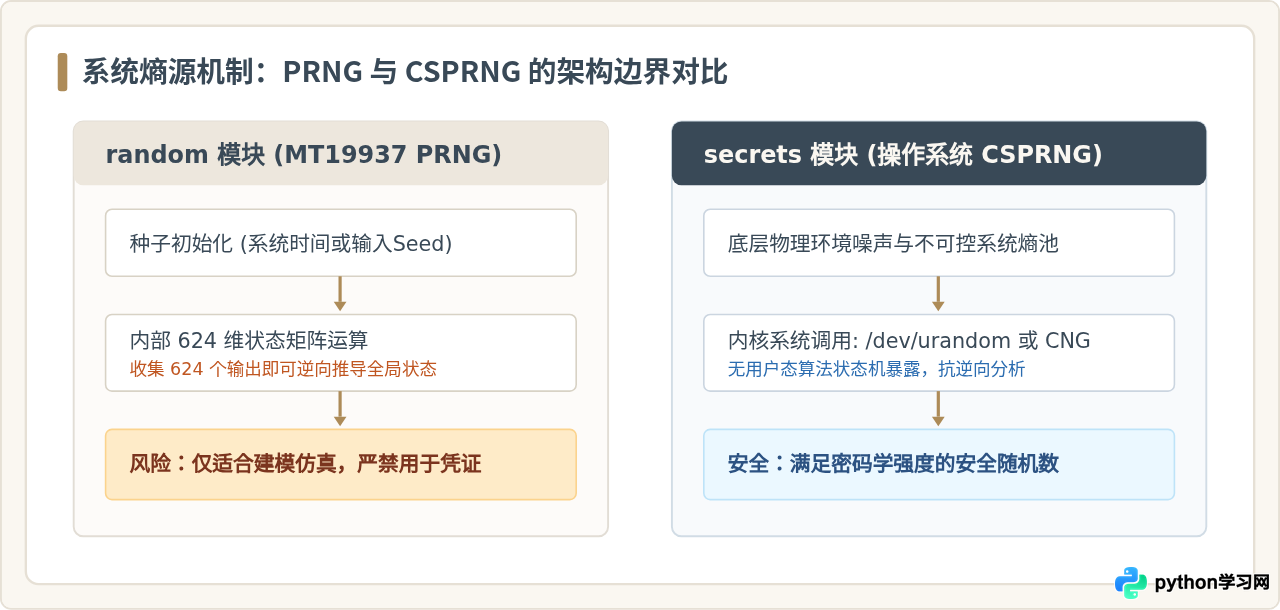
Python 程序员最先熟悉的随机函数通常是 random.randint(1, 100)。然而官方文档明确指出:random 模块采用的是梅森缠绕器算法(Mersenne Twister, MT19937),它属于确定性伪随机数生成器(PRNG)。其内部维护着 624 个 32 位的状态变量,一旦外部收集到一定数量的输出结果,就能在几毫秒内完整推导出算法内部状态,从而精准预测后续所有随机数。
当随机数被用于安全令牌、验证码、单次密码、抽奖抽奖券、密码学盐值等敏感场景时,使用 random 模块会带来严重的劫持和伪造漏洞。Python 3.6 引入的 secrets 模块专门为了解决这一问题,它直接调用操作系统内核底层的加密安全随机源(CSPRNG),不可被数学反向推导。
二、生成 1 到 100 安全随机数的具体方法
在实际编写 Python 代码时,有三种常见方式可以达成“生成 1 到 100 安全整数”的目标。它们在写法、底层开销和直观性上略有不同。
方法 1:使用 randbelow(100) + 1(官方推荐,最高效)
secrets.randbelow(n) 是 secrets 模块专门用来生成整数的函数。它接收一个正整数 n,并返回一个在区间 [0, n) 范围内的均匀随机整数(即包含 0,最大到 n - 1)。
由于我们要得到的是 [1, 100],因此传入 100 会生成 0 到 99 之间的数,在这个结果上再加上 1,就能精准对应到 1 到 100:
import secrets

# 生成 [0, 99] 的整数,加上 1 后变成 [1, 100]
secure_num = secrets.randbelow(100) + 1
print(f"生成的安全随机数为: {secure_num}")
方法 2:使用 choice(range(1, 101))(直观易读)
如果你希望直接在代码中声明目标区间 range(1, 101),可以使用 secrets.choice(sequence)。它会从给定的非空序列中安全地选取一个元素。由于 Python 的 range(start, stop) 是左闭右开区间,包含 100 的范围写作 range(1, 101):
import secrets

# 直接在目标序列中等概率安全抽取一个元素
secure_num = secrets.choice(range(1, 101))
print(f"生成的安全随机数为: {secure_num}")
在 Python 3 中,range 对象是一个轻量级的不可变序列,不会在内存中创建包含 100 个元素的完整列表,因此这种写法的性能损耗非常低,且具有极强的自解释性。
方法 3:使用 SystemRandom().randint(1, 100)(无缝迁移 random 接口)
secrets.SystemRandom 类直接继承自 random.Random,但其底层的所有随机字节全部替换为系统熵源。通过实例化该类,你可以直接获得熟悉的 randint(a, b) 方法:
import secrets

# 创建系统级随机生成器实例
sys_rand = secrets.SystemRandom()

# randint(1, 100) 包含两端端点 1 和 100
secure_num = sys_rand.randint(1, 100)
print(f"生成的安全随机数为: {secure_num}")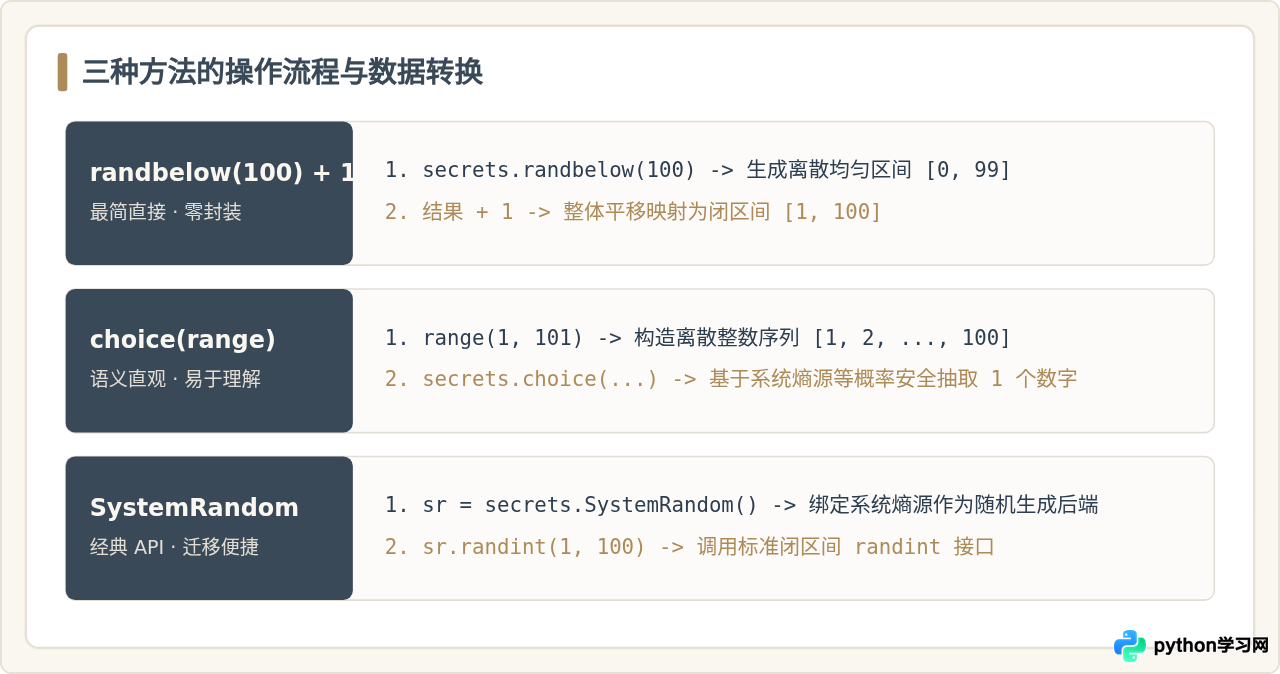
三、核心区别与方法选型对比
为了帮助大家在日常开发中准确选择,我们将常见方式的特性汇总在下表中:
| 生成方式 | 密码学安全 | 依赖版本 | 主要优势 | 适用场景 |
|---|---|---|---|---|
secrets.randbelow(100) + 1 |
是 (CSPRNG) | Python 3.6+ | 原生单函数调用,执行效率最高 | 高频安全随机整数生成(推荐) |
secrets.choice(range(1, 101)) |
是 (CSPRNG) | Python 3.6+ | 代码可读性极佳,边界直接明了 | 兼顾语义清晰与安全性的日常业务 |
secrets.SystemRandom().randint(1, 100) |
是 (CSPRNG) | Python 3.6+ | 兼容 random.Random 的完整方法集 |
既有代码重构替换安全后端 |
random.randint(1, 100) |
否 (仅PRNG) | 所有版本 | 速度极快,可指定Seed复现 | 科学计算、游戏逻辑、统计抽样 |
四、区间边界与常见易错点排查
在生成包含 1 和 100 的随机数时,初学者极易因为区间边界定义不清而引入 Subtle Bug(隐蔽缺陷)。以下是最典型的两个错误写法及其背后的数学原因:
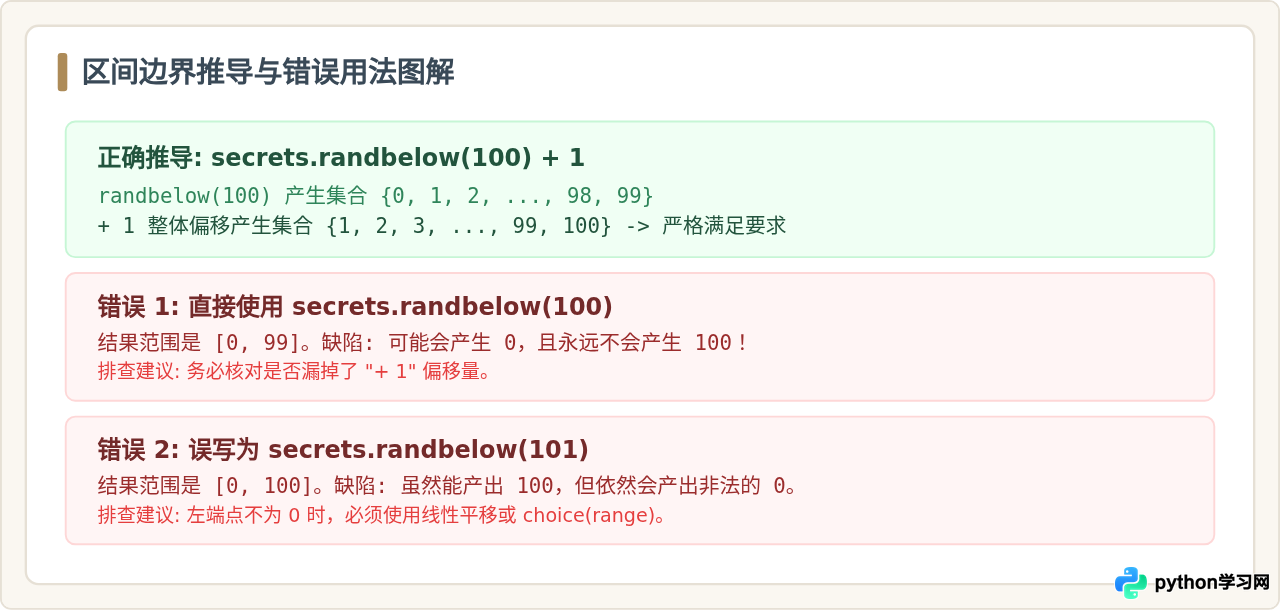
secrets.randbelow(0) 或负数,Python 会抛出 ValueError: upper bound must be distinctly greater than 0 异常。函数参数必须是严格大于 0 的正整数。
五、测试与均匀分布验证
安全随机数不仅要具备抗推导性,在统计学上也必须具备良好的离散均匀分布性。我们可以写一段简短的脚本,生成 100,000 次 1 到 100 的安全随机数,验证极值边界并检查两端端点是否均能正常产出:
import secrets
from collections import Counter

# 进行 100,000 次模拟采样
samples = [secrets.randbelow(100) + 1 for _ in range(100000)]

min_val = min(samples)
max_val = max(samples)

print(f"最小值: {min_val}")  # 示例输出: 1
print(f"最大值: {max_val}")  # 示例输出: 100
assert min_val == 1 and max_val == 100, "区间边界异常!"

# 统计两端端点 1 和 100 的命中频次
counts = Counter(samples)
print(f"数字 1 出现次数: {counts[1]}")      # 示例输出: 约 1000 次
print(f"数字 100 出现次数: {counts[100]}")  # 示例输出: 约 1000 次
运行结果表明,每个数字落在 1 到 100 之间的概率均为 1%,没有偏斜,且严格限制在闭区间内。
六、实践总结与场景选型指南
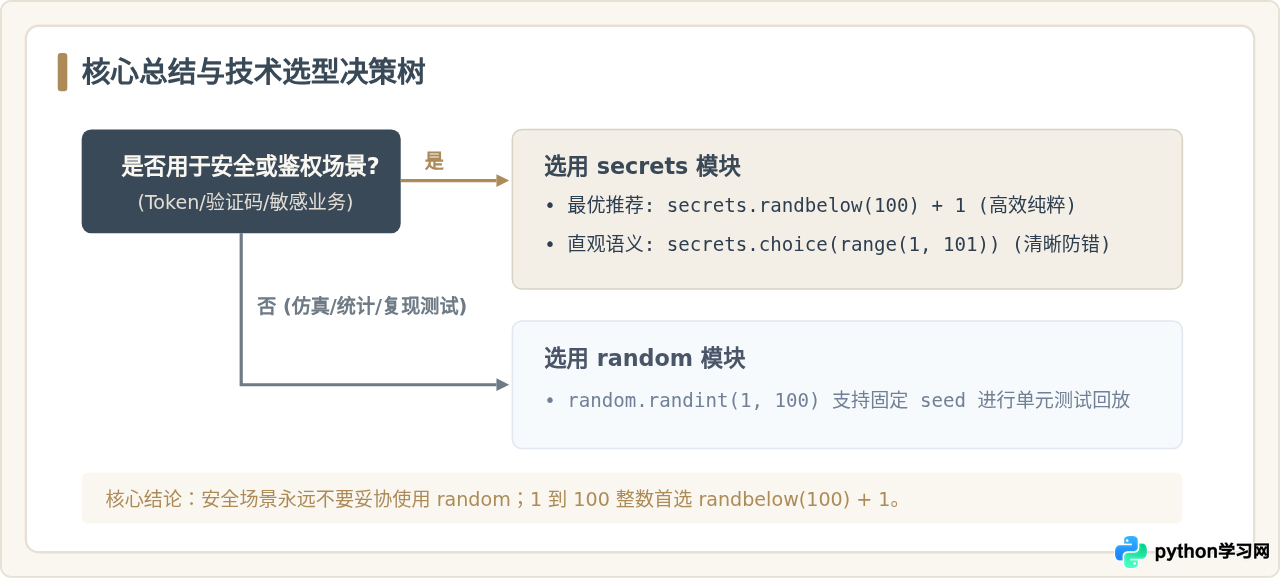
在实际项目架构中,区分“业务随机”和“安全随机”是每一个专业工程师的基本素养:
- 必须使用 secrets 模块:用户验证码(短信/邮箱 6 位验证码)、密码重置 Token、会话 Session ID、API Key、抽奖关键中奖号、敏感身份凭证。
- 适合使用 random 模块:蒙特卡洛数值模拟、游戏角色位移微调、物理碰撞实验、需要固定
random.seed()以便进行自动化单元测试复现的数据生成。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









