

Python脚本文件保存为.pyc后还能编辑吗

核心答案是:.pyc 文件不能直接像常规 Python 源代码那样打开并编辑。因为 .pyc 是 Python 解释器在执行代码前生成的二进制字节码(Bytecode)缓存文件,内部存储的是供虚拟机执行的指令流,而不是纯文本。如果直接使用记事本、VS Code 或 Vim 打开它,只会看到一堆不可读的二进制乱码。如果确实需要修改其中的业务逻辑,唯一可行的解决路径是借助反编译工具将其还原为可读的 .py 源代码,修改完毕后再重新运行或生成新的 .pyc 文件。
一、深入理解:.pyc 文件到底是什么
许多初学者在运行 Python 项目时,会发现目录下自动生成了一个 __pycache__ 文件夹,里面存放着命名如 script.cpython-310.pyc 的文件。要搞清楚它为什么不能直接修改,首先需要理解 Python 的执行机制与 .pyc 的内部构造。
Python 虽然被称为解释型语言,但它并不是逐行直接去读取并执行 .py 文件里的纯文本。为了提高运行效率,Python 解释器在首次加载源脚本或导入模块时,会经历以下两个关键步骤:
- 解析与编译阶段:解释器首先解析 Python 源码的语法结构,生成抽象语法树(AST),然后将其编译成平台无关的字节码序列,最后将这些字节码连同版本信息打包序列化,写入磁盘作为缓存,这就是 .pyc 文件。
- 虚拟机执行阶段:Python 虚拟机(PVM)负责载入字节码,通过内部高效的状态机逐条解释执行这些字节码指令。
当项目下一次启动且源码未发生变更时,解释器会跳过耗时的文本语法解析,直接读取现成的 .pyc 文件载入内存,从而显著减少模块导入与启动的时间成本。
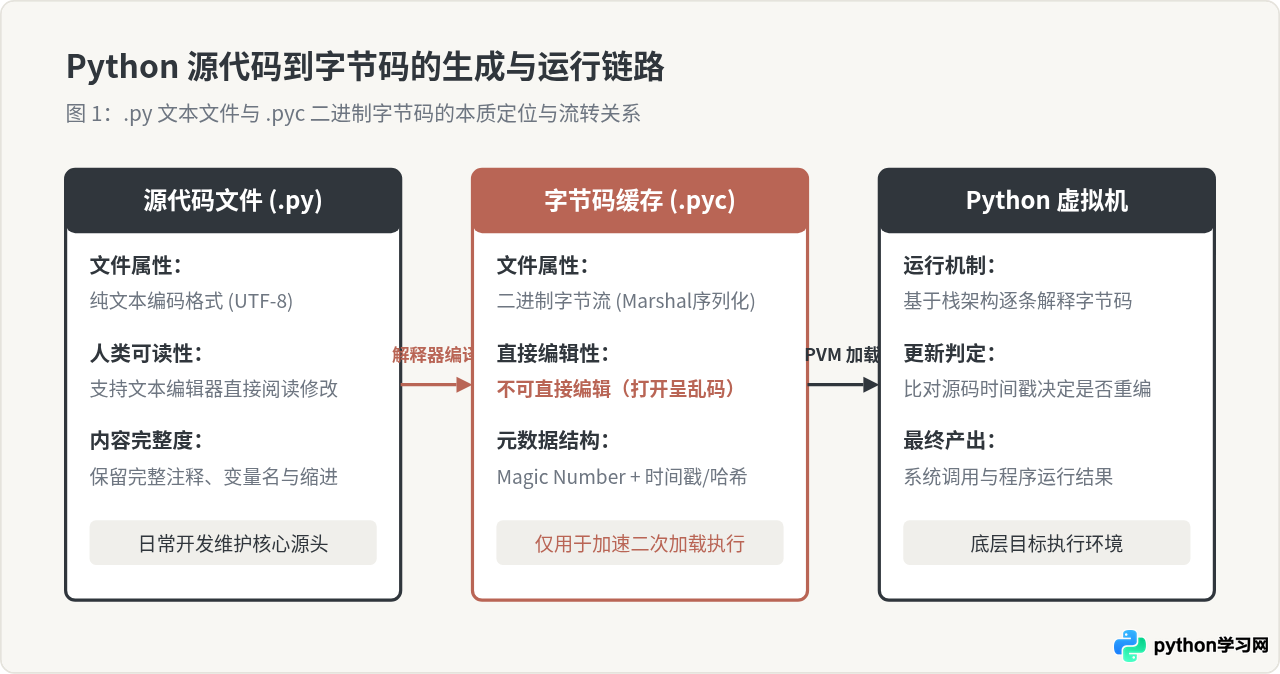
二、为什么强行修改 .pyc 会直接导致程序崩溃
有的开发者可能会问:既然 .pyc 是二进制文件,那么用十六进制编辑器(Hex Editor)强行修改其中的字符串或指令可行吗?
答案是极度困难且极易损坏文件。.pyc 文件采用高度严格的二进制封装规范,其基本结构包含两大部分:
- 头部元数据(Header):占 16 个字节(以 Python 3.7+ 为例)。前 4 个字节为 Magic Number(用于区分不同 Python 版本的魔数),接下来是 4 字节的位字段标志,随后是 8 字节的时间戳与文件大小(或源码哈希)。如果直接改动了文件,而头部校验值与内容不匹配,Python 启动时会报出
bad magic number in '.pyc' file或直接忽略并报错。 - 序列化的 Code 对象:通过 Python 内置的
marshal模块转储。它封装了全局常量表(co_consts)、变量名表(co_names)、跳转偏移量(Jump Target Offset)以及指令调用栈深。在二进制层面,任何一条代码逻辑改动都会改变指令长度和常量池索引,导致后续所有跳转指令的绝对偏移全部错位。
因此,直接改动二进制字节码并不是正规的维护方式,强行修补必然引发未定义行为或直接抛出 EOFError: EOF read where object expected。
三、若只有 .pyc 文件,如何进行编辑与修改
在现实开发中,常遇到遗留旧系统、意外丢失 .py 源文件、或者从镜像包中仅提取出 .pyc 的情况。要修改其中的逻辑,必须通过“反编译为 .py → 修改源码 → 重新测试”的步骤来实现。
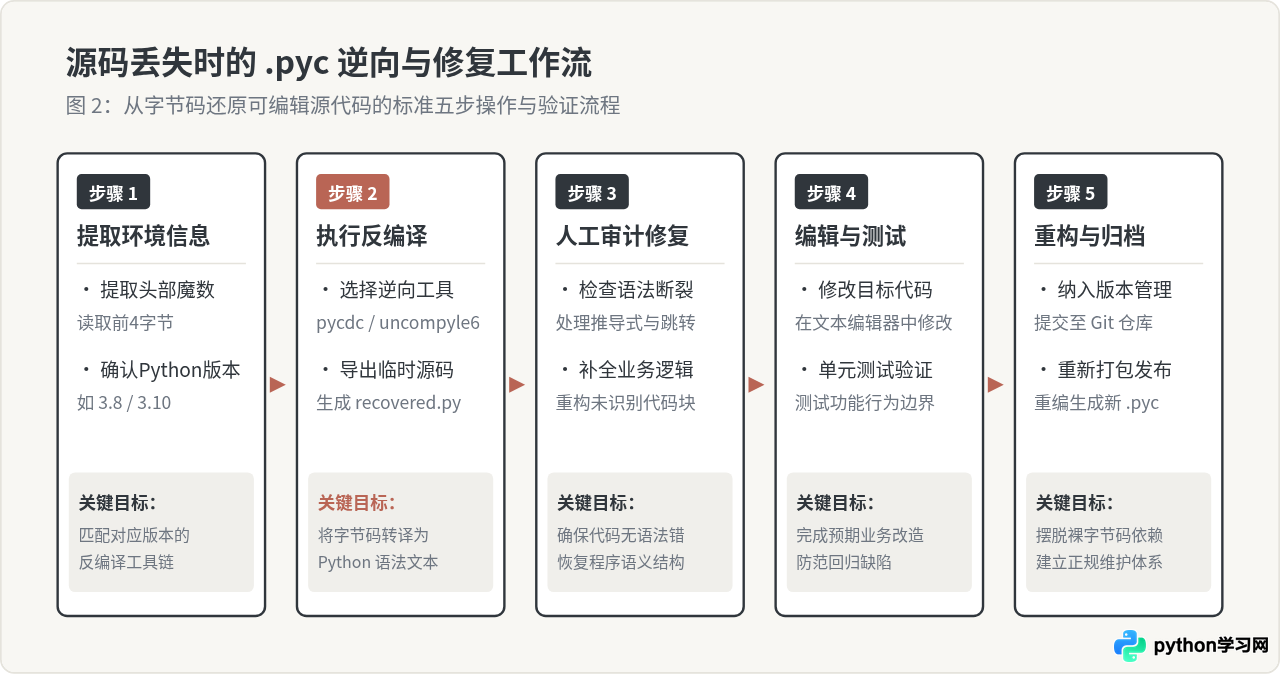
步骤 1:确认编译当前 .pyc 的 Python 版本
不同 Python 版本的字节码指令集和魔数并不兼容。在反编译前,可以通过 Python 读取 .pyc 的头部魔数,以确定它是基于哪个版本编译的:
# 示例代码:提取并检测 .pyc 头部魔数
with open("example.cpython-38.pyc", "rb") as f:
    magic_number = f.read(4)
    print("Magic Number (Hex):", magic_number.hex())
例如,若读出魔数为 550d0d0a,即对应 Python 3.8 的字节码规范。
步骤 2:选择并运行反编译工具
依据检测到的 Python 版本,选择适配的反编译工具:
- 对于 Python 3.8 及更早版本:社区成熟工具
uncompyle6具备很好的支持能力。可以直接通过命令行执行反编译并输出源码:# 在终端中执行命令 uncompyle6 example.cpython-38.pyc > recovered_example.py - 对于 Python 3.9、3.10、3.11 及更新版本:由于 CPython 官方对字节码指令集(如引入适应性指令适配、优化内联缓存等)做了重大升级,传统的 uncompyle6 无法直接处理。此时应使用基于 C++ 开发的开源逆向工具 decompyle++ (pycdc):
# 运行 pycdc 工具反编译较新版本的 .pyc
pycdc example.cpython-310.pyc > recovered_example.py
步骤 3:人工审计与语法校正
反编译工具并不是 100% 完美的语法复印机。在还原现代 Python 特性(如复杂推导式、模式匹配 match-case、装饰器组合)时,反编译器可能会在代码中标注 # WARNING: Decompyle failed 或输出近似的等效语句。开发者必须逐行阅读还原后的文件,理清控制流逻辑并修复破损语法。
步骤 4:编辑修改并重新运行
在确认 recovered_example.py 能被正常执行后,在常规编辑器(如 VS Code)中修改业务逻辑,运行测试。如果需要重新分发 .pyc,可以通过 Python 内置的 py_compile 模块将其重新编译:
# 重新生成更新后的 .pyc 文件
python -m py_compile recovered_example.py
四、.py 源码与 .pyc 反编译产物的差异对比
许多开发者会有疑问:既然可以反编译,那是不是意味着只要持有 .pyc,就能完全等同于拥有了源代码?事实并非如此。在从源码转化为字节码的过程中,部分信息已经被永久抹去。
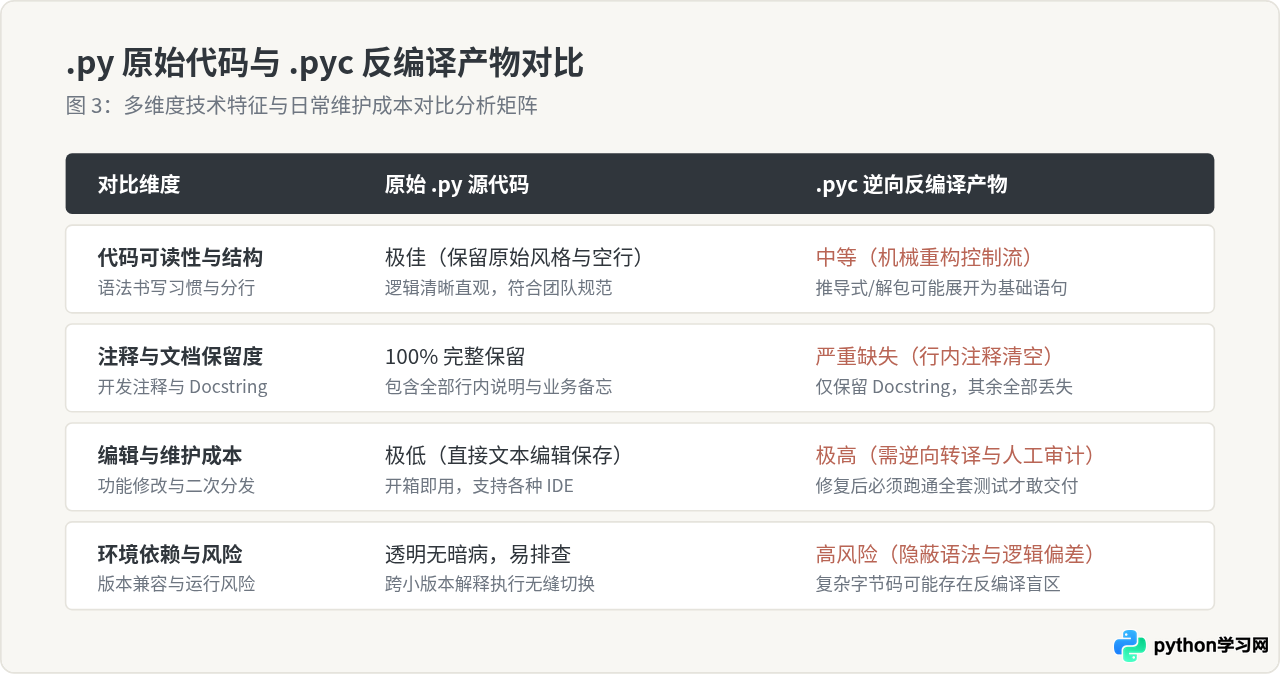
通过对比可以清晰地看到:
- 注释丢失不可逆:源码中所有形如
# 说明文档的行内注释在编译成字节码时都被词法分析器彻底忽略,不会打包到字节码中。反编译出来的文件即便结构完整,所有的上下文提示与心智模型也已彻底消失。 - 局部变量名与高级语法重构:虽然函数名与全局变量名作为符号被保留在常量池中,但在极端优化或特定嵌套作用域下,临时变量名可能被混淆或重置;列表推导式、生成器表达式等高级语法会被还原为冗长的普通循环。
五、工程实践:正确的代码交付与维护策略
反编译只是事后救火的兜底手段,而非日常软件工程中的正常手段。为了避免陷入“只有 .pyc 却急需修改”的被动局面,应建立健康的代码资产维护机制:
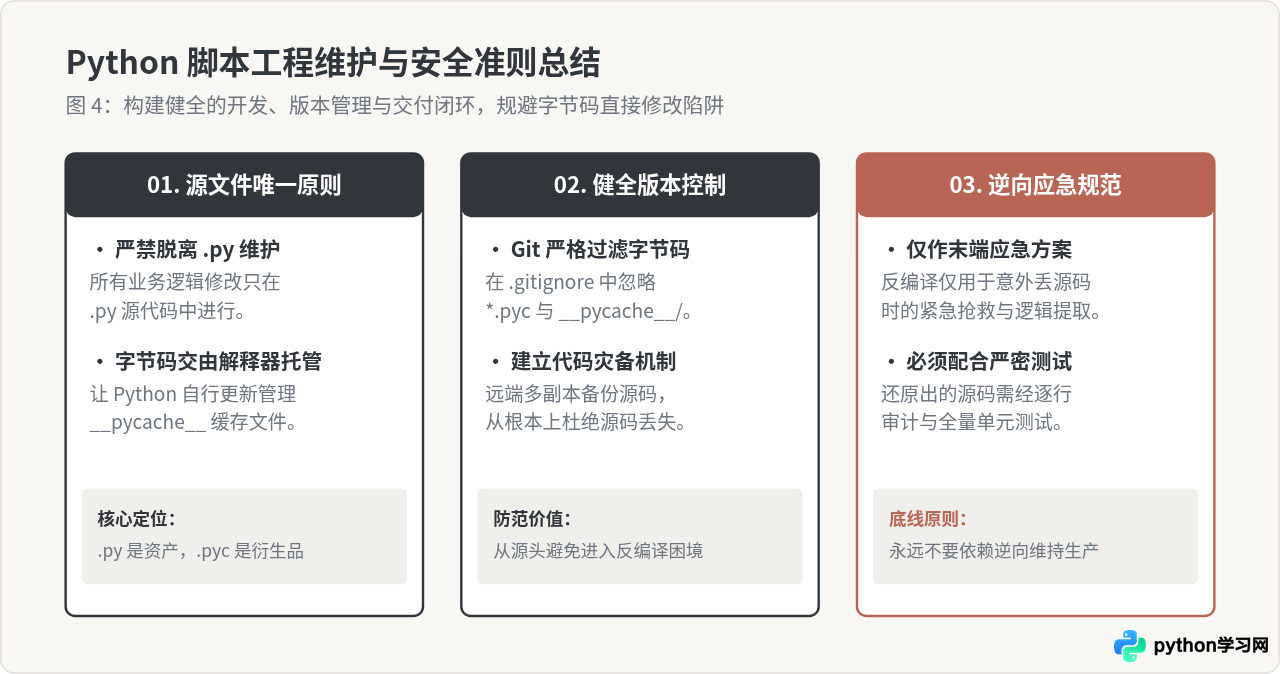
- 版本控制与忽略配置:确保项目源码全部纳入 Git 等版本控制系统,并在项目根目录的
.gitignore文件中明确加入:
避免把字节码当作开发产物提交,确保版本库中永远保存有完整的文本源文件。__pycache__/ *.py[cod] *$py.class - 代码安全分发的正确认知:部分开发者试图直接分发 .pyc 文件来实现“源码保密”或防篡改。正如前文所述,.pyc 极其容易被反编译还原出核心算法和结构,它并不是有效的代码混淆或安全加密方案。如果确实需要对 Python 代码进行商业保护,应考虑使用 Cython 编译为 C 扩展动态链接库(.so 或 .pyd),或使用专业的代码混淆器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









