

Python下载文件损坏或校验失败怎么办?验证SHA256哈希值教程
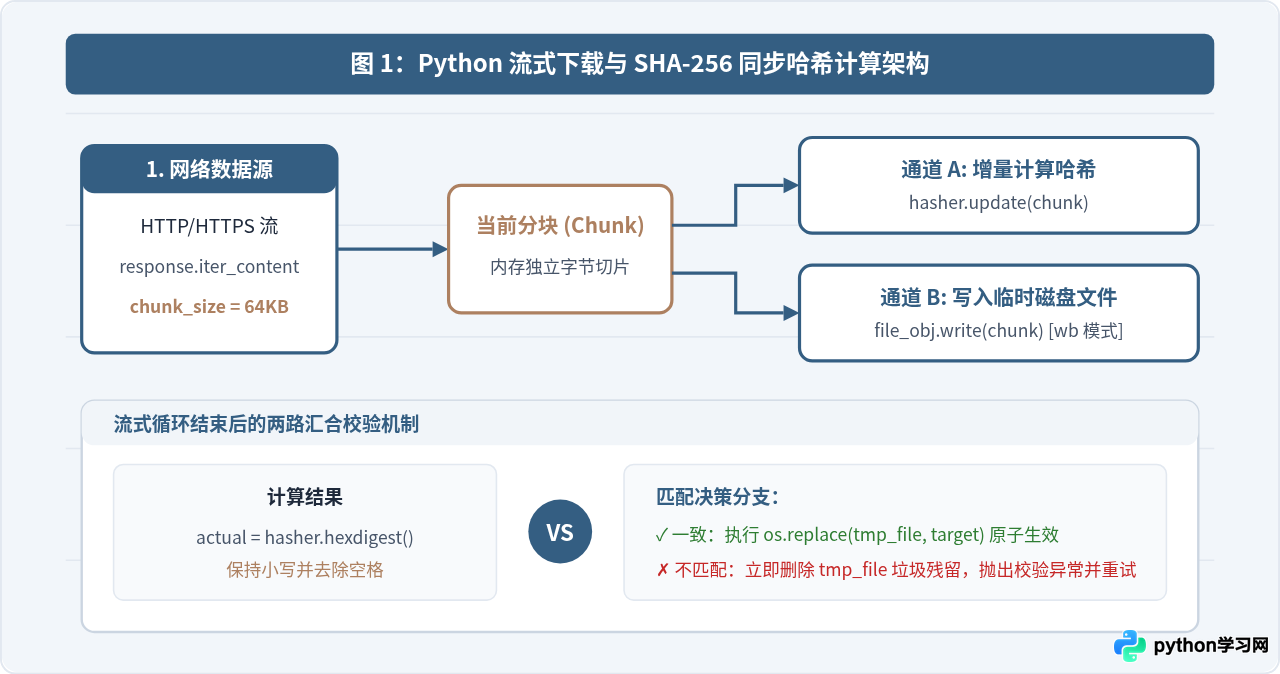
hashlib 边流式下载边计算 SHA-256 的标准方案,并提供临时文件原子化写入与异常恢复机制,确保下载文件完整无损。
一、为什么下载的文件会损坏或哈希校验失败?
SHA-256(Secure Hash Algorithm 256-bit)是一种单向密码学散列函数。任何输入数据只要有哪怕一个比特位发生改变,生成的 64 位十六进制哈希字符串就会发生彻底的雪崩式变化。在 Python 下载流程中,校验失败通常由以下四个典型原因造成:
- 网络传输非正常截断:由于网络连接抖动、服务端读超时或客户端超时设置不合理,TCP 连接被提前关闭,导致下载的文件只保存了前半部分,而程序未检查 HTTP 状态或
Content-Length标头。 - 文件读写模式错误(文本模式 vs 二进制模式):在 Windows 环境下使用 Python 内置的
open(filename, 'w')写入下载数据,会自动将字节序列中的换行符\n转换成\r\n,破坏原有二进制文件结构。必须严格使用'wb'模式。 - 网络网关或 CDN 返回了错误页面:当遇到认证失效(401/403)、速率限制(429)或代理网关超时(504)时,服务器返回的实际是一个简短的 HTML 错误网页。如果程序直接将其保存为
.zip或.bin,文件自然无法正常解析且哈希完全对不上。 - 哈希字符串格式比对失误:服务端给出的哈希值可能包含前后换行符、首尾空格,或使用了大写字母,直接使用字符串严格等于
==比对时容易产生虚假失败。
二、Python 计算本地文件 SHA256 哈希值基础方法
Python 标准库提供了极其高效的 hashlib 模块,内置了底层的 OpenSSL 加速支持。很多初学者容易犯的错误是直接使用 hashlib.sha256(open('file.bin', 'rb').read()).hexdigest()。对于几十兆的小文件虽然有效,但一旦处理几吉字节(GB)的压缩包或模型权重,这种写法会瞬间吃满系统内存并引发 MemoryError。
正确的工程实践是按固定大小分块(Chunk)读取文件,循环更新哈希状态:
import hashlib
import os

def calculate_file_sha256(file_path: str, chunk_size: int = 65536) -> str:
    """
    分块计算本地文件的 SHA256 哈希值
    :param file_path: 文件路径
    :param chunk_size: 单次读取字节大小,默认 64KB
    :return: 64位小写十六进制哈希字符串
    """
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"文件不存在: {file_path}")

    sha256_hasher = hashlib.sha256()
    with open(file_path, "rb") as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                break
            sha256_hasher.update(chunk)

    return sha256_hasher.hexdigest().lower()

# 使用示例
if __name__ == "__main__":
    demo_path = "dataset.tar.gz"
    # 示例打印计算值
# print("计算得到的 SHA256:", calculate_file_sha256(demo_path))在 Python 3.11 及更高版本中,标准库 hashlib.file_digest() 已经原生支持传入文件句柄自动完成分块计算:hashlib.file_digest(f, "sha256").hexdigest()。如果你使用的是现代 Python 版本,此函数在底层实现上效率更高。
三、边下载边校验:requests 健壮流式下载完整方案
常规做法是“先下载全部文件到磁盘,再重新打开文件读一遍计算哈希”。这种两阶段操作意味着磁盘 I/O 翻倍。最优解是在流式接收 HTTP 响应体的同时,将分块数据既写入磁盘,又送入哈希器更新,下载完成的一瞬间即可完成哈希比对。
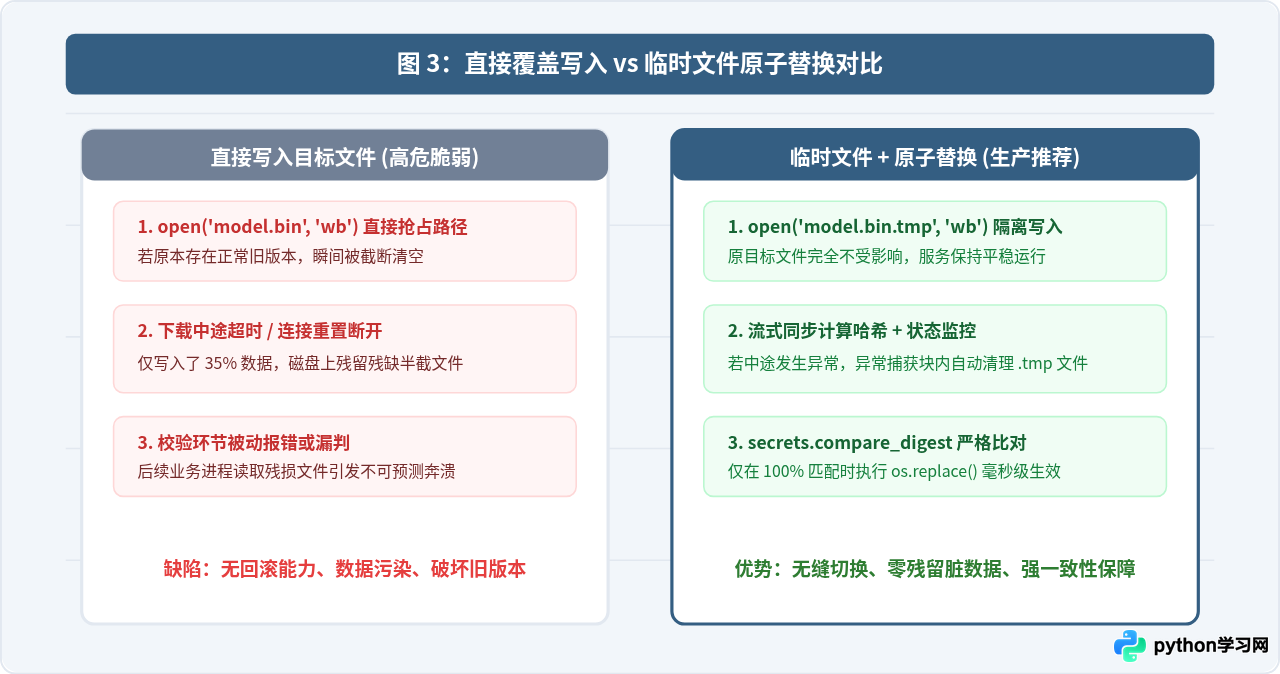
同时,为了防止校验失败时把一个已经损坏的文件留给后续调用方,应当先写入带 .tmp 后缀的临时文件,校验完全匹配后再通过原子重命名替换为目标文件名。
import os
import secrets
import hashlib
import requests

def download_and_verify_sha256(
    url: str,
    target_path: str,
    expected_sha256: str,
    timeout: int = 30,
    chunk_size: int = 65536
) -> bool:
    """
    流式下载并同步校验 SHA256,校验通过后原子生效
    """
    clean_expected = expected_sha256.strip().lower()
    temp_path = f"{target_path}.tmp"
    hasher = hashlib.sha256()

    try:
        # stream=True 避免一次性加载全部内容到内存
        with requests.get(url, stream=True, timeout=timeout) as response:
            # 严格检查 HTTP 状态码,避免将 404/502 错误页面保存为产物
            response.raise_for_status()

            # 校验远端标明的 Content-Length 与传输总量的对应关系
            total_bytes = 0
            with open(temp_path, "wb") as f:
                for chunk in response.iter_content(chunk_size=chunk_size):
                    if chunk:
                        f.write(chunk)
                        hasher.update(chunk)
                        total_bytes += len(chunk)

        # 获取计算出的哈希字符串
        actual_sha256 = hasher.hexdigest().lower()

        # 使用常量时间比对防范计时侧信道攻击,同时杜绝格式陷阱
        if secrets.compare_digest(actual_sha256, clean_expected):
            # 原子重命名:仅在哈希绝对匹配时才生成正式文件
            if os.path.exists(target_path):
                os.remove(target_path)
            os.replace(temp_path, target_path)
            print(f"校验成功,文件已安全写入: {target_path}")
            return True
        else:
            # 校验失败立即清理未完成的垃圾文件
            if os.path.exists(temp_path):
                os.remove(temp_path)
            print("哈希校验失败!")
            print(f"预期哈希: {clean_expected}")
            print(f"实际哈希: {actual_sha256}")
            return False

    except Exception as e:
        if os.path.exists(temp_path):
            os.remove(temp_path)
        print(f"下载中途异常中断: {e}")
        raise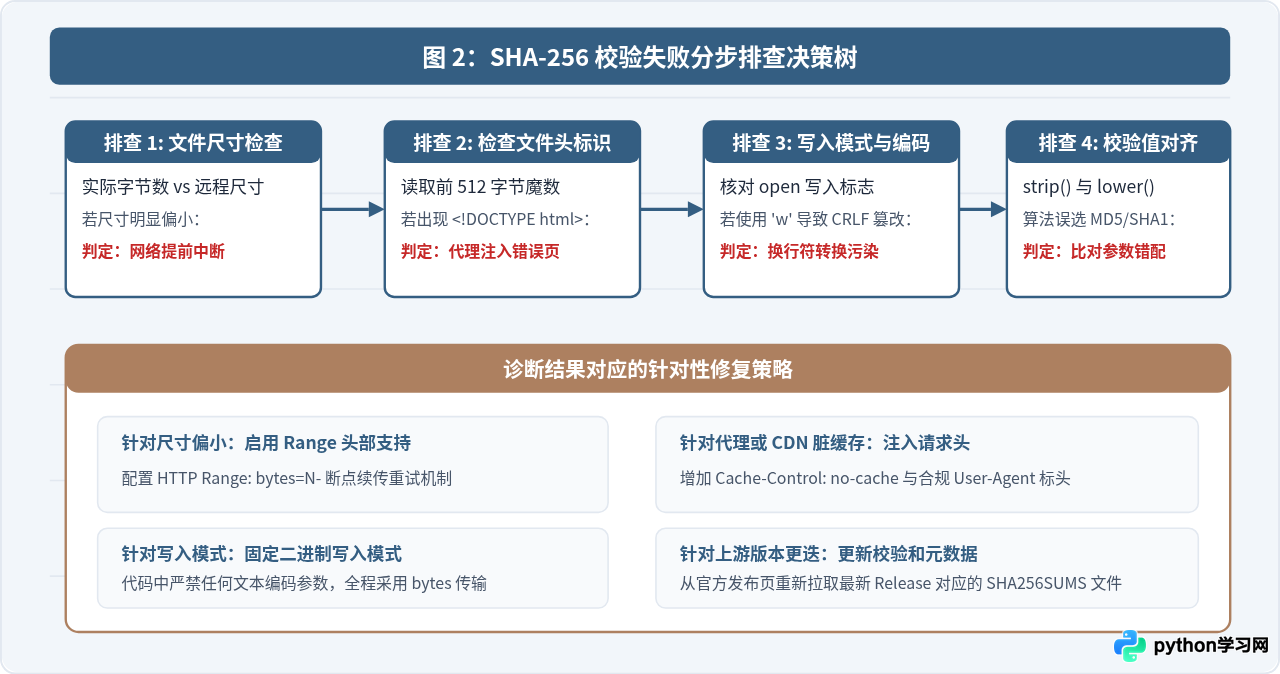
四、常见代码陷阱与健壮工程实现对比
编写自动化下载脚本时,简单直接的脚本与面向生产环境的代码往往有巨大差异。下表列出了常见的实现陷阱与对应的改进措施:
| 场景维度 | 脆弱的常见写法(易损坏/漏判) | 稳健的标准工程写法 |
|---|---|---|
| 内存管理 | r.content 一次性读取全部字节,极易在下载大文件时 OOM 崩溃。 |
iter_content(chunk_size=65536) 分块消费迭代器,内存消耗恒定在 64KB 以内。 |
| HTTP 状态处理 | 仅关注代码执行是否报错,将 404/500 返回的 HTML 误当成正常文件保存。 | 调用 response.raise_for_status(),严格拦截非 200/206 状态码。 |
| 本地写入安全 | 直接向最终路径写入,中途网络中断会在本地留下一半的死文件。 | 先写入 .tmp 文件,全部下载且 SHA256 比对成功后才通过 os.replace 原子生效。 |
| 哈希比对防错 | 直接使用 str1 == str2,容易受大写、前后换行符及空格影响。 |
使用 secrets.compare_digest(actual.strip().lower(), expected.strip().lower())。 |
五、校验失败后的自动化重试与异常恢复策略
当校验失败时,不应无限循环重试,而应建立具备“指数退避(Exponential Backoff)”与“重试上限”的恢复流程。通常,在触发重试前需要主动设置 HTTP 请求头 Cache-Control: no-cache,防止沿途的代理缓存或 CDN 边缘节点反复返回被截断的缓存块:
import time
import requests

def robust_download_with_retry(
    url: str,
    target_path: str,
    expected_sha256: str,
    max_retries: int = 3,
    backoff_factor: float = 2.0
) -> bool:
    """
    具备指数退避重试与防脏缓存特性的健壮下载函数
    """
    for attempt in range(1, max_retries + 1):
        print(f"开始第 {attempt}/{max_retries} 次尝试下载...")
        try:
            # 注入标头强制绕过沿途坏缓存
            custom_headers = {
                "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) PythonDownloader/1.0",
                "Cache-Control": "no-cache",
                "Pragma": "no-cache"
            }
            # 调用上一节定义的 download_and_verify_sha256
            success = download_and_verify_sha256(
                url=url,
                target_path=target_path,
                expected_sha256=expected_sha256
            )
            if success:
                return True
        except requests.RequestException as req_err:
            print(f"网络层发生通信故障: {req_err}")

        # 若校验失败或抛出异常,等待退避时长后再试
        if attempt < max_retries:
            sleep_seconds = backoff_factor ** attempt
            print(f"第 {attempt} 次下载未通过,等待 {sleep_seconds:.1f} 秒后重试...")
            time.sleep(sleep_seconds)

    print("已达最大重试次数,文件下载与校验最终失败。请人工排查网络环境或源端文件。")
    return False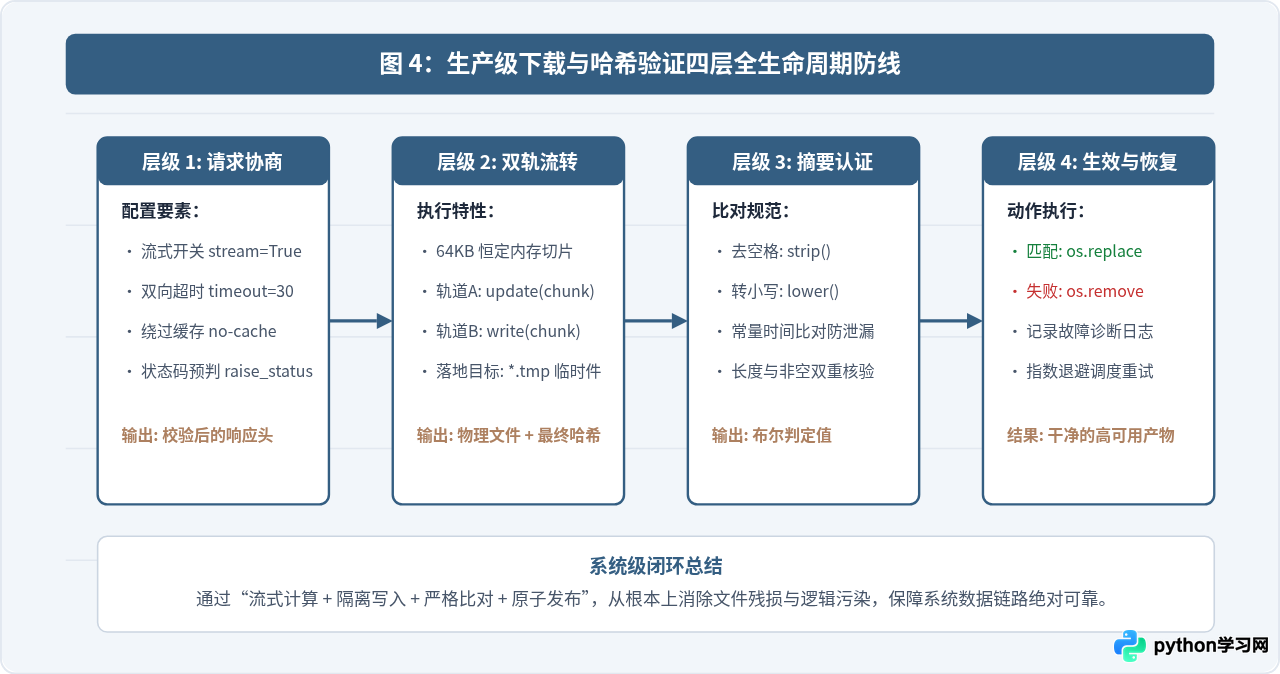
六、附录:使用操作系统原生命令行辅助核验
在调试 Python 下载脚本时,若需验证 Python 计算出的哈希值是否与操作系统工具一致,可以在终端中使用系统原生命令快速对比:
-
Linux 终端:
sha256sum filename.tar.gz -
macOS 终端:
shasum -a 256 filename.tar.gz -
Windows PowerShell:
Get-FileHash -Path .\filename.tar.gz -Algorithm SHA256 -
Windows CMD 命令提示符:
certutil -hashfile filename.tar.gz SHA256
只要本地命令行计算出的哈希值与 Python 脚本得出的字符串完全一致,就说明 Python 的哈希算法和分块逻辑完全正确。此时如果仍与远端提供的校验和不符,问题必然出在网络截断、源文件更新或下载到了代理错误页上,可直接按照第二、四节的决策流程进行定向排查。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









