

Python为什么不支持宏定义
Python 从最初设计至今始终没有提供原生宏定义(Macro)机制。核心原因在于:宏机制直接违背了 Python“显式优于隐式(Explicit is better than implicit)”与“可读性优先”的核心设计哲学,且基于缩进的语法体系与动态执行模型使文本宏极易破坏作用域与调试体验;与此同时,Python 依托一等函数、装饰器、上下文管理器与元类等运行时机制,已经能以清晰、可追踪的方式完成绝大多数传统宏的实用场景。
一、宏定义是什么:从 C 文本宏到 Lisp AST 宏
在理解 Python 为何拒绝宏之前,需要先厘清程序设计语言中“宏”的具体形态。通常所说的宏主要分为两类:
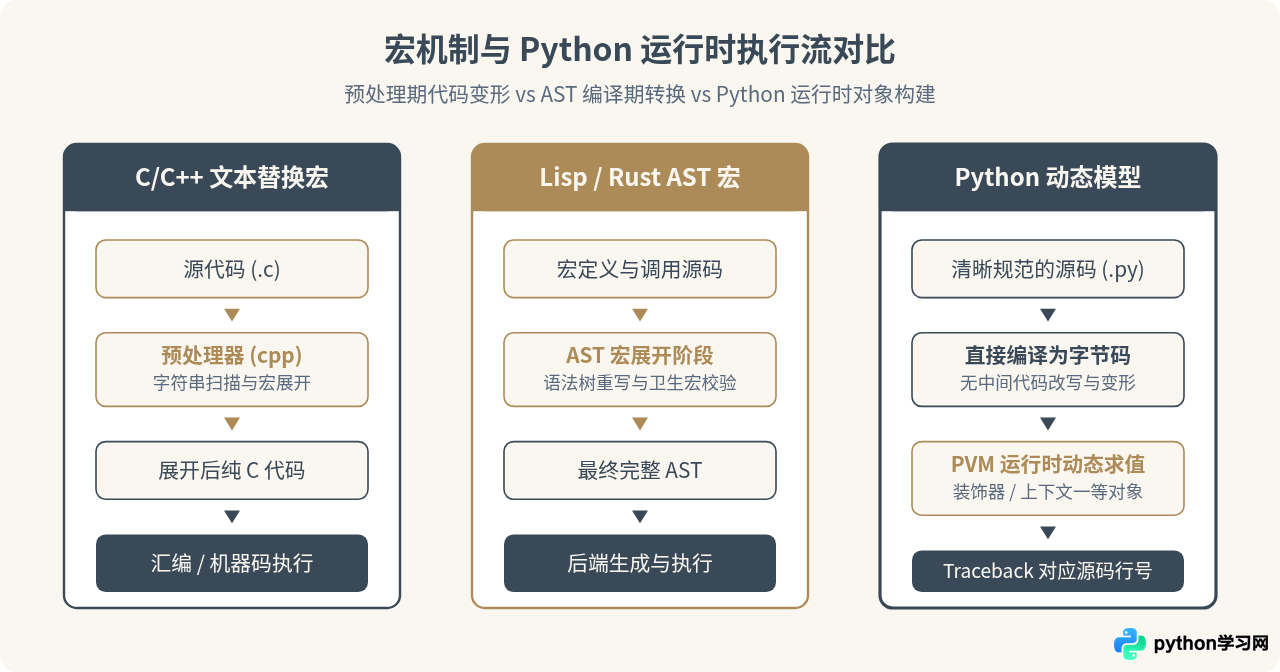
- 文本替换宏(如 C/C++ 预处理器):在代码正式编译之前,预处理器(cpp)执行纯字符串层面的查找与替换。它不理解语法树与类型,只机械地展开字符。
- 语法树宏(如 Lisp/Rust 宏):作用于抽象语法树(AST)层面。程序在编译阶段接收语法树节点,通过代码变换逻辑生成新的语法树,赋予了开发者创造自制语法(DSL)的能力。
无论是文本替换还是 AST 宏,宏的本质都是“代码生成代码的编译期机制”。代码在被编译器求值前已经被改写,这虽然带来了高度的灵活性,却让源码看到的形态与最终运行的形态产生了割裂。
二、Python 为什么拒绝宏定义:四大核心原因
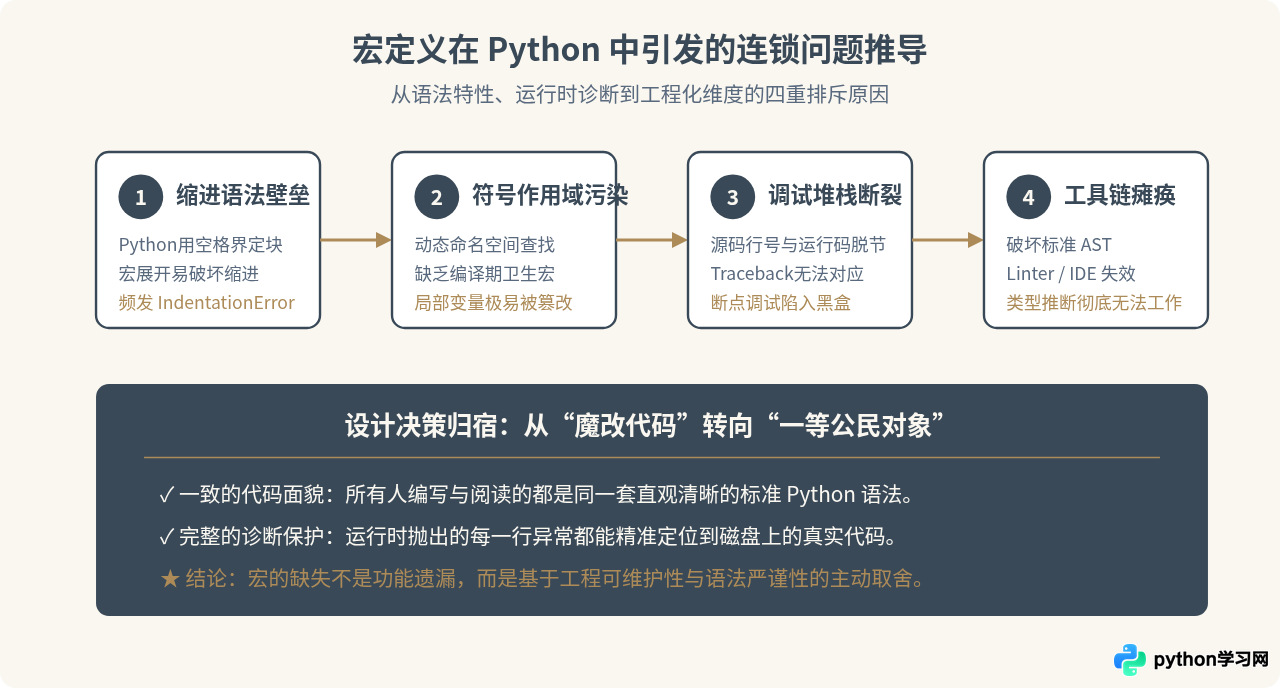
1. 哲学冲突:“可读性优于隐晦”与“反隐式陷阱”
Python 核心哲学在《The Zen of Python》(Python 之禅)中写得很直白:“显式优于隐式(Explicit is better than implicit)”,“可读性很重要(Readability counts)”。
宏的最大特点是在调用点隐藏真实执行逻辑。在支持强力宏的语言中,一段看似普通赋值的代码可能被宏改写成了多重循环、异步派发或静默引入全局变量。阅读者无法仅从当前上下文推导出代码行为,必须先跳转到宏定义,在脑中进行模拟展开。这破坏了 Python 追求的直观阅读体验。
2. 语法结构限制:缩进敏感与代码块组织
C 语言采用花括号 {} 和分号 ; 界定代码范围,文本替换时只要符号匹配即可正确组装。而 Python 依赖缩进(Off-side rule)来表达代码块结构。
如果允许文本宏替换,展开后的代码块极其容易因为前缀缩进不匹配、多行换行对齐问题导致语法解析器抛出 IndentationError。在维持缩进语法的现代语言中构建文本预处理器,复杂度极高且收益甚微。
3. 调试与错误追踪的断裂(Traceback 错位)
Python 程序员极度依赖清晰友好的异常回溯(Traceback)。当抛出未捕获异常时,Python 会准确指出抛出位置的文件名、行号与当前行源码。然而,若代码经由宏进行了重构或扩展,运行期抛错的虚拟行号往往与磁盘上的 .py 原始文件行号脱节,给排查生产问题带来严重阻碍。
4. tooling 与生态工具链的破坏
现代 Python 开发高度依赖 IDE(如 VSCode、PyCharm)、静态分析工具(Flake8、Ruff)与类型检查器(Mypy)。这些工具依赖解析标准的 Python AST。如果开发者能够随意引入宏定义来篡改代码语义,所有语法高亮、自动补全、变量重构与静态类型推断都将失效,导致整个工程生态体验大幅滑坡。
三、不用宏,Python 如何优雅解决问题?
在 C 语言中,宏常被用来完成三件事:常量定义、代码片段复用/包装、以及类型泛型与控制流生成。Python 提供了更规范且安全的替代方案。
| 传统宏的使用目的 | C/C++ 宏做法 | Python 标准替代方案 | 优势分析 |
|---|---|---|---|
| 常量定义与符号替换 | #define MAX_SIZE 1024 |
全大写全局变量 / Enum 枚举 |
具备模块作用域,可被 IDE 检索与重构 |
| 代码增强 / 切面逻辑 | 函数式宏包装前后逻辑 | 装饰器(Decorator) | 保留原始函数元信息,显式易读 |
| 资源申请与状态清理 | 宏展开成 goto 或复杂结构 | 上下文管理器(with 语句) |
保证异常安全,成对操作高度集中 |
| 类结构声明与动态注册 | 多行宏拼接类属性与方法 | __init_subclass__ / 元类 |
纯 Python 面向对象机制,无语法畸变 |
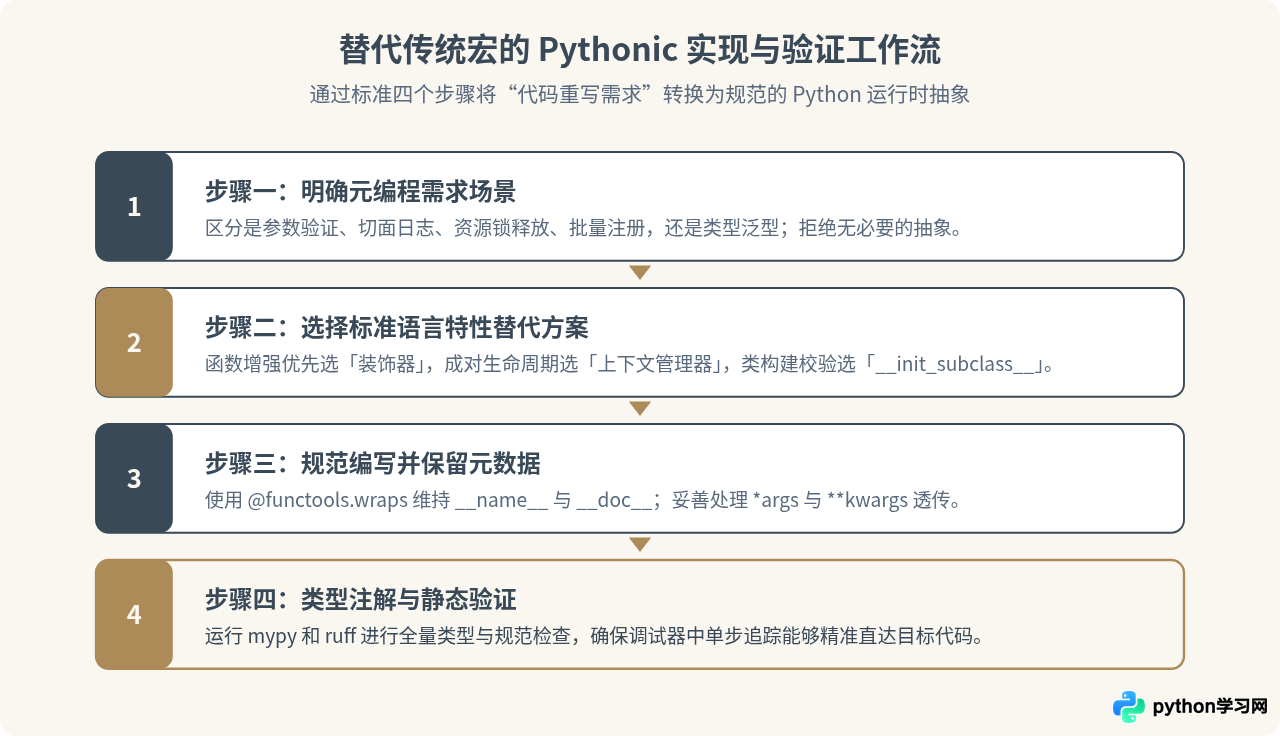
1. 替代代码增强:使用装饰器(Decorator)
C 语言中若想给函数增加调用计时或日志,常定义一个包裹宏。在 Python 中,函数是“一等对象(First-class citizen)”,通过装饰器可直接接收函数、包装并返回新函数:
import time
from functools import wraps

def time_it(func):
    """用于统计函数耗时的装饰器,替代传统的包裹宏"""
    @wraps(func)
    def wrapper(*args, **kwargs):
        start = time.perf_counter()
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start
        print(f"[{func.__name__}] 耗时: {duration:.4f}s")
        return result
    return wrapper

@time_it
def compute_sum(n: int) -> int:
    return sum(i * i for i in range(n))

# 执行
compute_sum(100000)
这种做法的代码完全在 Python 语法体系内,支持通过 functools.wraps 完整保留文档字符串、类型注解与真实函数名,IDE 和调试器能无缝感知。
2. 替代作用域与资源清理:使用上下文管理器(Context Manager)
当宏被用来确保“加锁-解锁”或“打开文件-关闭文件”时,Python 提供了 with 语句。配合 contextlib.contextmanager,几行代码就能以生成器形式实现成对的生命周期管理:
from contextlib import contextmanager

@contextmanager
def transaction_scope(db_session):
    """安全事务作用域,发生异常自动回滚"""
    try:
        yield db_session
        db_session.commit()
    except Exception:
        db_session.rollback()
        raise
四、常见疑问与边界场景探讨
1. Python 社区有没有尝试过做宏?(例如 MacroPy)
社区曾有过探索。著名第三方开源库 MacroPy 曾利用 Python 的导入钩子(Import Hook)机制,在 .py 模块加载时拦截语法树,实现语法宏扩展(如模式匹配、尾递归消除)。
然而这类项目未能广泛流行,更未能进入官方核心,原因十分明显:一旦项目中引入了自定义语法宏,团队中其他人必须单独学习该宏的方言规则;IDE 无法提供精准的跳转与智能重构,甚至代码格式化工具(如 Black)也会报错打断提交流水线。这印证了 Python 官方当初选择拒绝宏机制的远见。
2. 如果确实需要动态代码生成,终极方案是什么?
在深度学习框架(如 PyTorch 的 TorchScript / Dynamo)或高级 ORM 中,框架作者通常利用 Python 标准库自带的 ast 模块对代码对象进行解析,或直接使用字节码指令(dis、bytecode 模块)完成即时编译(JIT)。这些高阶技术限定在成熟库的内部运转,不对业务层开发者暴露自定义宏语法,从而守住了 Python 代码全网风格统一的底线。
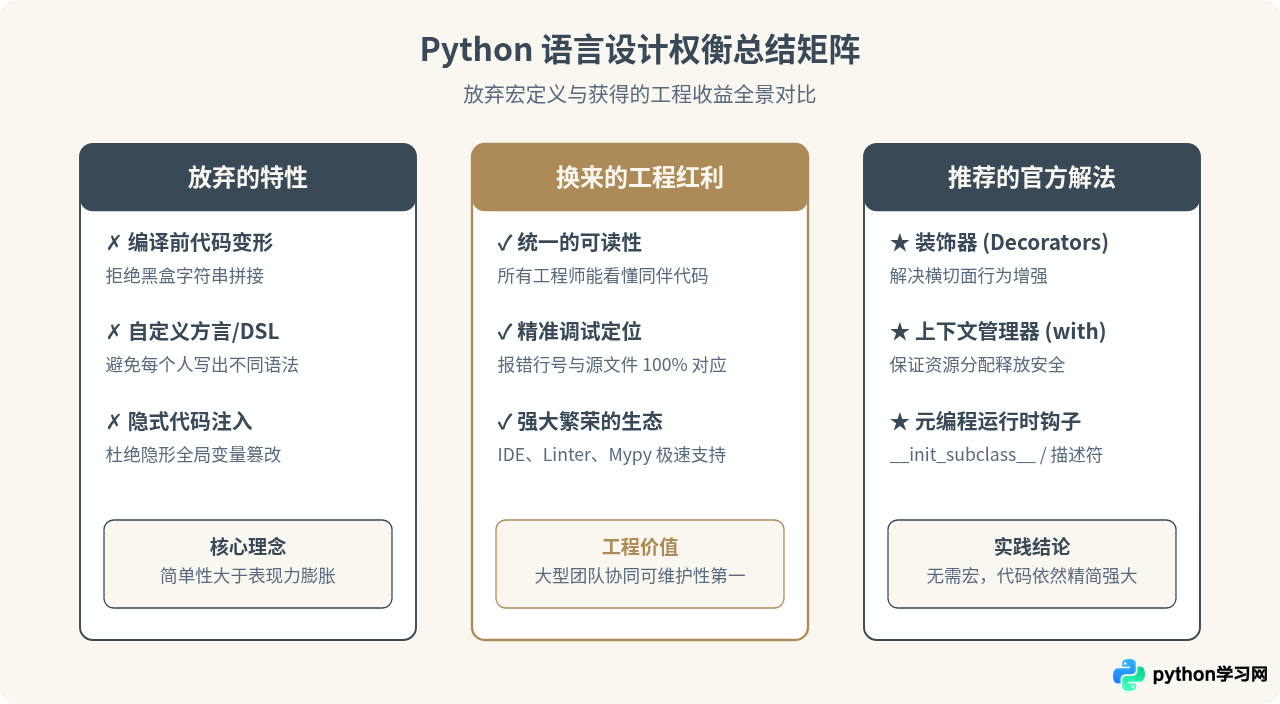
五、结语
“Python 为什么不支持宏定义?”这个问题的本质并不是“技术上能不能做”,而是“工程上应不应该要”。
宏是一把双刃剑,在给予开发者自由重塑语言能力的同时,也带来了方言泛滥、调试追踪中断和可读性下降的高昂代价。Python 选择将函数作为一等公民,辅以装饰器、上下文管理器与元类等语言特性,成功在灵活性与清晰性之间取得了绝佳的平衡。理解这种取舍,不仅能帮助我们更深入地理解 Python 的语法底层,更能让我们在日常开发中写出更加 Pythonic、更易维护的高质量代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









