

Python hashlib与base64加密模块实战详解

本文详解Python中hashlib与base64模块的应用。hashlib提供MD5、SHA等不可逆加密算法,适用于生成安全凭证与签名验证;base64为通用编码格式,虽可逆但可通过二次字符替换增强安全性。文章包含完整代码示例与场景分析,帮助开发者掌握数据加密与传输安全技巧。
hashlib 模块
hashlib 模块的介绍
hashlib 模块内置了多种加密算法,开发者无需关注底层实现细节,只需调用相应的加密函数即可对数据进行加密处理。
该模块提供的算法种类繁多,且部分算法具有较高的破解难度,因此加密后的数据极难被还原(注:此处“很难被破解”为相对概念,例如MD5、SHA1、MySQL密码及NTLM等算法,仍可能通过cmd5等平台进行穷举查询以建立明密文对应关系)。鉴于其不可逆特性,hashlib 中的加密方法均无法直接解密。
hashlib 模块中的常用加密方法
接下来介绍 hashlib 中常用的几种加密算法。
| 函数名 | 参数 | 介绍 | 举例 | 返回值 |
|---|---|---|---|---|
| md5 | byte | md5算法加密 | hashlib.md5(b’hello’) | hash对象 |
| sha1 | byte | sha1算法加密 | hashlib.sha1(b’hello’) | hash对象 |
| sha256 | byte | sha256算法加密 | hashlib.sha256(b’hello’) | hash对象 |
| sha512 | byte | sha512算法加密 | hashlib.512(b’hello’) | hash对象 |
上述加密函数均接收 byte 类型参数,调用后返回一个 hash 对象。hashlib 本质上是一种加密实现方式。
sha1、sha256 和 sha512 的主要区别在于数值越高,被破解的概率越低。
以下是 hashlib 模块生成加密字符串的示例。
import hashlib

hashobj = hashlib.md5(b'Hello_World')	# 将 'Hello_World'以 byte 形式传入,通过 md5 加密 赋值给 hashobj 对象
result = hashobj.hexdigest()			# hashobj 通过 hexdigest() 函数的16进制生成加密字符串赋值给 result
print(result)

# >>> 执行结果如下:
# >>> 486b98e454e54f44e811b9c62857f8f7
hashlib 模块情景练习
读者可能会产生疑问:既然 hashlib 加密后无法解密获取原始数据,那么加密后的信息有何实际用途?实际上应用场景广泛,本文将举例说明一种典型场景。
例如,用户请求某项服务时需要提供凭证。该凭证是通过双方约定且标准一致的加密方式生成的字符串。当用户发起请求时,携带此加密字符串,服务端依据相同的加密规范生成对应的字符串。若用户提供的凭证与服务端计算的字符串完全一致,则证明请求合法;否则视为非法请求。
定义此类认证签名字符串需要两个数据要素和一个模块:模块为 hashlib;数据1为双方共识的基础签名,记为 bash_sign;数据2为用户请求服务时的时间戳,记为 user_timestamp。
代码示例如下:
# coding:utf-8


import hashlib
import time

bash_sign = 'signature'  # 定义一个基础签名变量

def user_request_client():          # TODO 用户签名
    user_time = int(time.time())    # 获取用户请求服务生成凭证的时间戳 ;python 的时间戳是浮点类型,这里转成整型。
    _token = '%s%s' % (bash_sign, user_time)             # 定义一个加密之前的token,将 bash_sign 与 user_time 传入
    hashobj = hashlib.sha1(_token.encode('utf-8'))       # 由于参数是 byte 类型,所以我们需要将 _token 进行编码
    user_token = hashobj.hexdigest()        # 将 bash_sign 与 user_time 通过 sha1 加密的字符串 赋值给 user_token
    return user_token, user_time


def service_check_token(token, user_timestamp):          # TODO 服务器校验签名
    _token = '%s%s' % (bash_sign, user_timestamp)        # 服务器接收用户请求传入的 token 与 时间戳
    service_token = hashlib.sha1(_token.encode('utf-8')).hexdigest()     # 服务器的 token ,加密方式与用户请求加密方式一致
    if token == service_token:      # 校验加密串的合法性,若校验不通过,拒绝用户的服务请求
        # print(token, '---', user_timestamp)
        return True
    else:
        return False


if __name__ == '__main__':
    need_help_token, timestamp = user_request_client()
    # time.sleep(1)                 # 取消注释后,时间错不一致则会 签名校验不通过
    # result = service_check_token(need_help_token, time.time())

    result = service_check_token(need_help_token, timestamp)
    if result == True:
        print('用户请求服务签名校验通过,服务器提供对应服务')
    else:
        print('用户请求服务签名校验未通过,服务器拒绝提供对应服务')

# >>> 执行结果如下:
# >>> 用户请求服务签名校验通过,服务器提供对应服务
因此,这种验证机制包含两个方面:一是生成传入的 token 及时间戳;二是确认 token 是否按照既定标准生成。
若上述任一环节出错,服务器校验签名均会失败。这也是 hashlib 模块的常用场景之一,读者可尝试拓展思维,探索其他适用不可逆算法的场景。
base64 模块
base64 模块的介绍
base64 加密模块属于通用型编码算法,与 json 模块类似,在多种编程语言中均有 base64 模块且功能基本一致。因此,任何编程语言均可对 base64 加密字符串进行解密。
既然可逆,便存在安全隐患。不过,我们可以通过后续的小练习来解决这一问题。
base64 模块中的常用方法
| 函数名 | 参数 | 介绍 | 举例 | 返回值 |
|---|---|---|---|---|
| encodestring | byte | 进行base64加密 | base64.encodestring(b’string’) | byte |
| decodestring | byte | 进行base64解密 | base64.decodestring(b’c3RyaW5n\n’) | byte |
| encodebytes | byte | 进行base64加密 | base64.encodebytes(b’string’) | byte |
| decodebytes | byte | 进行base64解密 | base64.decodebytes(b’c3RyaW5n\n’) | byte |
注意:encodestring() 与 decodestring() 函数虽名为字符串加解密,但实际使用时需先将字符串转换为 byte 类型,再执行对应的加密或解密操作。
encodebytes() 与 decodebytes() 函数在功能、参数及返回值上与字符串加解密一致。实际上,在 Python 3.x 版本中,官方更推荐使用这一组函数进行加密和解密。
base64 模块的情景练习
接下来查看 base64 模块的加解密演示。
注意:由于加密与解密均需通过 byte 类型处理数据,因此可对加解密过程进行封装。
# coding:utf-8


import base64


def encode(data):       # 编码函数
    if isinstance(data, str):           # 判断传入的 data 的数据类型
        data = data.encode('utf-8')
    elif isinstance(data, bytes):
        data = data
    else:
        raise TypeError('传输的 \'data\' 参数需为 bytes 或 str 类型')

    # print(base64.encodebytes(data))
    # print(base64.encodebytes(data).decode('utf-8'))
    return base64.encodebytes(data).decode('utf-8')     # 加密后的 data 格式为byte类型,需要进行解码为字符串,参考上两行代码


def decone(data):
    if not isinstance(data, bytes):
        raise TypeError('传输的 \'data\' 参数需为 bytes 类型')

    return base64.decodebytes(data).decode('utf-8')


if __name__ == '__main__':
    result = encode('signature')
    print('base64 编码后的结果为:', result)

    new_result = decone(result.encode('utf-8'))
    print('base64 解码后的结果为:', new_result)

# >>> 执行结果如下:
# >>> base64 编码后的结果为: c2lnbmF0dXJl
# >>> base64 解码后的结果为: signature
如前文所述,既然 base64 的加解密方式公开,该如何提升安全性?方法很简单,即对 base64 加密后的密文进行字符串替换的二次处理(所谓二次处理,即二次转换过程)。
例如,定义三个专用字符串用于替换加密后的特定字符,代码示例如下:
# coding:utf-8


import base64


replace_one = '$'
replace_two = '%'
replace_three = '='


def encode(data):       # 编码函数
    if isinstance(data, str):           # 判断传入的 data 的数据类型
        data = data.encode('utf-8')
    elif isinstance(data, bytes):
        data = data
    else:
        raise TypeError('传输的 \'data\' 参数需为 bytes 或 str 类型')

    # print(base64.encodebytes(data))
    # print(base64.encodebytes(data).decode('utf-8'))
    _data = base64.encodebytes(data).decode('utf-8')     # 加密后的 data 格式为byte类型,需要进行解码为字符串,参考上两行代码
    _data = _data.replace('c', replace_one).replace('2', replace_two).replace('l', replace_three)   # 替换 'c'、'2'、'l'
    return _data

def decone(data):
    if not isinstance(data, bytes):
        raise TypeError('传输的 \'data\' 参数需为 bytes 类型')

    return base64.decodebytes(data).decode('utf-8')


if __name__ == '__main__':
    result = encode('signature')
    print('base64 编码后的结果为:', result)

    new_result = decone(result.encode('utf-8'))
    print('base64 解码后的结果为:', new_result)
执行结果如下:
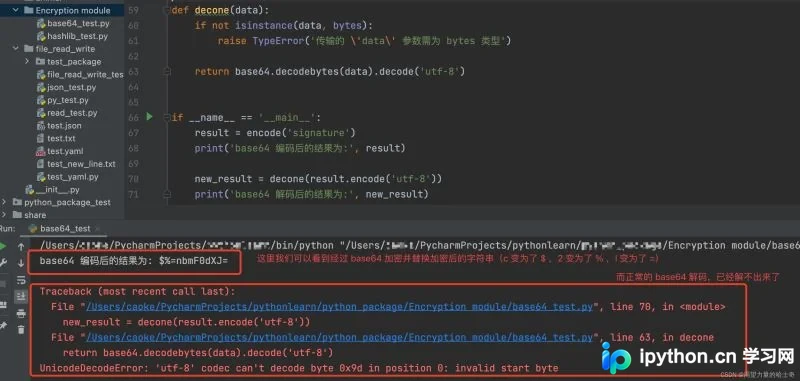
既然加密进行了二次转换,解密时同样需进行二次转换,因此需重构 decone() 函数。
def decone(data):
    if not isinstance(data, bytes):
        raise TypeError('传输的 \'data\' 参数需为 bytes 类型')

    replace_one_decone = replace_one.encode('utf-8')        # 需要将二次转换的变量已 byte 的形式进行解码
    replace_two_decone = replace_two.encode('utf-8')
    replace_three_decone = replace_three.encode('utf-8')

    data = data.replace(replace_one_decone, b'c').replace(replace_two_decone, b'2').replace(replace_three_decone, b'l')

    return base64.decodebytes(data).decode('utf-8')
运行结果如下:
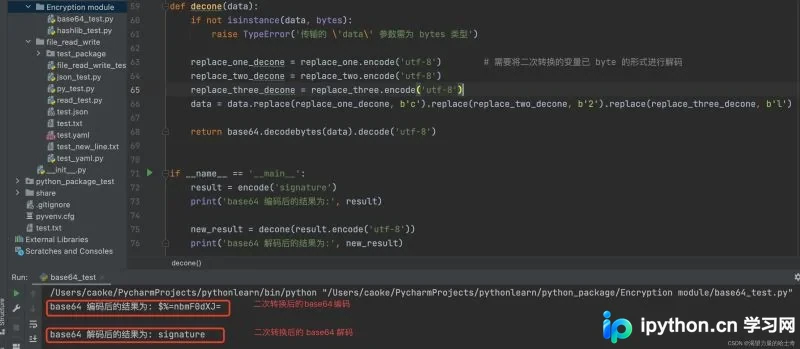
小结:通过此方法,仅具体开发人员与业务人员知晓二次替换方式及所需字符,从而提高了数据传输的安全性。
到此这篇关于Python学习之加密模块使用详解的文章就介绍到这了,更多相关Python加密模块内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









