

Python for循环中处理复杂if-else逻辑的简洁写法
在编写Python数据批处理、事件解析或任务流转程序时,我们经常需要在 for 循环内部遍历集合并执行各种条件判断。当业务逻辑逐渐增加,循环体内往往会堆叠深层嵌套的 if-elif-else 语句。这种代码不仅横向缩进过深,还极易掩盖真正的业务主干流程,降低可读性与维护性。本文将从实用重构的角度,介绍四种消除深层条件嵌套的简洁写法,帮助你在保持逻辑严密的同时,写出结构扁平、意图清晰的循环代码。
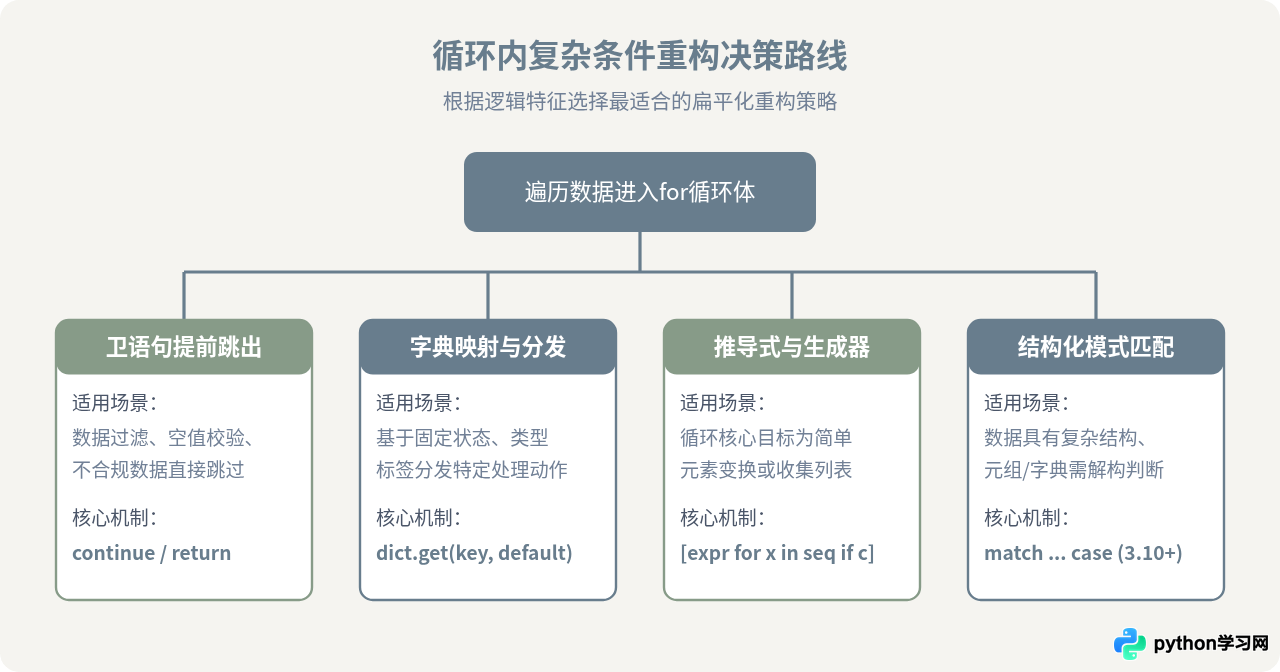
一、使用卫语句(Guard Clauses)提早跳出
在传统的嵌套条件代码中,开发者往往先检查“正面条件”,符合条件后再深入下一层判断。这导致正常的业务逻辑被包裹在多层大括号或缩进之下。如果发生异常或不满足条件,其 else 分支往往被遗忘在数十行之后的代码末端。
卫语句(Guard Clause)的核心思路是“优先检查异常和边缘条件,不符合则立即使用 continue 跳出当前轮次”。这样可以把嵌套结构拉平,让真正核心的业务代码始终保持在最外层缩进级别。
传统多层嵌套写法示例
# 传统嵌套写法:阅读负担大,缩进较深
users = [
    {"name": "Alice", "active": True, "score": 85},
    {"name": "Bob", "active": False, "score": 90},
    {"name": "Charlie", "active": True, "score": 45},
    {"name": "", "active": True, "score": 70},
]

results = []
for user in users:
    if user["name"]:
        if user["active"]:
            if user["score"] >= 60:
                grade = "PASS"
                results.append(f"{user['name']}: {grade}")
            else:
                results.append(f"{user['name']}: FAIL")
        else:
            # 距离判断起点相隔较远
            continue
    else:
        continue
使用卫语句重构后的简洁写法
# 卫语句写法:前置过滤异常,主干逻辑一目了然
results = []
for user in users:
    # 1. 守卫条件:用户名为空则立即跳过
    if not user.get("name"):
        continue

    # 2. 守卫条件:非活跃用户直接跳过
    if not user.get("active"):
        continue

    # 3. 主干流程直接暴露在顶层缩进
    grade = "PASS" if user["score"] >= 60 else "FAIL"
    results.append(f"{user['name']}: {grade}")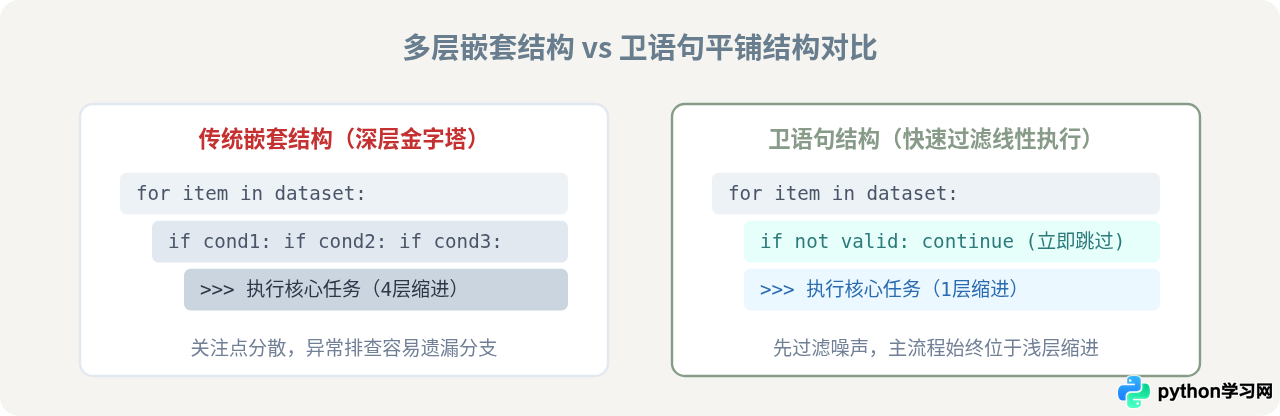
二、使用字典映射(Dispatch Table)替代长串 elif
当条件逻辑是根据某个特定的“枚举值”、“状态码”或“事件类型”决定后续行为时,通常会出现长达数屏的 if-elif-elif-else 链条。这种写法违反了面向对象设计中的“开闭原则”:每次新增状态,都必须修改包含循环的核心函数。
在Python中,函数属于一等公民(First-Class Citizens)。通过将状态键与具体处理函数组织为字典映射表,循环体内部只需要通过 dict.get() 获取对应的处理动作并执行即可。
重构前:长串 elif 链
orders = [
    {"id": 1, "status": "pending", "amount": 100},
    {"id": 2, "status": "shipped", "amount": 250},
    {"id": 3, "status": "canceled", "amount": 80},
    {"id": 4, "status": "unknown", "amount": 50},
]

for order in orders:
    status = order["status"]
    if status == "pending":
        print(f"订单 {order['id']} 正在等待支付,发送催付通知")
    elif status == "shipped":
        print(f"订单 {order['id']} 已发货,更新物流轨迹")
    elif status == "delivered":
        print(f"订单 {order['id']} 已送达,提示用户评价")
    elif status == "canceled":
        print(f"订单 {order['id']} 已取消,释放库存")
    else:
        print(f"订单 {order['id']} 状态异常: {status}")
重构后:函数分发字典(Dispatch Table)
# 1. 拆分各个具体动作,保持每个函数单一职责
def handle_pending(order):
    print(f"订单 {order['id']} 正在等待支付,发送催付通知")

def handle_shipped(order):
    print(f"订单 {order['id']} 已发货,更新物流轨迹")

def handle_delivered(order):
    print(f"订单 {order['id']} 已送达,提示用户评价")

def handle_canceled(order):
    print(f"订单 {order['id']} 已取消,释放库存")

def handle_default(order):
    print(f"订单 {order['id']} 状态异常: {order['status']}")

# 2. 建立映射表
STATUS_HANDLERS = {
    "pending": handle_pending,
    "shipped": handle_shipped,
    "delivered": handle_delivered,
    "canceled": handle_canceled,
}

# 3. 极简的 for 循环主体
for order in orders:
    handler = STATUS_HANDLERS.get(order["status"], handle_default)
handler(order)三、使用 Python 3.10+ match-case 结构化模式匹配
如果你的开发环境运行在 Python 3.10 或更高版本,结构化模式匹配(Structural Pattern Matching)提供了比 if-elif 更加强大且语义清晰的分支处理能力。它不仅能判断常量相等,还能解构字典、元组、类对象并同时提取内部字段,还支持附加哨兵条件(if guard)。
处理混合类型与复杂数据载荷
# 消息队列中的各类事件对象
events = [
    {"type": "click", "x": 100, "y": 200},
    {"type": "keypress", "key": "Enter", "modifiers": ["Ctrl"]},
    {"type": "error", "code": 404, "msg": "Page Not Found"},
    {"type": "error", "code": 500, "msg": "Server Crash"},
]

for event in events:
    match event:
        case {"type": "click", "x": x, "y": y}:
            print(f"鼠标点击坐标: ({x}, {y})")

        case {"type": "keypress", "key": key, "modifiers": mods}:
            print(f"键盘按下: {key},修饰键: {','.join(mods)}")

        # 支持在模式后追加额外条件判断
        case {"type": "error", "code": code, "msg": msg} if code >= 500:
            print(f"[严重告警] 服务端错误 {code}: {msg}")

        case {"type": "error", "code": code, "msg": msg}:
            print(f"[普通提示] 客户端错误 {code}: {msg}")

        case _:
            print(f"未识别的事件格式: {event}")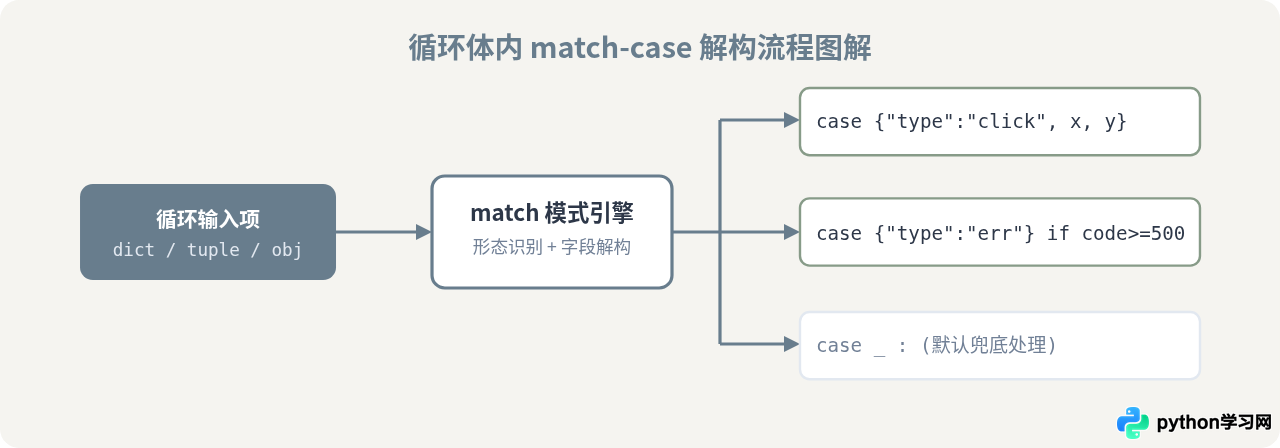
四、列表推导式与生成器表达式替代繁杂循环过滤
有时我们在 for 循环中写了大量的 if-else,仅仅是为了完成对原始列表的“过滤”与“数据变形”。如果这类循环没有涉及数据库写入、网络请求等副作用,直接使用推导式(Comprehension)或内置函数 filter() / map() 通常能大幅精简代码量。
条件过滤与简单二元运算
numbers = [12, -7, 0, 18, -3, 25, 42]

# 传统写法:为了过滤负数并为偶数打标,代码冗长
processed = []
for n in numbers:
    if n > 0:
        if n % 2 == 0:
            processed.append(f"{n}: 偶数")
        else:
            processed.append(f"{n}: 奇数")

# 简洁写法:一行推导式结合三元表达式
# 语法结构:[ 表达式 if 条件 else 替代表达式 for 变量 in 迭代对象 if 过滤条件 ]
processed_clean = [
    f"{n}: {'偶数' if n % 2 == 0 else '奇数'}"
    for n in numbers
    if n > 0
]
推导式中的两处 if 分工明确:
- 末尾的
if n > 0是过滤条件:只有满足该条件的元素才会进入处理; - 开头的
'偶数' if n % 2 == 0 else '奇数'是三元运算表达式:决定留下的元素如何进行变形映射。
五、四种重构手段的选型对比与总结
在实际重构循环逻辑时,不必孤立使用某一种技巧,通常可以将多种方式结合(例如在函数体外先推导式预过滤,循环内用卫语句排空,主干用字典分发)。下表总结了各方式的关键特性与边界条件:
| 重构手段 | 适用核心场景 | 代码结构变化 | 适用限制 / 注意事项 |
|---|---|---|---|
| 卫语句 (Guard Clauses) | 空值排查、状态校验、前置过滤 | 消除深层嵌套,将业务核心置于顶层 | 跳出过多时需保证状态清理逻辑不受影响 |
| 字典分发 (Dispatch Table) | 基于固定枚举值或状态码的多分支分发 | 用 O(1) 字典查找取代 O(n) 的连续 elif 判定 | 分支条件必须可作为哈希键;需准备 default 处理 |
| 推导式 / 生成器 | 纯数据的过滤提取与字段映射转换 | 将 6~10 行的追加循环压缩为 1~2 行 | 禁止在推导式中堆砌过多条件,避免损害可读性 |
| 模式匹配 (match-case) | 异构字典、元组结构解构与复合条件校验 | 一体化完成类型校验、结构解构与变量捕获 | 仅适用于 Python 3.10+ 版本运行时环境 |
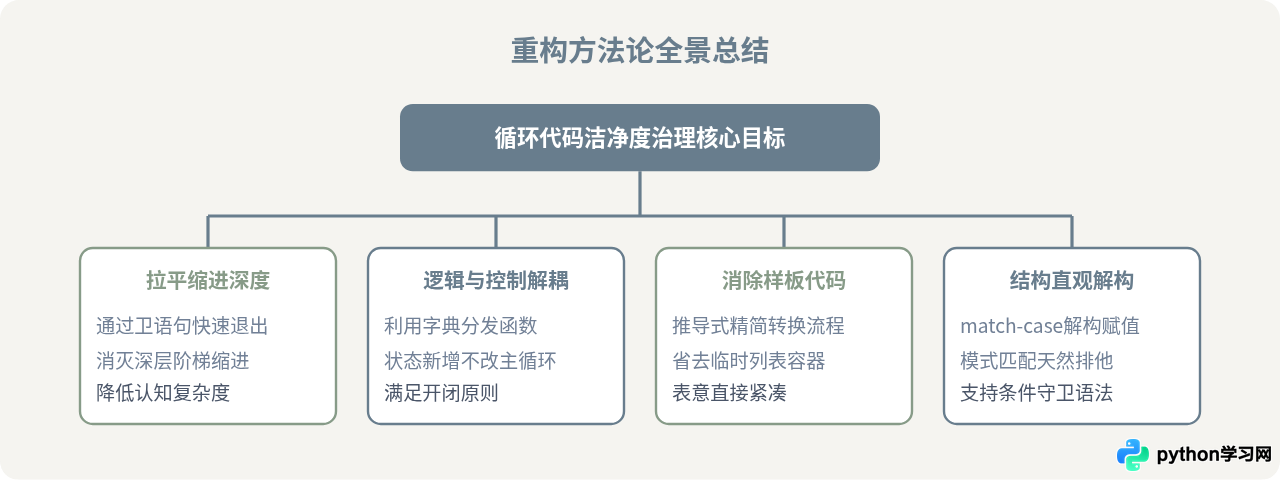
在面对复杂的循环体时,重构的核心目标不是盲目追求“把代码写成一行”,而是让核心业务逻辑在阅读时一眼可见。通过用卫语句快速排出非法数据、用字典分发替代多重分支、用模式匹配解析复杂协议,你就能彻底摆脱“金字塔形”嵌套,写出兼具可读性与可扩展性的优雅 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









