

Python处理大型JSON文件:分块读取与内存优化方案

发布时间:2026-10-15| 4人浏览过
针对Python中json.load()处理大型JSON文件导致内存溢出或卡死的问题,本文提出一种基于逐行读取与括号计数法的预处理方案。通过统计花括号数量判断完整JSON对象边界,将数组元素逐个提取并转换为JSON字符串写入临时文件,从而避免一次性加载全部数据至内存,实现高效的大规模数据处理。
大型JSON文件处理挑战
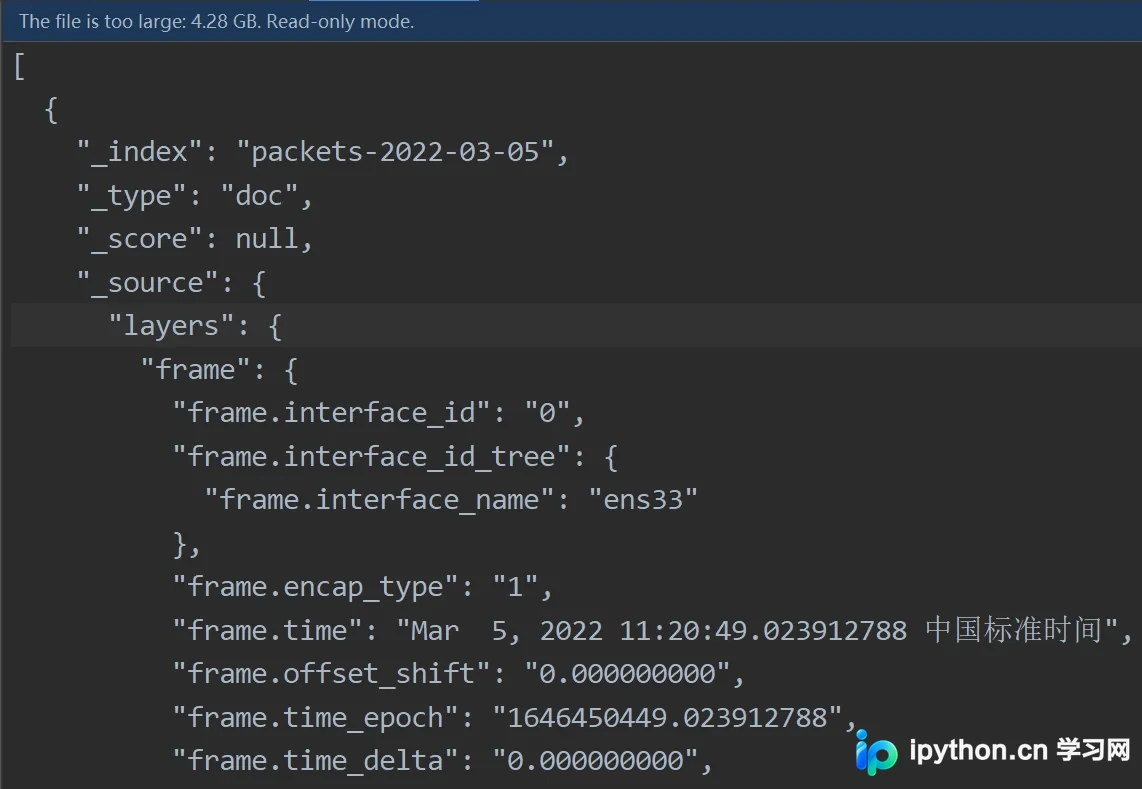
如参考图示所示,待处理的数据源为一个规模庞大的JSON数组,其体积足以对常规加载方式造成压力。
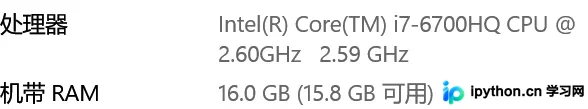
结合所示的电脑硬件配置,尝试直接使用json.load()方法加载该JSON文件时,系统会出现严重卡顿甚至无响应现象。
分块预处理策略
解决思路:
采用Python进行预处理策略:鉴于一次性加载整个JSON数据效率低下,改为分批加载,即每次仅解析一个JSON对象。随后利用json.dumps()方法将其序列化为字符串并存储至txt文件中,以便后续读取。当然,根据实际内存状况,也可直接存储于内存中,具体选择视情况而定。
算法核心思想:由于JSON属于结构化数据,其大括号{}必然成对出现。采用逐行读取方式处理JSON文件时,可通过统计{}的数量变化来判断是否完成了一个完整的JSON对象解析。若确认为完整对象,则调用json.dumps()方法将其存储至txt文件中。
getUsefullData(temp + line,id)函数用于提取所需的具体数据字段。
核心算法实现
def jsonProcess(fileName,round):
    id = 1
    with open(fileName, 'r', encoding='utf-8') as f,open('../tempData/tempFile'+str(round)+'.txt','w') as tempFile:
        line = f.readline()
        line = f.readline()
        temp = ''
        khNum = 0
        id = 1
        while line:
            # print(line)
            if line.find('{') != -1:
                khNum += 1

            if line.find('}') != -1:
                khNum -= 1

            if khNum == 0:
                line = line.replace(',','')
                data = getUsefullData(temp + line,id)
                id += 1
                if len(data) > 1:
                    # print(data)
                    try:
                        tempFile.write(json.dumps(data)+'\n')
                    except 'json.decoder.JSONDecodeError':
                        break
                temp = ''
                line = f.readline()
                continue
            temp += line
            line = f.readline()
数据读取与解析
读取方法:
with open('../tempData/tempFile'+str(round)+'.txt') as f:
        dataList = f.readlines()
        # 解析保存好的list
        for data in dataList:
            data = json.loads(data)
至此,关于Python处理大型JSON文件的方法介绍完毕。如需了解更多相关Python处理大型JSON文件内容,请搜索本站历史文章或继续浏览后续相关文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









