

Python列表怎么实现栈和队列?append与pop操作指南

在 Python 中,内置的列表(list)是一种动态数组结构,支持随时在尾部或指定位置插入与删除元素。借助 append() 与 pop() 两个内置方法,我们无需引入额外的第三方库,就能直接把列表当成栈(Stack)和队列(Queue)来使用。然而,这两类数据结构的访问机制截然不同,底层内存操作引发的性能表现也有着本质差异:用列表实现栈是高效且推荐的原生方案,而用列表实现队列则会因头部删除面临严重的性能瓶颈。
一、栈与队列的核心规则对比
理解这两种结构的关键在于元素进出的顺序:
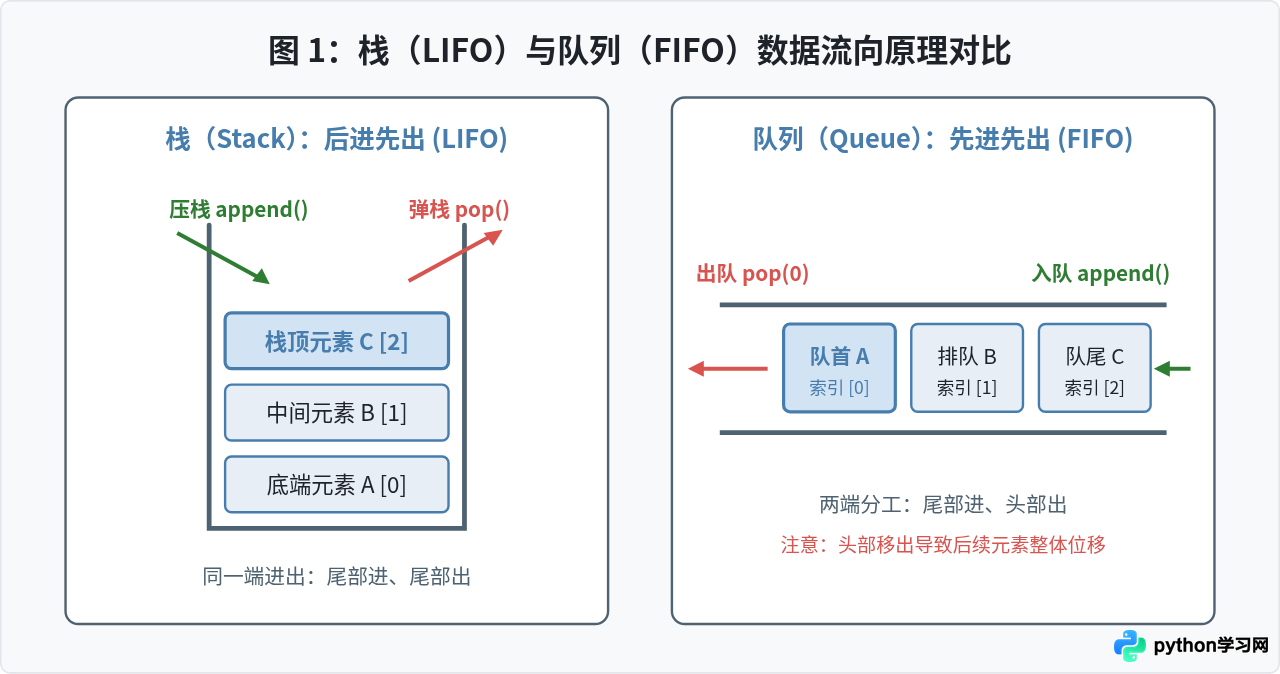
- 栈(Stack):遵循“后进先出”(Last In, First Out,简称 LIFO)原则。新元素从顶部压入(Push),取出的元素也必须是最后压入的栈顶元素(Pop)。常见场景如浏览器的前进后退栈、函数调用调用栈、撤销与重做功能。
- 队列(Queue):遵循“先进先出”(First In, First Out,简称 FIFO)原则。新元素从尾部追加(Enqueue),取出的元素则是最早加入的头部元素(Dequeue)。常见场景如任务调度排队、消息缓冲队列、打印任务管理。
二、Python列表实现栈:快速与高效
栈的操作只发生在单一端点。在 Python 列表中,列表尾部是最适合充当栈顶的位置:
- 入栈(Push):调用
list.append(x),将元素追加到列表末尾。平均时间复杂度为O(1)。 - 出栈(Pop):调用不带参数的
list.pop(),默认弹出并返回列表最后一个元素。时间复杂度为恒定的O(1)。 - 查看栈顶(Peek):通过负数索引
list[-1]查看栈顶元素,不改变列表内容,时间复杂度为O(1)。
1. 栈的操作步骤与代码演示
# 初始化空栈
stack = []

# 步骤 1:依次压入元素(Push)
stack.append("Page_1")
stack.append("Page_2")
stack.append("Page_3")
print("当前栈内容:", stack)        # 示例输出:['Page_1', 'Page_2', 'Page_3']
print("查看栈顶元素:", stack[-1])    # 示例输出:Page_3

# 步骤 2:弹出栈顶元素(Pop)
top_item = stack.pop()
print("弹出的栈顶元素:", top_item) # 示例输出:Page_3
print("弹栈后剩余:", stack)         # 示例输出:['Page_1', 'Page_2']

# 步骤 3:再次弹栈
next_item = stack.pop()
print("二次弹出的元素:", next_item) # 示例输出:Page_2
print("最终栈状态:", stack)         # 示例输出:['Page_1']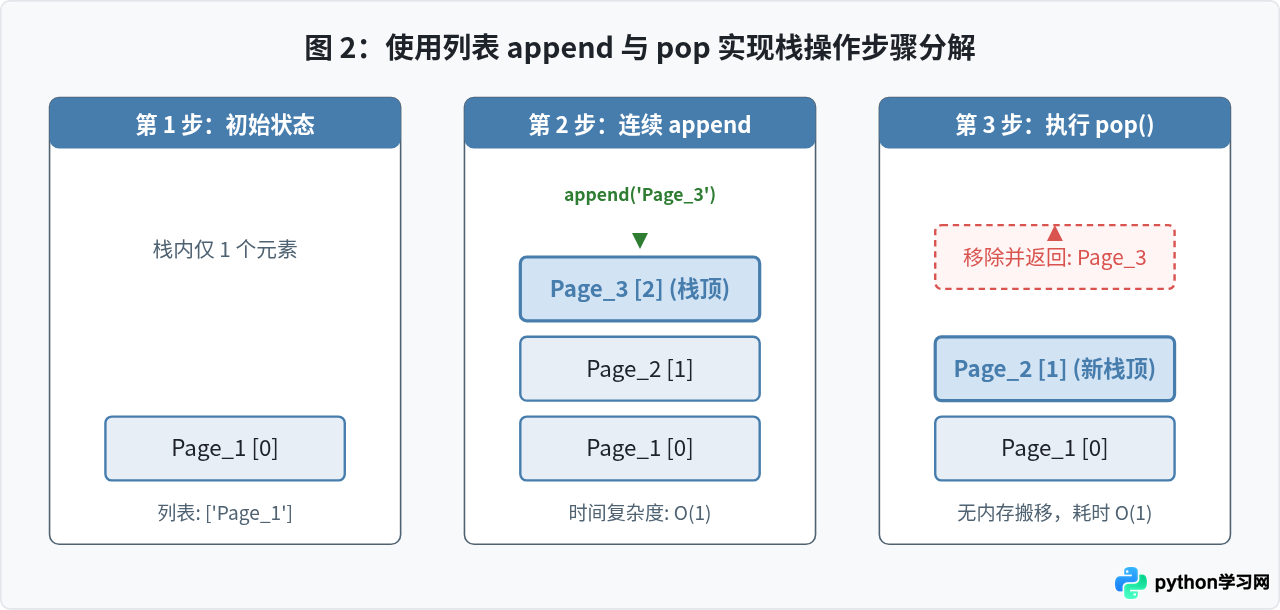
Python 列表是基于动态连续内存分配的。在末尾追加元素或缩短尾部长度时,列表无需搬移已存在的其他元素,因此
append() 和无参 pop() 的平摊时间复杂度均为 O(1)。日常开发中,直接使用列表作为栈完全能满足绝大多数高性能场景需求。
三、Python列表实现队列及其性能缺陷
如果要用列表模拟队列,入队依然使用 append(x) 追加至末尾,而出队时必须取出最先进入的元素,即索引为 0 的头部元素,语法上使用 pop(0)。
1. 队列的代码实现
# 初始化空队列
queue = []

# 步骤 1:入队(Enqueue)
queue.append("Task_1")
queue.append("Task_2")
queue.append("Task_3")
print("当前排队队列:", queue)      # 示例输出:['Task_1', 'Task_2', 'Task_3']

# 步骤 2:出队(Dequeue)- 必须指定索引 0
first_task = queue.pop(0)
print("处理的首个任务:", first_task) # 示例输出:Task_1
print("出队后剩余队列:", queue)      # 示例输出:['Task_2', 'Task_3']

# 步骤 3:再次出队
second_task = queue.pop(0)
print("处理的次个任务:", second_task) # 示例输出:Task_2
print("剩余队列:", queue)             # 示例输出:['Task_3']
2. 致命性能缺陷:O(n) 内存平移
虽然上述代码逻辑完全正确,但强烈不建议在生产环境或大数据量下使用列表的 pop(0)。其原因在于底层物理内存的排列方式:
当执行 pop(0) 移除了索引 0 的指针后,为了保证数组在内存中的连续性,Python 必须将索引 1 到 n-1 的所有元素向前搬移一位:原来位置 1 的元素移动到位置 0,位置 2 的元素移动到位置 1,以此类推。这意味着每次出队操作的时间复杂度高达 O(n)(其中 n 为当前队列中的元素个数)。
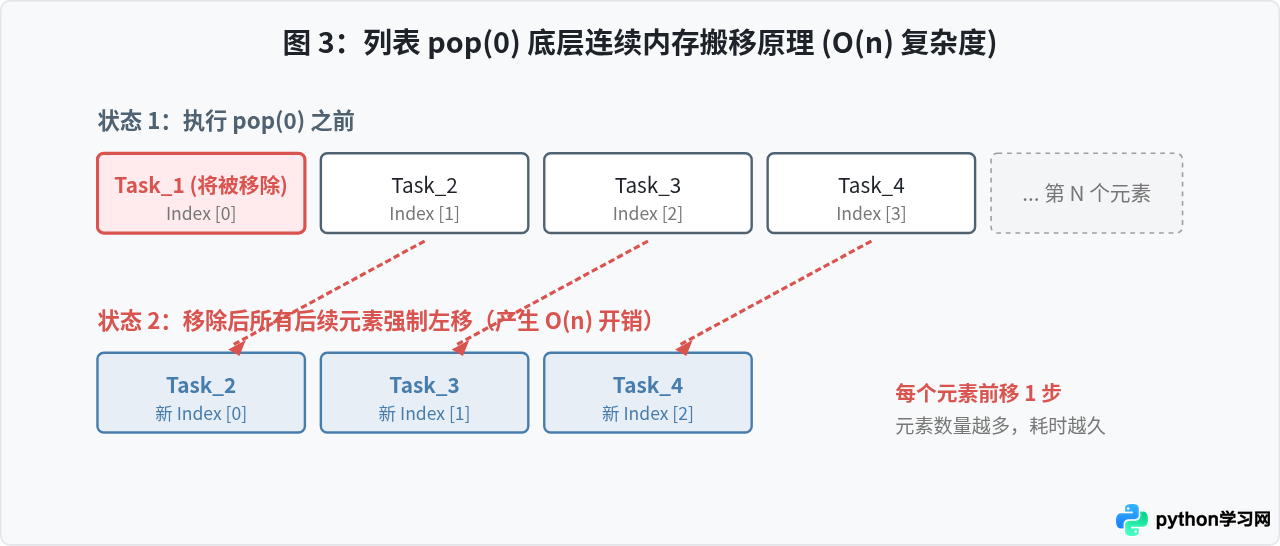
如果队列中有 10 万个任务,每次调用
queue.pop(0) 都会触发近 10 万次内存指针拷贝与移位。在大型循环处理任务时,程序耗时会呈现二次方 O(n²) 级剧增,导致系统明显卡顿甚至假死。
四、高性能队列标准解法:collections.deque
为了解决列表在队列操作中的性能缺陷,Python 在内置的标准库 collections 中提供了双端队列 deque(Double-Ended Queue)。
deque 在底层采用双向链表或分块块状列表实现,无论是从头部还是尾部进行添加或弹出操作,时间复杂度均为恒定的 O(1)。
1. deque 的使用示例
from collections import deque

# 步骤 1:初始化双端队列
dq = deque()

# 步骤 2:入队(与列表一样使用 append)
dq.append("Job_A")
dq.append("Job_B")
dq.append("Job_C")
print("当前 deque 状态:", dq)      # 示例输出:deque(['Job_A', 'Job_B', 'Job_C'])

# 步骤 3:高效出队(使用 popleft,避免内存整体搬移)
first_job = dq.popleft()
print("出队元素:", first_job)     # 示例输出:Job_A
print("剩余 deque:", dq)         # 示例输出:deque(['Job_B', 'Job_C'])
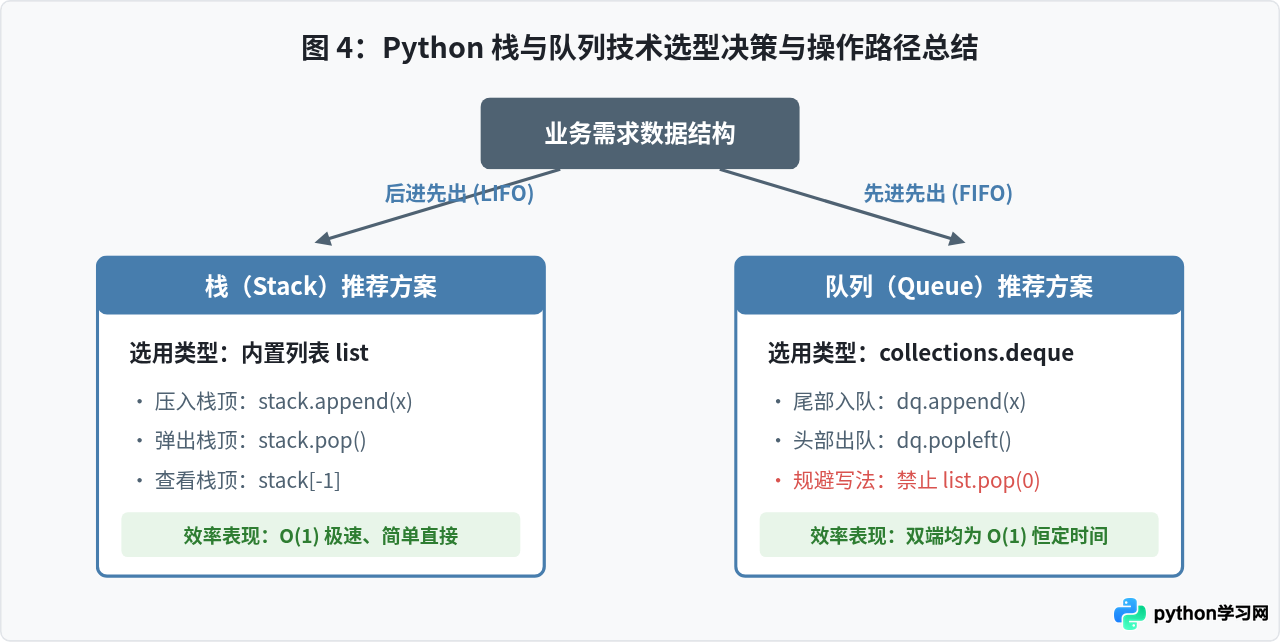
五、操作方法与选型总结
下表归纳了 Python 原生列表与 collections.deque 在实现栈与队列时的关键指标:
| 数据结构 | 推荐使用对象 | 入操作(方法与复杂度) | 出操作(方法与复杂度) | 适用场景与选型建议 |
|---|---|---|---|---|
| 栈(Stack) | 内置列表 list |
append()O(1) |
pop()O(1) |
优先推荐。原生内置、使用直观,性能极佳,非常适合算法题、状态回溯等。 |
| 队列(Queue) | 标准库 collections.deque |
append()O(1) |
popleft()O(1) |
强烈推荐。生产级队列、高频进出排队处理的首选,完全避免性能衰减。 |
| 简单队列(小型) | 内置列表 list |
append()O(1) |
pop(0)O(n) |
仅限极小数据量(元素量在几十以内),编写快速脚本测试使用,严禁大数据场景。 |
六、日常编码注意事项
- 空容器保护:无论是对空列表执行
pop()还是对空 deque 执行popleft(),都会抛出IndexError: pop from empty list(或empty deque)。在弹出前应始终使用if stack:或if queue:校验容器是否非空。 - 线程安全场景:Python 的
list与collections.deque并非为复杂多线程消费者模型设计。若处于多线程生产消费环境中,应当优先选用标准库queue.Queue或queue.LifoQueue,它们自带线程锁与阻塞等待机制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









