

怎么从零构建RAG知识库:数据清洗、分块与向量化全流程

很多开发者在初次接触检索增强生成(RAG)时,往往将精力过度集中在最后的大模型调用或提示词工程上,却忽视了决定系统上限的“地基”——知识库本身的质量。当用户提问得不到准确回答,或者模型开始“胡言乱语”时,问题通常不出在模型不够聪明,而在于喂给它的知识碎片是混乱、断裂甚至充满噪声的。
构建一个高质量的RAG知识库,本质上是一场对非结构化数据的精细化治理。它不是简单的文件上传,而是一个包含数据清洗、智能分块和向量化嵌入的严密流水线。只有当每一个环节都经过精心设计,检索到的上下文才能真正成为大模型的“外脑”,而不是干扰判断的噪音。
数据清洗:去除噪声比增加数据更重要
原始数据往往充满了各种“杂质”。PDF中的页眉页脚、网页中的导航菜单、代码注释里的无关字符,甚至是OCR识别产生的乱码,都会严重干扰向量空间的分布。如果直接将这些脏数据入库,检索系统很可能会因为匹配到了高频但无意义的词汇(如“版权所有”、“下一页”)而返回错误片段。
清洗的第一步是格式统一与元数据提取。不同来源的数据需要转换为统一的纯文本或Markdown格式。在这个过程中,保留文档的结构信息至关重要。例如,将PDF标题转换为Markdown的#标签,不仅有助于后续的分块,还能让模型理解内容的层级关系。同时,应提取文件名、创建时间、作者等元数据,这些字段将在后续的混合检索中发挥过滤作用。
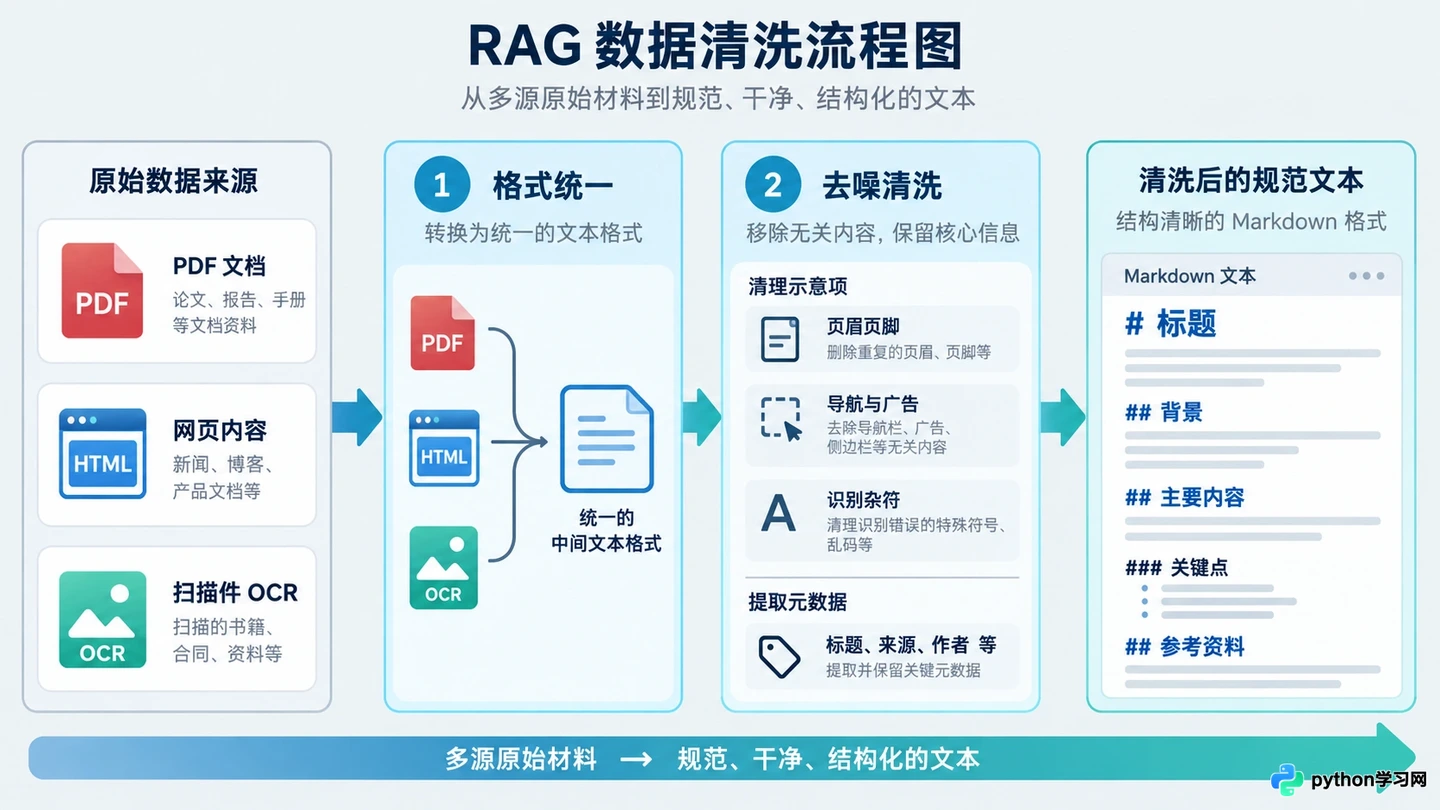
从原始多源数据到纯净文本的清洗流水线示意
接下来是针对性的去噪。对于网页数据,需要移除HTML标签、脚本代码和广告内容;对于扫描件,需通过正则表达式清理OCR产生的特殊符号和断行错误。一个有效的策略是建立“停用词表”和“噪声模式库”,自动识别并剔除那些在特定业务场景下毫无意义的高频片段。记住,少而精的数据永远优于多而杂的垃圾。在这一阶段,宁可误删少量边缘信息,也要保证核心知识块的纯净度。
智能分块:在语义完整与检索粒度间寻找平衡
分块(Chunking)是RAG系统中最具艺术性的环节。块太大,包含过多无关信息,会稀释关键信号的向量权重,导致检索不精准,且占用宝贵的上下文窗口;块太小,则可能切断句子或逻辑链条,使大模型无法理解完整含义。
传统的固定字符数分块(如每500字切一刀)虽然简单,但极易造成语义断裂。更优的策略是采用基于语义的分块方法。例如,利用自然语言处理工具识别段落边界、句子结束符,确保每个块的结尾是一个完整的语义单元。对于代码库,应按函数或类进行分割;对于法律合同,则应按条款划分。
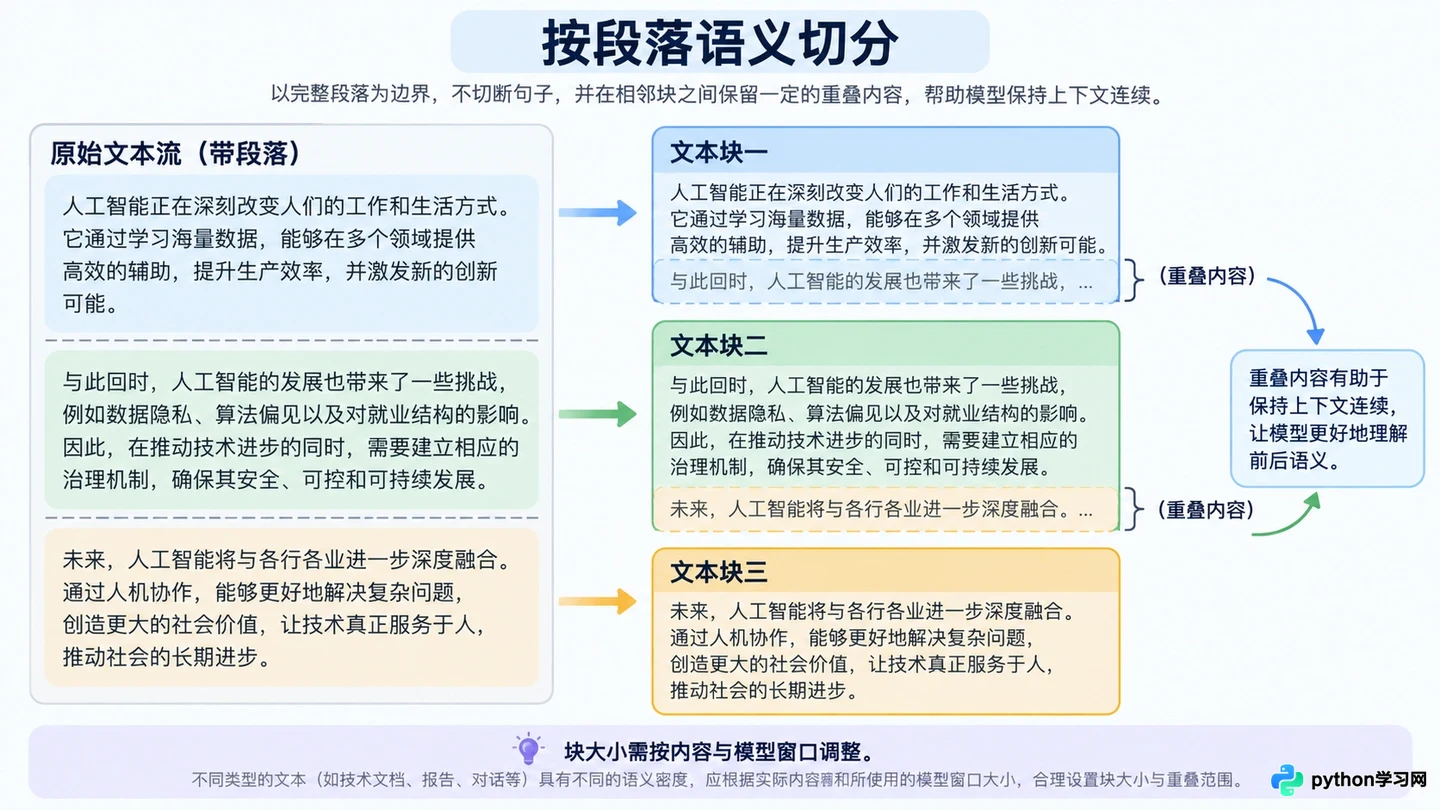
基于语义的分块策略与重叠窗口机制
为了解决跨块信息丢失的问题,引入“重叠窗口”(Overlap)是行业标准做法。即在相邻的两个块之间保留一定比例的重复内容(如10%-20%)。这样,即使关键词落在前一个块的末尾,也能在后一个块的开头被捕捉到,从而保证检索的连续性。此外,还可以尝试“父子索引”策略:将大块用于存储完整语境,小块用于向量检索。当小块被命中时,系统返回其所属的整个大块给大模型,既保证了检索的灵敏度,又提供了充足的推理背景。
向量化:选择适合领域的嵌入模型
向量化是将文本转化为计算机可理解的高维数字的过程。这一步的核心在于嵌入模型(Embedding Model)的选择。通用的嵌入模型(如text-embedding-ada-002或bge-m3)在大多数日常场景下表现良好,但在垂直领域(如医疗、金融、法律)往往力不从心。
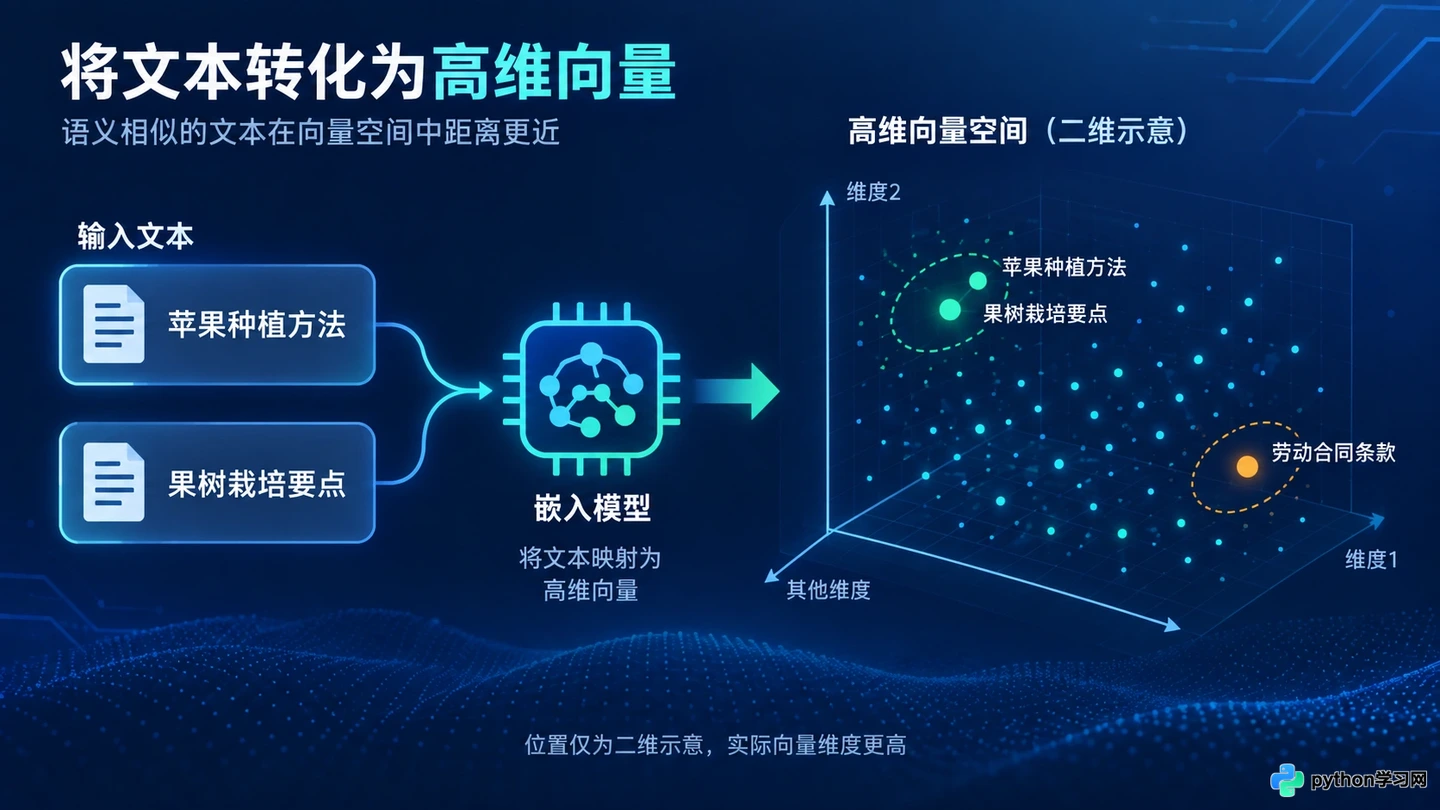
文本片段转化为高维向量空间的过程
如果知识库包含大量专业术语,建议使用针对特定领域微调过的嵌入模型,或者采用混合嵌入策略。例如,将通用模型与领域专用模型的结果加权融合。在向量化过程中,还需注意文本的长度限制。大多数模型有最大Token限制,超长的文本会被截断,导致信息丢失。因此,在前面的分块阶段就必须严格控制块的大小,使其适配所选模型的输入窗口。
另一个常被忽视的细节是查询与文档的对齐。用户在搜索时使用的语言风格可能与文档截然不同。为了缓解这一问题,可以在向量化之前对文档进行“假设性问题生成”(HyDE),即为每个文档块生成几个可能的问题,并将这些问题也向量化存入索引。这样,当用户提出类似问题时,能更直接地匹配到相关文档,显著提升召回率。
索引与验证:闭环优化的起点
数据进入向量数据库并非终点,而是验证的开始。构建完知识库后,必须进行“黄金集”测试。准备一组典型的问答对,手动标记出正确的参考文档,然后运行检索流程,计算命中率(Hit Rate)和平均倒数排名(MRR)。
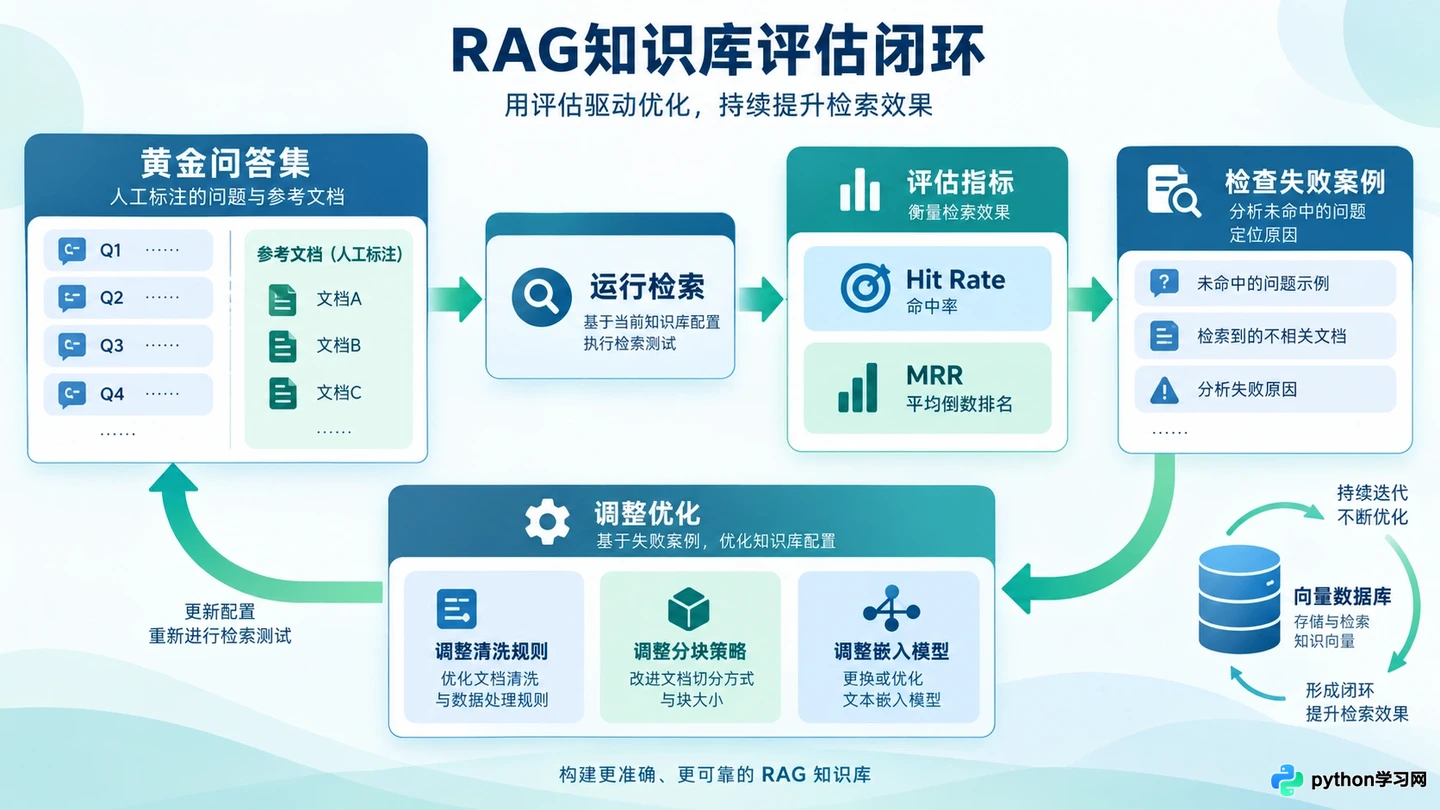
基于黄金集测试的检索效果评估与优化循环
如果发现某些关键问题无法检索到正确答案,需要回溯检查:是分块切断了关键信息?是清洗过程误删了术语?还是嵌入模型未能理解该领域的语义?RAG系统的优化是一个迭代过程,没有一劳永逸的配置。通过持续监控检索失败案例,不断调整清洗规则、分块大小和模型参数,才能让知识库真正具备“智慧”。
构建RAG知识库不仅是技术实现,更是对知识结构的重新梳理。它要求我们从用户的提问视角出发,反向审视数据的组织方式。只有当数据清洗得足够干净、分块切得足够合理、向量映射得足够准确,大模型才能站在巨人的肩膀上,给出令人信服的答案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









