

AI写作检测能准确识别中文吗?多语言支持能力与局限性分析

刚把一篇精心打磨的中文稿件扔进检测器,结果红灯亮起,提示“90% AI生成”。你心里可能咯噔一下:这明明是我熬夜查资料、逐字推敲出来的,怎么就被判定为机器写的了?这种委屈感,在中文创作者中并不罕见。
其实,问题大概率不出在你的文笔上,而是出在检测工具的“偏科”上。目前市面上主流的AI写作检测工具,绝大多数是基于英语语料库训练的。当它们面对中文时,就像让一个只精通英语的老师去批改中文作文,虽然能看懂大概意思,但对细微的语感、逻辑转折和文化隐喻往往抓不准。
为什么中文检测容易“翻车”
AI检测的核心逻辑通常是寻找文本中的统计规律,比如词频分布、句子长度的变化以及特定连接词的使用习惯。英语有着严格的语法结构和丰富的形态变化,这些特征很容易被算法捕捉。但中文不同,它更依赖语境和意合,句子结构灵活,缺乏明显的形态标记。
这就导致了一个尴尬的局面:许多在英文中被视为“AI特征”的模式,在中文里可能是正常的表达习惯。反之,一些为了规避检测而故意加入的“人类噪音”,在中文语境下可能显得生硬且不合逻辑。因此,工具对中文的误报率(把人类写的判为AI)和漏报率(把AI写的判为人类)都显著高于英文。
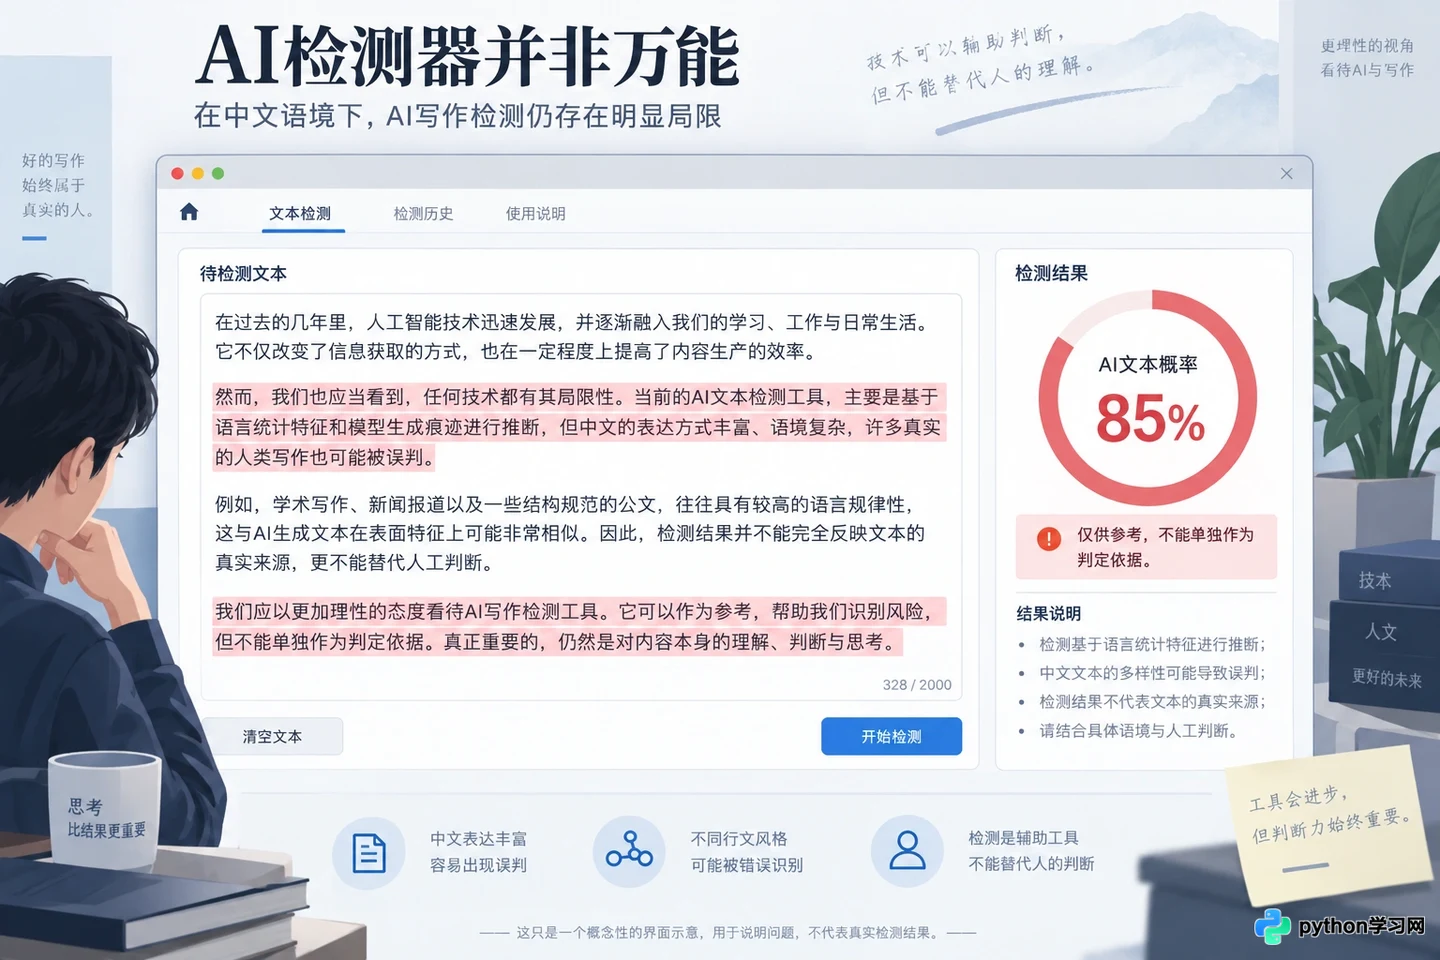
检测工具界面上,一段中文文本被高亮标记为,旁边显示较高的置信度百分比,突显误报现象。
主流工具的多语言支持现状
如果你仔细观察各大检测平台的说明文档,会发现一个共同点:它们对英语的支持是最成熟的,其次是西班牙语、法语等欧洲语言。对于中文,大多数工具要么标注为“测试版”,要么干脆不提供详细的准确率数据。
以Turnitin为例,它在学术英语领域的权威性毋庸置疑,但在处理中文文献时,其AI检测模块的表现就大打折扣。其他一些新兴的商业检测器,虽然宣称支持多语言,但底层模型往往还是基于翻译后的英文特征进行比对,这种“转译检测”的方式进一步放大了误差。
这意味着,当你看到一份中文检测报告时,上面的百分比更多是一个参考区间,而不是确凿的证据。它告诉你这段文字“看起来”有点像AI生成的风格,但不能证明它“就是”AI生成的。
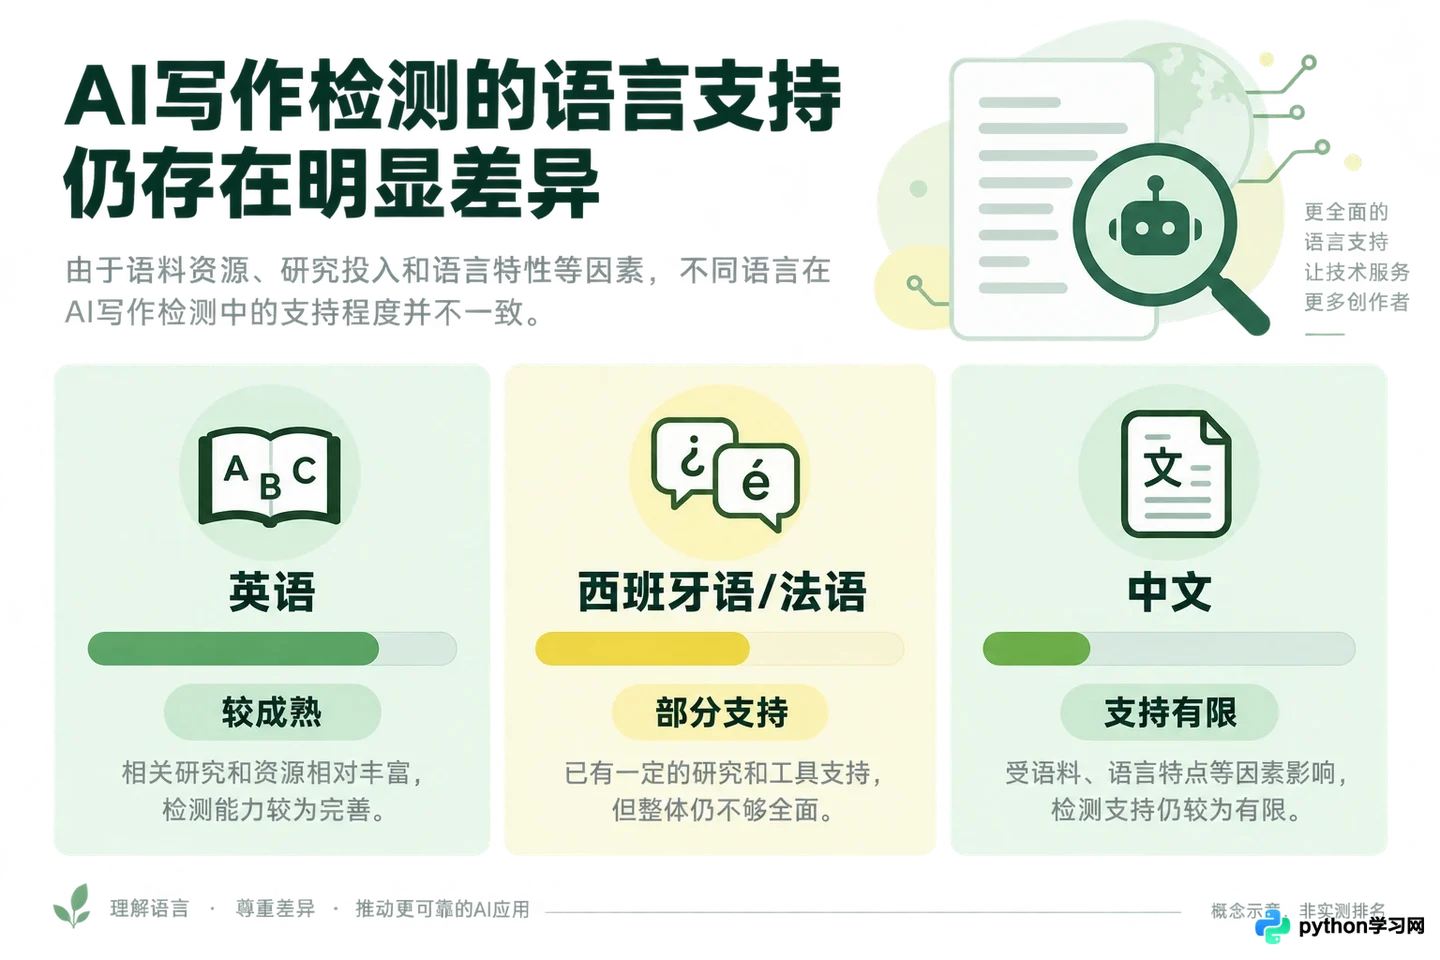
柱状图或雷达图展示主流检测工具对英语、西班牙语和中文的支持成熟度差异,英语区域明显更大。
技术瓶颈:数据偏差与模型泛化
造成这种差异的根本原因,在于训练数据的偏差。大型语言模型(LLM)在训练时,摄入的英文高质量文本远远多于中文。因此,AI生成的英文文本具有高度的一致性,而AI生成的中文文本则可能因为模型对中文理解的不足,呈现出一种“翻译腔”或逻辑跳跃。
检测工具在学习这些特征时,也受到了同样的数据限制。它们学会了识别英文AI的“平滑感”,却难以精准定义中文AI的“生硬感”或“过度修饰”。此外,中文的同义词丰富度极高,同一个意思可以有无数种表达方式,这使得基于统计规律的检测方法在中文面前显得力不从心。
另一个瓶颈是模型的泛化能力。随着中文大模型的快速迭代,AI生成的中文质量正在迅速提升,越来越接近人类专家的水平。检测工具如果不能同步更新其中文训练集,就会陷入“猫鼠游戏”的被动局面,昨天的检测规则今天可能就失效了。
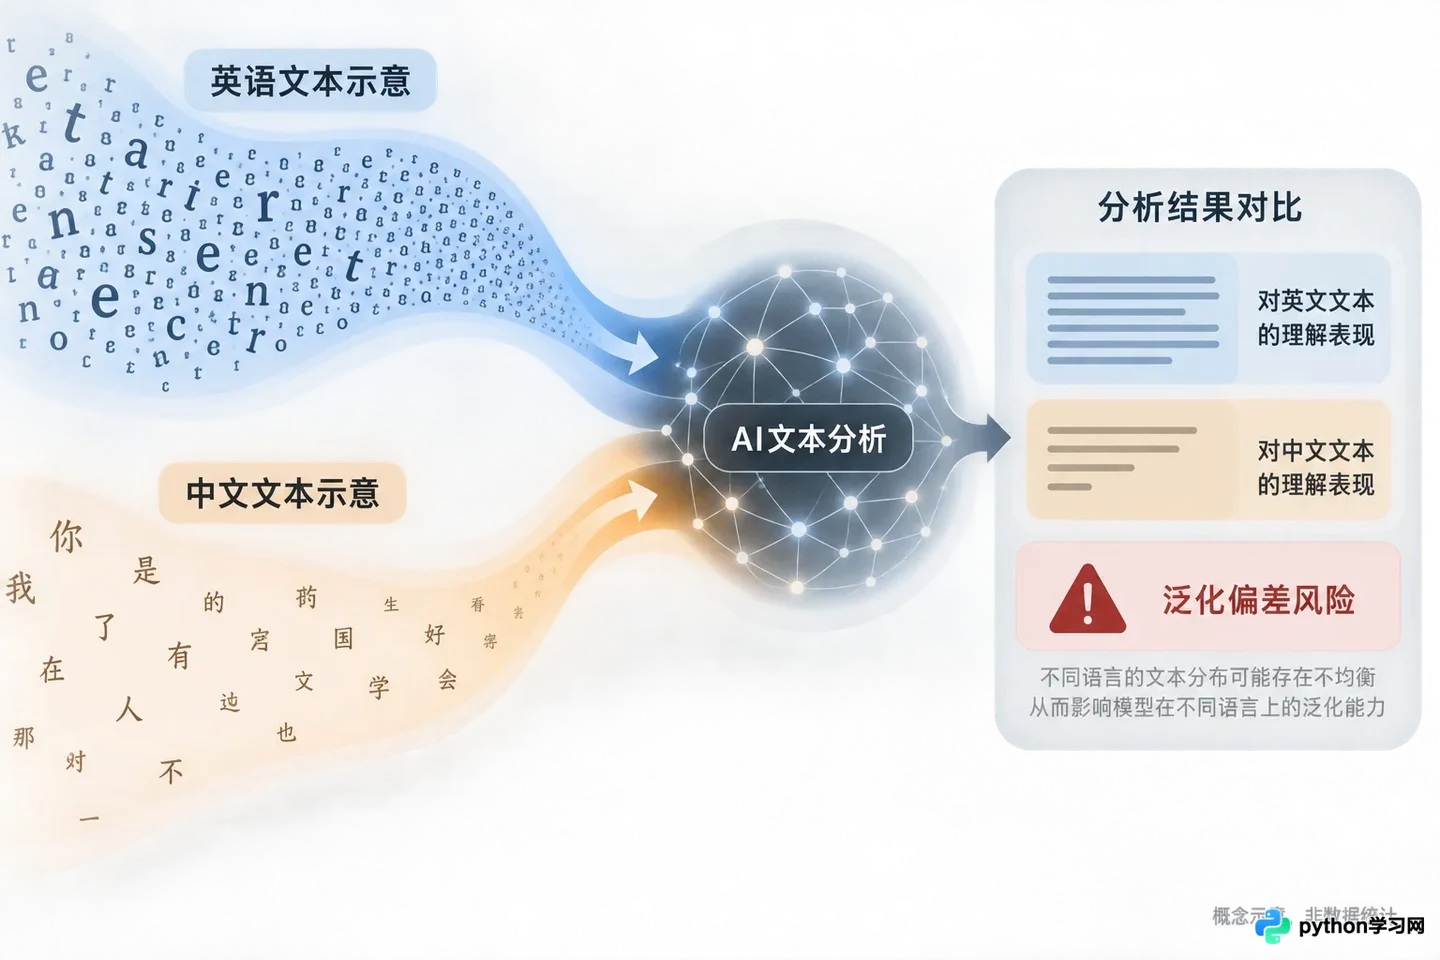
抽象图示展示英文数据量大而中文数据量小,导致检测模型在中文特征提取上的偏差。
如何理性看待和使用检测结果
既然工具不完美,我们该怎么办?首先,不要迷信单一的检测分数。如果必须使用检测工具,建议采取“组合拳”策略:同时使用两到三个不同品牌的检测器,观察它们的结果是否有共识。如果所有工具都给出高概率的AI判定,那确实需要警惕;如果结果参差不齐,则更可能是工具的误差。
其次,关注文本的具体问题而非总分。仔细查看检测报告中标记为高风险的段落,看看是因为用词过于套路化,还是逻辑连接过于生硬。这些具体的反馈比一个冰冷的百分比更有价值,能帮助你针对性地修改文稿,使其更具“人味”。
最后,保留创作过程证据。对于重要的原创内容,保存好草稿、修改记录、参考资料列表等,这些是证明人类创作过程的最有力证据。在争议发生时,过程证据远比检测结果更有说服力。
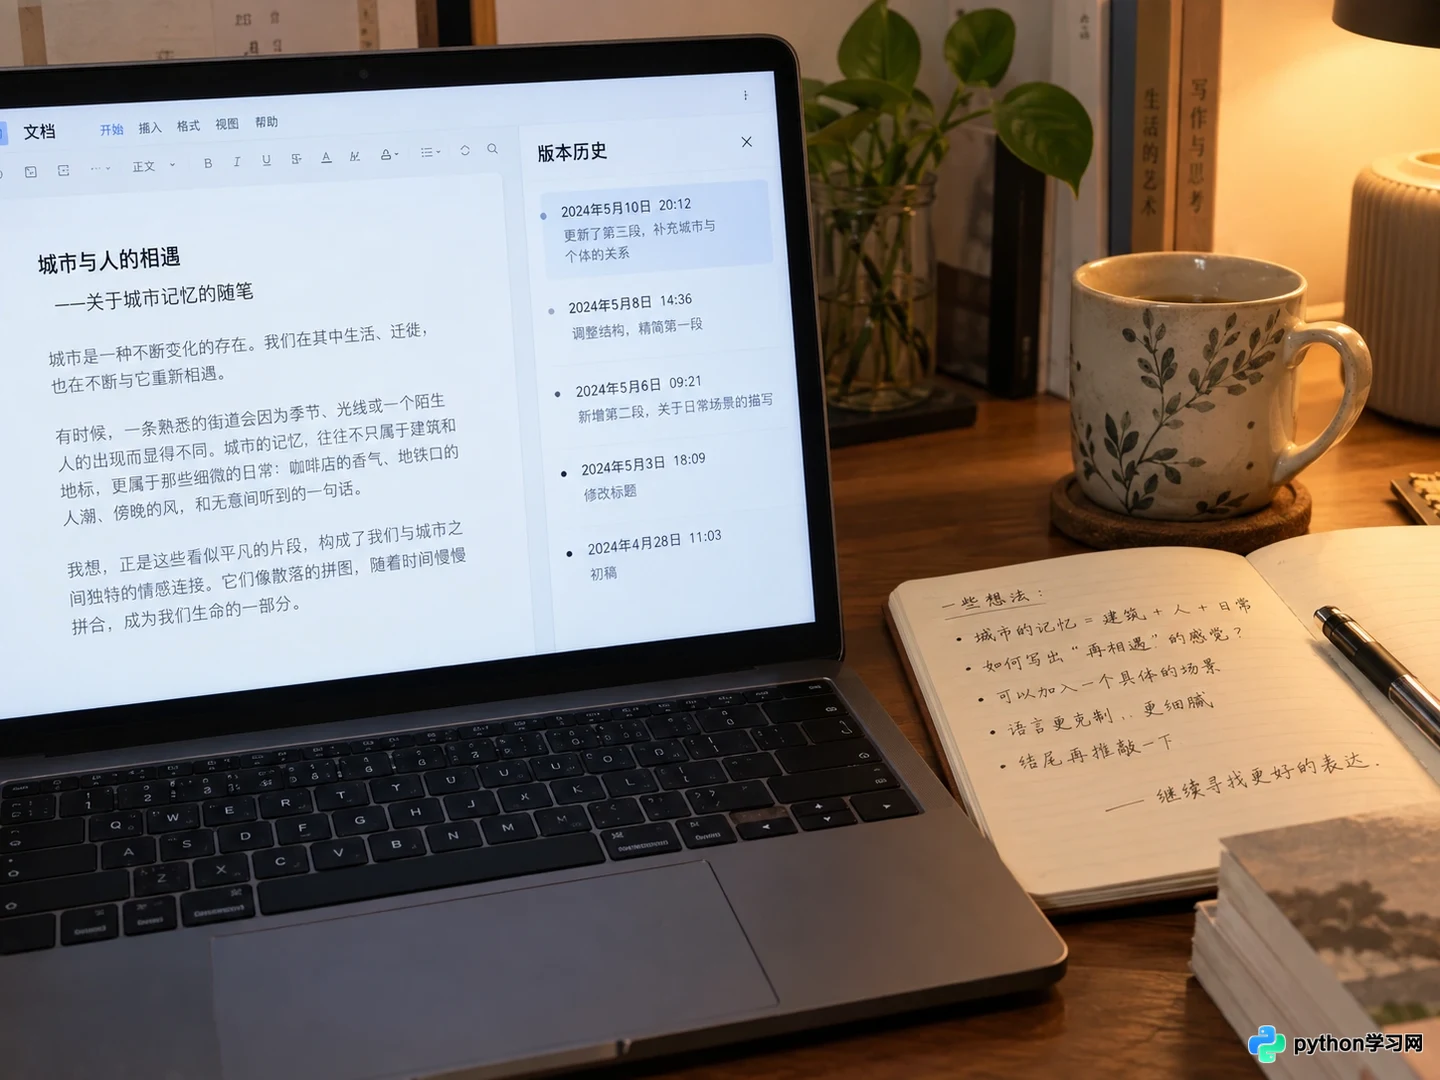
桌面上摆放着笔记本电脑和笔记本,屏幕上显示文档的版本历史记录,象征保留创作过程证据。
技术仍在进步,但目前的AI写作检测工具在中文领域还远未达到“一锤定音”的程度。把它当作一个辅助检查的“体检仪”,而不是判定生死的“法官”,或许是我们当下最明智的选择。毕竟,文字背后的思考与情感,才是机器最难复制的灵魂。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









