

Python爬虫怎么处理JavaScript动态加载页面:Selenium实战指南

当常规爬虫使用 Requests 或 urllib 获取网页时,返回的 HTML 源码常常只有空荡荡的骨架,关键的列表、价格或评论等数据完全不见踪影。这是因为现代网页广泛使用 Vue、React 或自研脚本在前端异步请求接口并动态渲染 DOM。解决此类问题的直接路径,是借助 Selenium 驱动真实的浏览器内核(如 Chromium),在脚本执行、DOM 树完整构建完毕后再行提取。本文将详细讲解这一机制的运作差异、完整配置步骤、显式等待的关键用法以及规避反爬检测的生产实践。
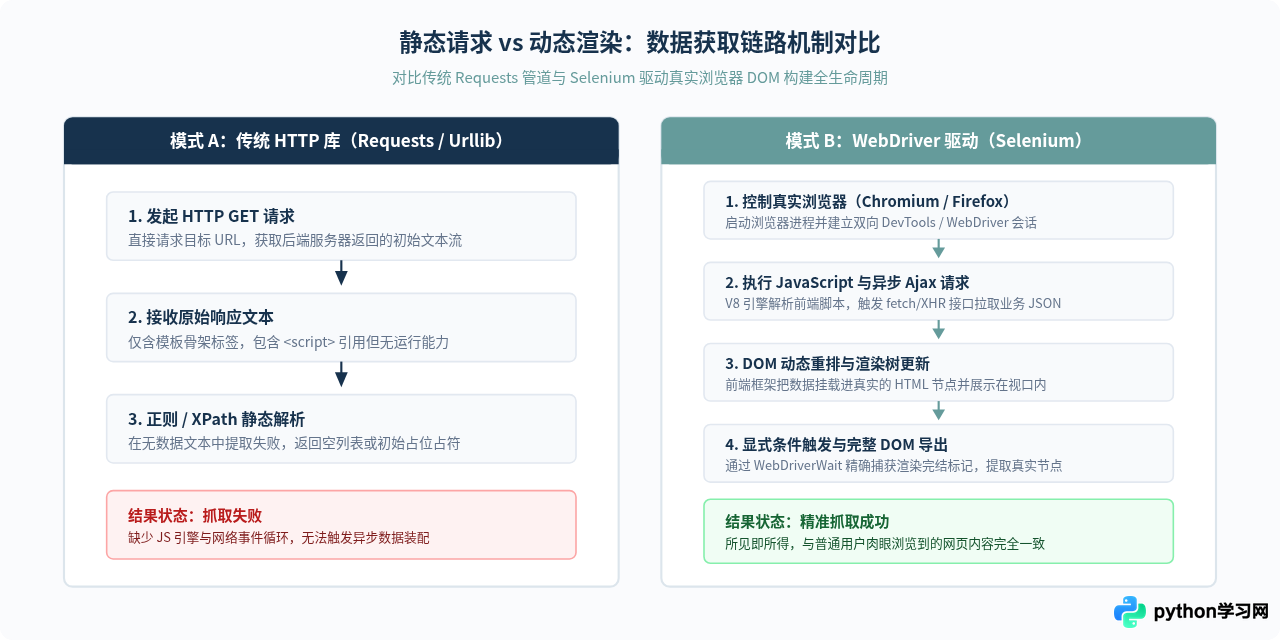
一、为什么常规请求抓不到动态数据:机制对比
常规 HTTP 请求库属于“单次响应截获”,仅接收服务器最初吐出的静态文本,本身不带 JavaScript 解释引擎,无法执行内联脚本或发起的 Ajax 请求。而 Selenium 通过 WebDriver 协议与浏览器引擎通信,允许页面加载完整的 HTML、CSS 和 JavaScript 并在渲染树中计算出真实的最终节点。
二、开发准备与驱动标准化配置
自 Selenium 4.6.0 版本起,官方内置了 Selenium Manager。以往手动下载与系统 Chrome 严格匹配的 chromedriver.exe 并配置环境变量的繁琐步骤已经被官方淘汰。现在只需安装现代版本的 Selenium,驱动会自动进行版本嗅探与静默配置。
1. 环境依赖安装
在目标 Python 环境(推荐 Python 3.8 及以上)中执行 pip 安装指令:
pip install selenium2. 初始化浏览器会话的标准模板
在编写抓取脚本时,必须针对无头模式(Headless)、反检测标志、视口尺寸等关键选项进行预设。以下是稳定运行的基础初始化代码:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.chrome.options import Options

def create_driver(headless: bool = True) -> webdriver.Chrome:
    options = Options()
    if headless:
        # 现代 Chromium 采用新版无头模式参数
        options.add_argument("--headless=new")

    # 常用防封与沙箱适配配置
    options.add_argument("--no-sandbox")
    options.add_argument("--disable-dev-shm-usage")
    options.add_argument("--disable-gpu")
    options.add_argument("--window-size=1920,1080")

    # 去除自动化控制提示栏与驱动标识
    options.add_experimental_option("excludeSwitches", ["enable-automation"])
    options.add_experimental_option("useAutomationExtension", False)

    # 自定义真实 User-Agent,避免暴露 HeadlessChrome 标记
    options.add_argument(
        "user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
    )

    # Selenium 4 自动接管驱动下载与路径绑定
    driver = webdriver.Chrome(options=options)

    # 注入 CDP 脚本抹除 navigator.webdriver 属性
    driver.execute_cdp_cmd(
        "Page.addScriptToEvaluateOnNewDocument",
        {"source": "Object.defineProperty(navigator, 'webdriver', {get: () => undefined})"}
    )
    return driver
三、实战操作全流程与核心步骤
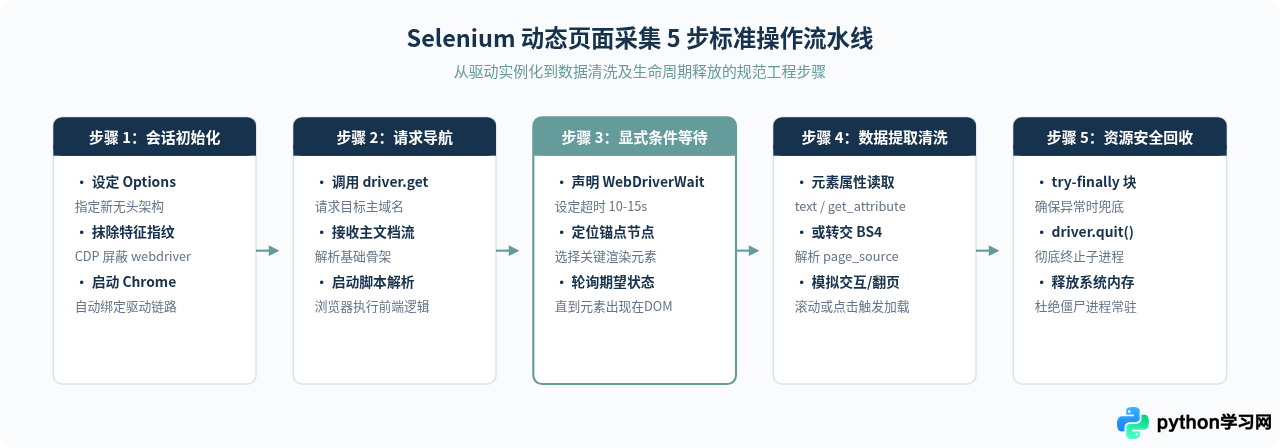
使用 Selenium 抓取动态页面的核心不在于“打开网页”,而在于“把控数据渲染的时机”。标准的处理流程分为五个阶段:配置启动、导航加载、条件侦听、数据抽取与受控退出。
四、等待机制的选择:为什么必须使用显式等待
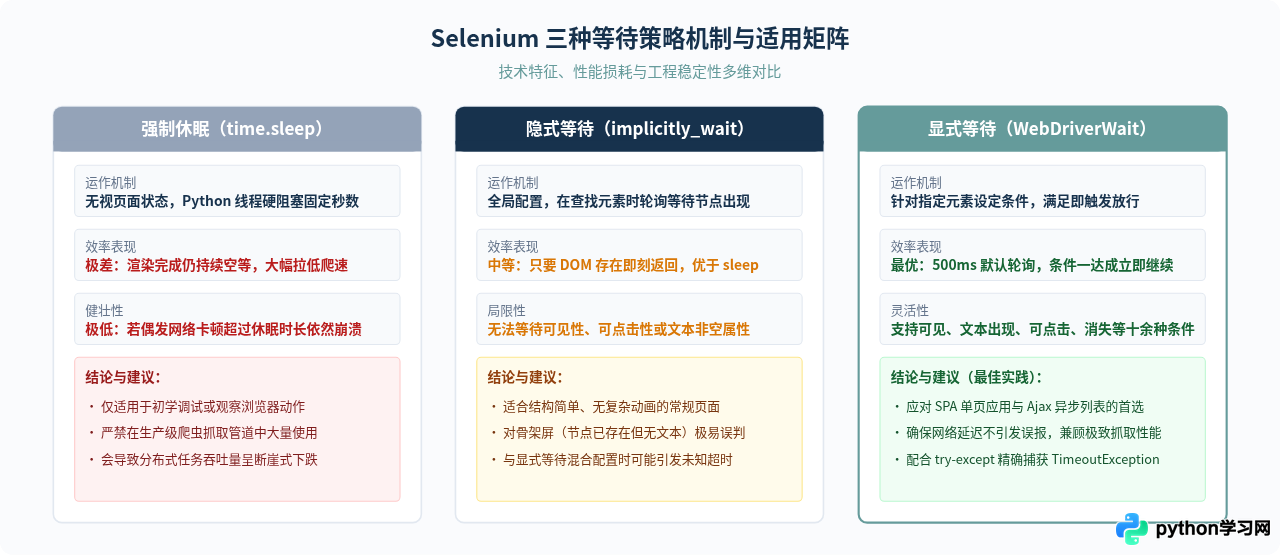
抓取动态页面时,最常见的报错是 NoSuchElementException。这是因为虽然 driver.get(url) 完成了主文档流的加载,但 JavaScript 的 Ajax 请求尚未返回,或者 DOM 尚未完成插值渲染。
初学者容易使用 time.sleep(5) 进行硬编码休眠。这种做法在网络波动时依然会因超时报错,而在网速极快时又会白白浪费数秒时间,大幅拖垮多页抓取效率。Selenium 提供了三种等待机制,其实际对比如下:
显式等待的工程化代码范式
显式等待主要通过 selenium.webdriver.support.ui.WebDriverWait 和 selenium.webdriver.support.expected_conditions(简称 EC)实现:
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from selenium.common.exceptions import TimeoutException

def fetch_dynamic_product_list(driver, target_url: str):
    driver.get(target_url)

    # 声明等待器:最长等待 12 秒,每 500ms 轮询一次
    wait = WebDriverWait(driver, timeout=12, poll_frequency=0.5)

    try:
        # 1. 显式等待:确保至少出现一个商品列表卡片
        product_cards = wait.until(
            EC.presence_of_all_elements_located((By.CSS_SELECTOR, "div.product-card"))
        )

        # 2. 遍历提取数据
        results = []
        for card in product_cards:
            # 在已定位的节点内查找子元素
            title = card.find_element(By.CSS_SELECTOR, "h3.title").text.strip()
            price = card.find_element(By.CSS_SELECTOR, "span.price").text.strip()
            link = card.find_element(By.CSS_SELECTOR, "a").get_attribute("href")
            results.append({"title": title, "price": price, "link": link})

        return results

    except TimeoutException:
        # 当超过 12 秒关键元素仍未渲染时触发
        print(f"[警告] 页面加载超时或选择器已失效: {target_url}")
        return []
五、处理常见复杂场景:滚动加载与模拟点击
现代网站为了节省带宽,常采用瀑布流或“点击加载更多”来代替传统分页。这类场景需要向浏览器发送交互指令。
1. 滚动页面触发懒加载(Infinite Scroll)
很多商品或图文列表只有滚动到视口下方时,才会向后台请求下一批数据。可以通过执行原生 JavaScript 脚本来控制页面平滑滚动:
def scroll_to_bottom(driver, max_scrolls: int = 5, pause_time: float = 1.5):
    last_height = driver.execute_script("return document.body.scrollHeight")

    for _ in range(max_scrolls):
        # 执行平滑滚动到底部
        driver.execute_script("window.scrollTo(0, document.body.scrollHeight);")

        # 适当缓冲,等待滚动事件触发的异步数据返回
        time.sleep(pause_time)

        new_height = driver.execute_script("return document.body.scrollHeight")
        if new_height == last_height:
            # 高度未发生变化,说明已到达最后一页
            break
        last_height = new_height
2. 点击“加载更多”按钮
如果页面底部存在“加载更多”按钮,应当使用显式等待确保该按钮处于“可被点击(element_to_be_clickable)”状态,再执行点击:
def click_load_more(driver):
    wait = WebDriverWait(driver, 10)
    try:
        load_more_btn = wait.until(
            EC.element_to_be_clickable((By.CSS_SELECTOR, "button.load-more-btn"))
        )
        # 如果普通 click() 被遮挡,可采用 JS 强制触发
        driver.execute_script("arguments[0].click();", load_more_btn)
    except TimeoutException:
        print("未找到加载更多按钮或所有数据已加载完毕。")
六、性能优化与生产防踩坑指南
由于 Selenium 启动了完整的浏览器进程,其内存开销和 CPU 占用远高于轻量级的 Requests。为了在生产环境中稳定抓取,需要综合考虑资源管控、网络过滤和反爬防御。
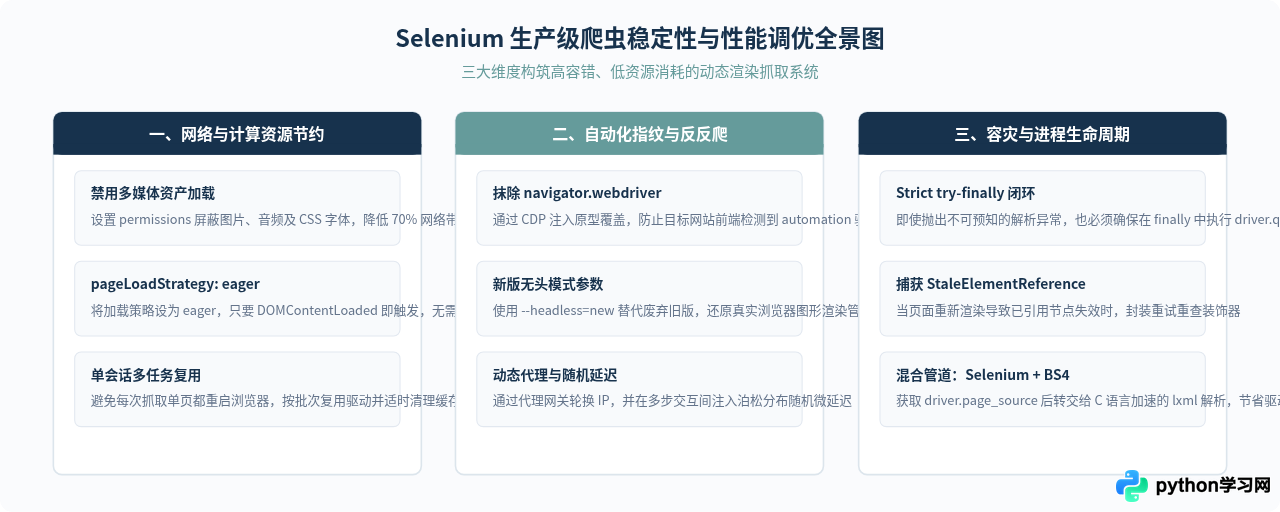
1. 加速网页加载:禁用图片与设置 eager 策略
抓取文本数据时,渲染高分辨率图片和字体文件只会徒增等待时间。可在 ChromeOptions 中直接屏蔽多媒体资源的加载:
options = Options()
# 策略一:页面加载策略设为 eager(DOM解析完成即可,不等待静态资源加载完成)
options.page_load_strategy = "eager"

# 策略二:通过偏好设置全面禁用图片加载
prefs = {
    "profile.managed_default_content_settings.images": 2,
    "profile.default_content_setting_values.notifications": 2
}
options.add_experimental_option("prefs", prefs)
2. 防止产生孤儿/僵尸 Chrome 进程
很多开发者在代码中使用 driver.close(),但这只会关闭当前标签页,后端的 chromedriver 和 Chrome 子进程依然会驻留在系统内存中。长期高并发抓取会导致服务器内存爆满、负载飙升。
driver.quit() 彻底终结整个会话与底层进程树,并始终将该调用置于 finally 块中。
3. 混合搭配:Selenium 负责渲染,BeautifulSoup 负责解析
虽然 Selenium 自带 find_element 系列方法,但在大批量解析包含几千个节点的表格时,频繁跨进程调用 WebDriver 协议会导致性能严重下降。更优的架构是将两者结合:
from bs4 import BeautifulSoup

def fast_parse(driver):
    # 显式等待触发完毕后,一次性获取完整渲染后的 HTML 源码
    rendered_html = driver.page_source

    # 转交 BeautifulSoup 使用基于 C 语言的 lxml 高速解析
    soup = BeautifulSoup(rendered_html, "lxml")
    items = []
    for node in soup.select("div.item-row"):
        items.append({
            "name": node.select_one(".name").get_text(strip=True),
            "val": node.select_one(".val").get_text(strip=True)
        })
    return items
七、总结与最佳实践清单
面对 JavaScript 动态加载与单页应用,Selenium 是一套通用、所见即所得的利器。梳理其实操核心,只需掌握以下四个要点:
- 看透本质:静态请求拿到的是尚未装配数据的静态模版,Selenium 的优势在于调用完整浏览器引擎完成 JavaScript 运行与 DOM 重排。
- 善用现代特性:使用 Selenium 4 的 Selenium Manager 免除手动配置驱动版本的负担,并切换至
--headless=new获取真实渲染能力。 - 彻底抛弃强制等待:使用
WebDriverWait与expected_conditions组合,以事件或节点出现作为放行依据,兼顾可靠性与采集性能。 - 做好资源节约与回收:禁用图片下载、采用 eager 加载策略,并用
try...finally: driver.quit()严格规范进程生命周期。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









