

Python统计含Emoji字符串的实际显示长度

len() 往往会导致排版完全错位。解决这个问题的核心路径在于区分字符的“内存码点数量”与“终端栅格显示宽度”:在现代终端规范中,大部分 Emoji 和中文字符均占据两个半角字符显示单元(2 Columns / Cells)。通过借助成熟的 rich.cells.cell_len 或标准库结合 Unicode 规范处理,可以准确获取字符串在屏幕上的实际视觉宽度。
为什么 len() 无法衡量 Emoji 的实际视觉宽度
Python 3 中的字符串以 Unicode 码点(Code Point)为基本处理单元。调用 len() 时,返回的是字符串内码点的总个数,而不是该字符串在屏幕或控制台终端打印时占用的字符格数(Cell Width)。
在实际显示场景下,字符宽度通常分为单宽(1个西文半角宽度)和双宽(2个西文半角宽度,即1个标准汉字或全角字符宽度)。然而 Emoji 的编码结构极其特殊:有的由单个高位码点构成,有的则由多个码点通过零宽连字符(ZWJ, \u200D)或变体选择符拼合而成。
# 示例:不同字符在 len() 下的计数差异
s_ascii = "Python"
s_cjk = "你好"
s_single_emoji = "😀"
s_zwj_emoji = "👨💻" # 由 男人(\U0001F468) + 零宽连字符(\u200D) + 电脑(\U0001F4BB) 构成
s_flag_emoji = "🇨🇳" # 由 区域指示符号 C(\U0001F1E8) + N(\U0001F1F3) 构成
print(len(s_ascii)) # 输出: 6 (视觉宽度: 6)
print(len(s_cjk)) # 输出: 2 (视觉宽度: 4)
print(len(s_single_emoji)) # 输出: 1 (视觉宽度: 2)
print(len(s_zwj_emoji)) # 输出: 3 (视觉宽度: 2)
print(len(s_flag_emoji)) # 输出: 2 (视觉宽度: 2)
从上面的示例可以看到:复杂复合 Emoji“👨💻”虽然在屏幕上只呈现为一个图标、占据 2 个字符位,但在 Python 内部包含 3 个 Unicode 码点;如果直接依据 len() 补充空格做补齐对齐(如 str.ljust()),就会出现严重的视觉偏移。
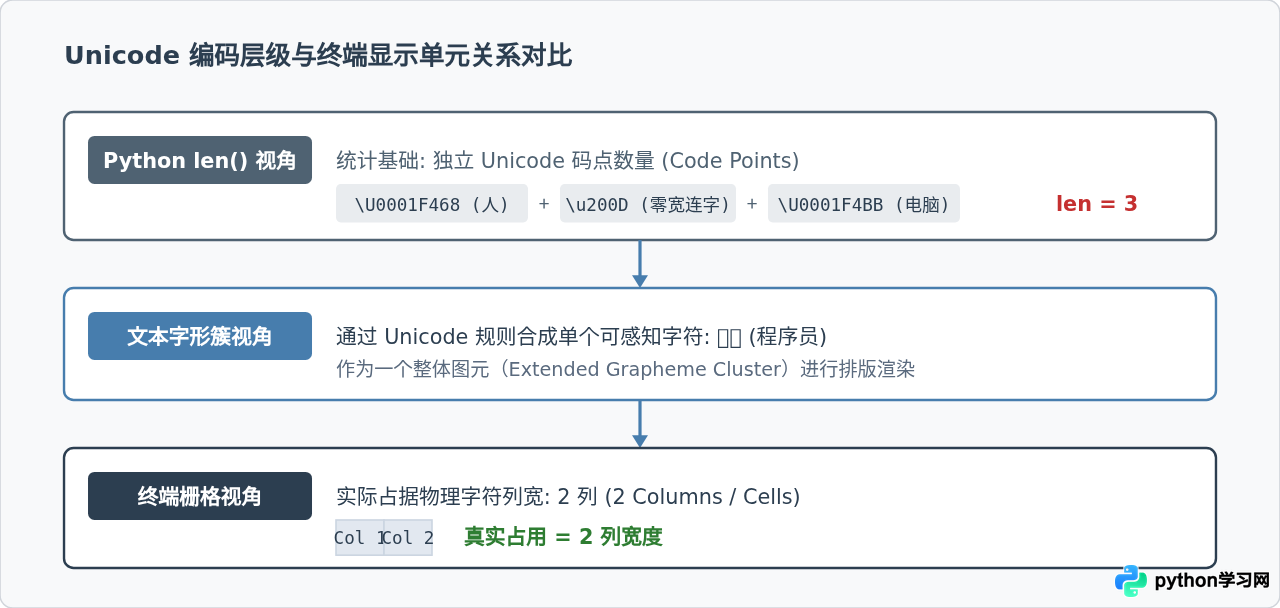
图 1:Unicode 编码层级与终端实际物理列宽的映射差异
主流解决手段对比与深度剖析
针对字符宽度的测量,社区与标准库先后出现过多种思路。理解各方案的适用边界,是写出稳定排版代码的前提。
1. 标准库 unicodedata.east_asian_width
Python 标准库提供了 unicodedata.east_asian_width(char),它是根据 Unicode 报告 UAX #11 进行的东亚文字宽度属性分类。它返回以下字符标识:
'W'(Wide,全角)或'F'(Fullwidth):占据 2 个字符列(如汉字、全角标点)。'Na'(Narrow,窄)、'H'(Halfwidth,半角)或'N'(Neutral,中性):通常占据 1 个字符列。
缺陷:该函数必须接收单个字符(长度为 1 的字符串)。对于由多个字符拼合而成的复合 Emoji(如 👨💻),如果拆开循环调用,零宽连字符可能返回 'N'(被记为1),导致最终计算结果偏大。因此,仅使用 unicodedata 无法妥善处理现代复杂 Emoji。
2. wcwidth 库
wcwidth 是 POSIX 标准 wcwidth() 和 wcswidth() 在 Python 上的成熟移植,被广泛用于命令行交互库。它能准确计算许多单个宽字符和基础 Emoji 的宽度。但对于包含 ZWJ 序列的复合 Emoji,在部分版本中依然可能因为未完全合并字形簇而产生轻微偏差。
3. rich.cells.cell_len(生产环境首选)
rich 是现代 Python 最优秀的终端渲染库。其内部子模块 rich.cells 专门封装了针对终端栅格宽度的高精度计算函数 cell_len()。它不仅内置了完善的 Unicode 字符表,还完整处理了 Emoji 变体选择符(VS16)、零宽字符序列及双宽特性,是目前最为稳健的方案。
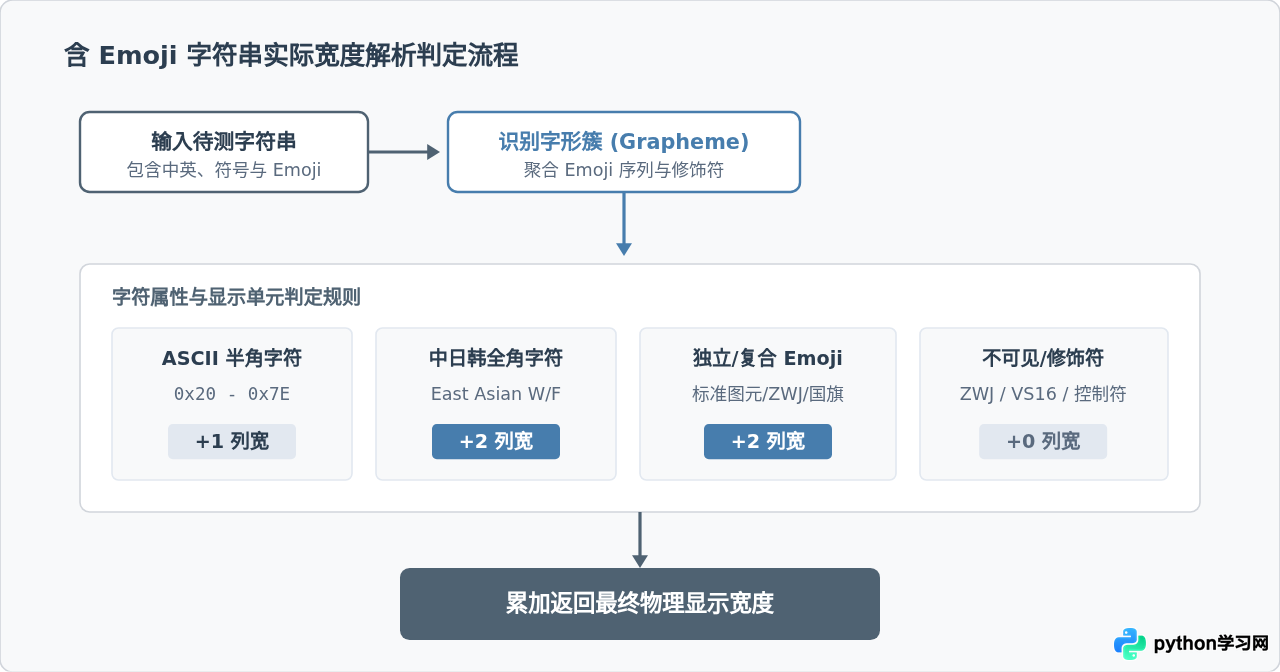
图 2:字符串实际物理显示宽度判定流程
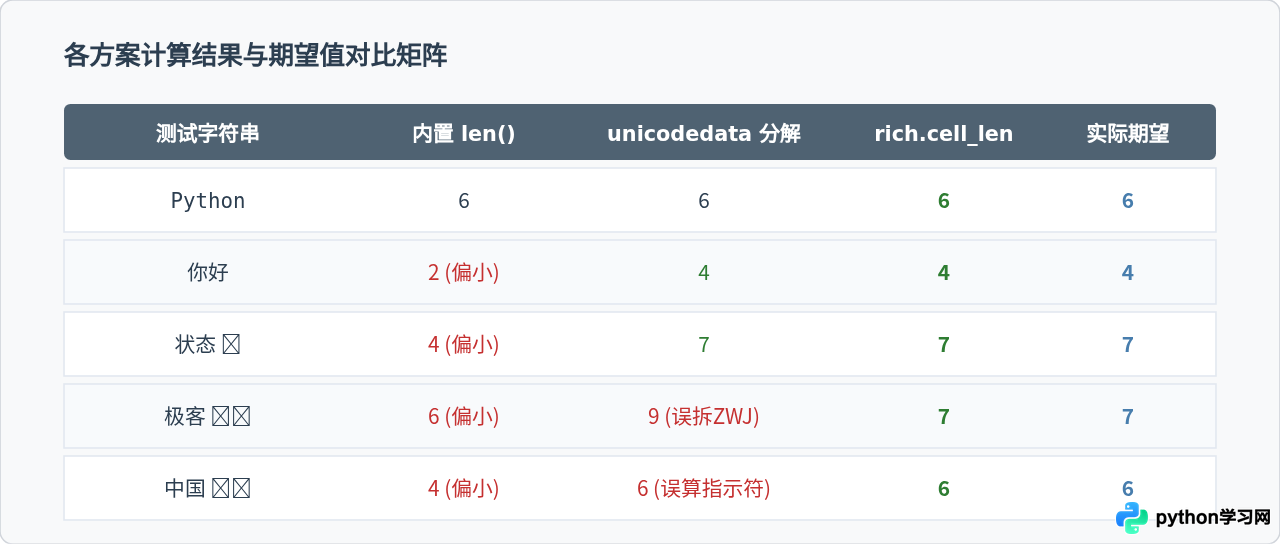
图 3:不同技术方案在各类复杂文本下的输出对比
实际落地代码与对齐实战
方案一:使用 Rich 库(最推荐做法)
如果项目中允许安装第三方依赖,直接安装并引入 rich 是最可靠、维护成本最低的做法:
pip install rich编写测量与对齐函数:
from rich.cells import cell_len
def pad_string(text: str, target_width: int, fill_char: str = " ") -> str:
"""
根据字符在终端的实际显示宽度进行填充对齐
:param text: 原始文本
:param target_width: 目标显示宽度(以西文半角为基准)
:param fill_char: 填充字符(默认为半角空格)
:return: 填充后的字符串
"""
current_width = cell_len(text)
padding_needed = max(0, target_width - current_width)
return text + (fill_char * padding_needed)
# 测试示例
items = [
("Python", "正常"),
("数据分析 📊", "进行中"),
("技术专家 👨💻", "已完成"),
("北京 🇨🇳", "在线"),
]
print("=" * 35)
print(f"{pad_string('项目名称', 20)} | 状态")
print("-" * 35)
for name, status in items:
print(f"{pad_string(name, 20)} | {status}")
print("=" * 35)在终端执行上述代码后的示例输出:
===================================
项目名称 | 状态
-----------------------------------
Python | 正常
数据分析 📊 | 进行中
技术专家 👨💻 | 已完成
北京 🇨🇳 | 在线
===================================方案二:无第三方依赖的标准库自实现
如果你的项目处于受限环境(如纯净打包镜像、不便引入第三方包),可以通过正则表达式提取 Emoji 字形簇,并结合 unicodedata.east_asian_width 自行编写测量逻辑:
import re
import unicodedata
# 匹配常见 Emoji、ZWJ复合序列及国旗指示符的正则模式
EMOJI_PATTERN = re.compile(
r"("
r"[\U0001F1E6-\U0001F1FF]{2}|" # 区域指示符号(国旗,如 🇨🇳)
r"[\U0001F300-\U0001FAFF]" # 主 Emoji 范围
r"(?:[\U0001F3FB-\U0001F3FF])?" # 可选肤色修饰符
r"(?:\u200D[\U0001F300-\U0001FAFF]" # 零宽连字符拼合的下一段
r"(?:[\U0001F3FB-\U0001F3FF])?)*"
r"|\u2700-\u27BF|\u2600-\u26FF" # 常用杂项符号与象形文字
r")"
)
def get_display_width(text: str) -> int:
"""
纯标准库计算字符串显示宽度
"""
total_width = 0
# 按照 Emoji 模式拆分字符串
tokens = EMOJI_PATTERN.split(text)
for token in tokens:
if not token:
continue
# 如果当前分词匹配到了 Emoji
if EMOJI_PATTERN.fullmatch(token):
total_width += 2
else:
# 普通文本按单个字符结合东亚宽度分类统计
for ch in token:
status = unicodedata.east_asian_width(ch)
if status in ('W', 'F'):
total_width += 2
elif status in ('A',):
# 某些模糊字符在西文终端占1,东亚终端占2,常规按全角2处理
total_width += 2
else:
total_width += 1
return total_width
# 验证测试
print(get_display_width("极客 👨💻")) # 输出: 7 (2个汉字*2 + 1个空格 + 1个复合Emoji*2)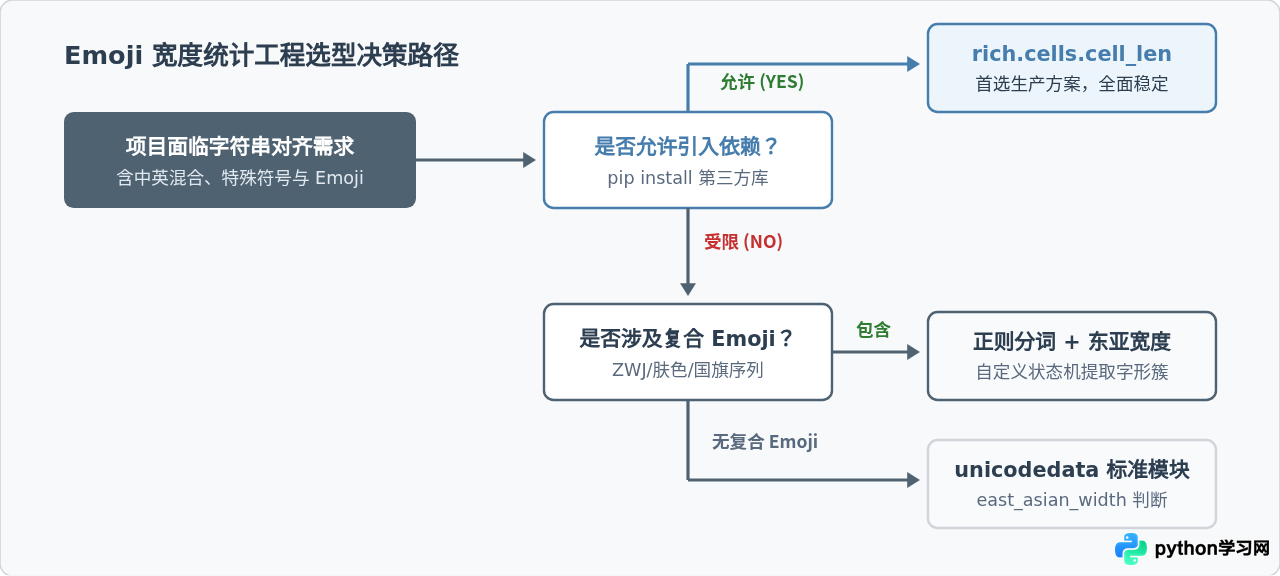
图 4:项目工程场景下的技术选型决策树
实际落地中的关键注意事项
\ufe0f 的旧版单色图标)可能存在 1 个格子或 2 个格子的渲染偏好差异。
在编写健壮的控制台应用时,建议遵循以下两条原则:
- 避免混用不同标准:在同一个排版表格中,统一使用
rich.cells.cell_len进行宽度计算和填充,不要有的列用len()、有的列用cell_len()。 - 推荐使用专业控制台排版框架:如果输出内容多为复杂数据表格,推荐直接使用
rich.table.Table。该框架在底层已自动计算所有单元格真实占用宽度并进行字符裁剪和自适应对齐,无需手动拼凑空格。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









