

DeepSeek本地部署硬件要求:7B/67B/R1版本显存占用对照

很多人想在家里那台主力机上跑个大模型,第一反应往往是去查参数表,看显卡是不是“够格”。但现实往往比参数更骨感:明明显存标称24GB,跑个7B模型却频频爆显存;或者内存条插满了32GB,加载67B模型时依然卡死在进度条上。本地部署大模型不是简单的“下载即运行”,而是一场关于显存带宽、量化精度和系统交换空间的精密博弈。
对于大多数开发者和个人用户而言,选择模型的核心不在于追求最大参数量,而在于找到硬件负载与响应速度之间的平衡点。DeepSeek系列提供了从7B到67B甚至更复杂的R1推理版本,不同的量化策略(如Q4_K_M、Q8_0)会直接决定你的电脑是“秒回”还是“假死”。本文将剥离营销术语,直接从显存占用的物理极限出发,帮你理清不同版本DeepSeek的真实硬件门槛。
7B版本:入门级的甜蜜点与显存陷阱
7B(70亿参数)模型通常被视为本地部署的“入门券”。在理想状态下,一个未经量化的FP16精度7B模型需要约14GB显存来存储权重,再加上推理过程中的KV Cache(键值缓存),24GB显存的显卡似乎绰绰有余。然而,实际体验中我们很少使用全精度部署。
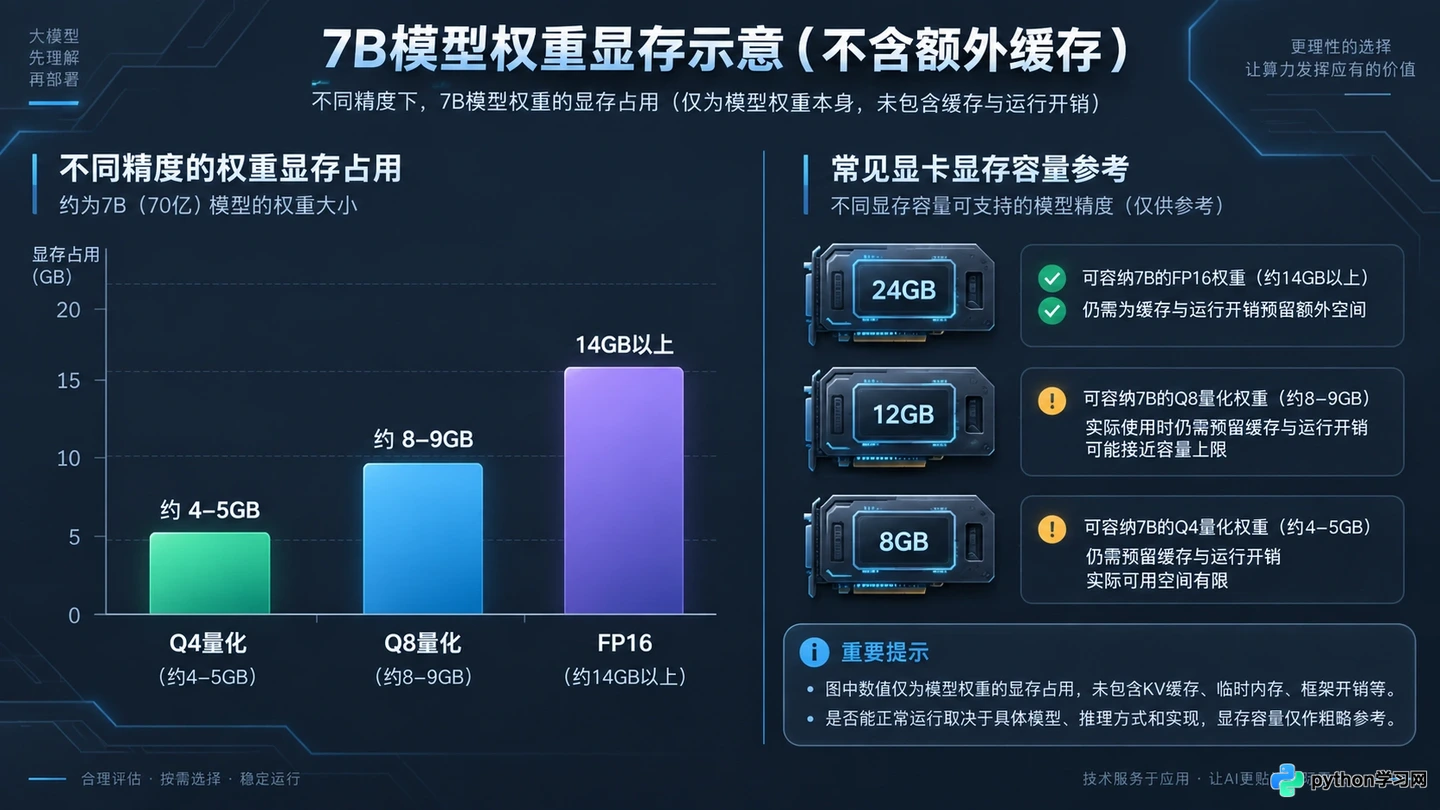
7B模型在Q4、Q8及FP16精度下的显存分布对比
目前主流的部署方式是基于GGUF或AWQ格式的量化模型。以Q4_K_M(4-bit量化)为例,7B模型的权重文件大约只有4-5GB。这意味着,哪怕是一张8GB显存的RTX 3070或4060 Ti,理论上也能将其完全载入GPU。在这种配置下,推理速度极快,延迟通常在毫秒级,适合用于代码补全、日常对话或轻量级文本生成。
但如果试图运行Q8_0(8-bit量化)或FP16版本,显存占用会激增至10GB以上。此时,如果后台还开着浏览器、IDE或游戏,剩余的显存可能不足以容纳KV Cache,导致系统被迫将部分数据交换到系统内存中。一旦涉及PCIe总线的数据交换,推理速度会从“即时响应”跌落到“每秒几个词”。因此,对于7B版本,12GB显存是一个更从容的起步线,它允许你在保持高速推理的同时,拥有更大的上下文窗口(Context Window)。
67B版本:跨入专业级的显存墙
当参数量跃升至67B,硬件需求不再是线性增长,而是呈现指数级跨越。67B模型即使经过极致的Q4量化,其权重文件大小也在35-40GB左右。这直接判了单张消费级显卡(如RTX 4090的24GB)的“死刑”——除非你愿意接受极其缓慢的CPU离线推理。
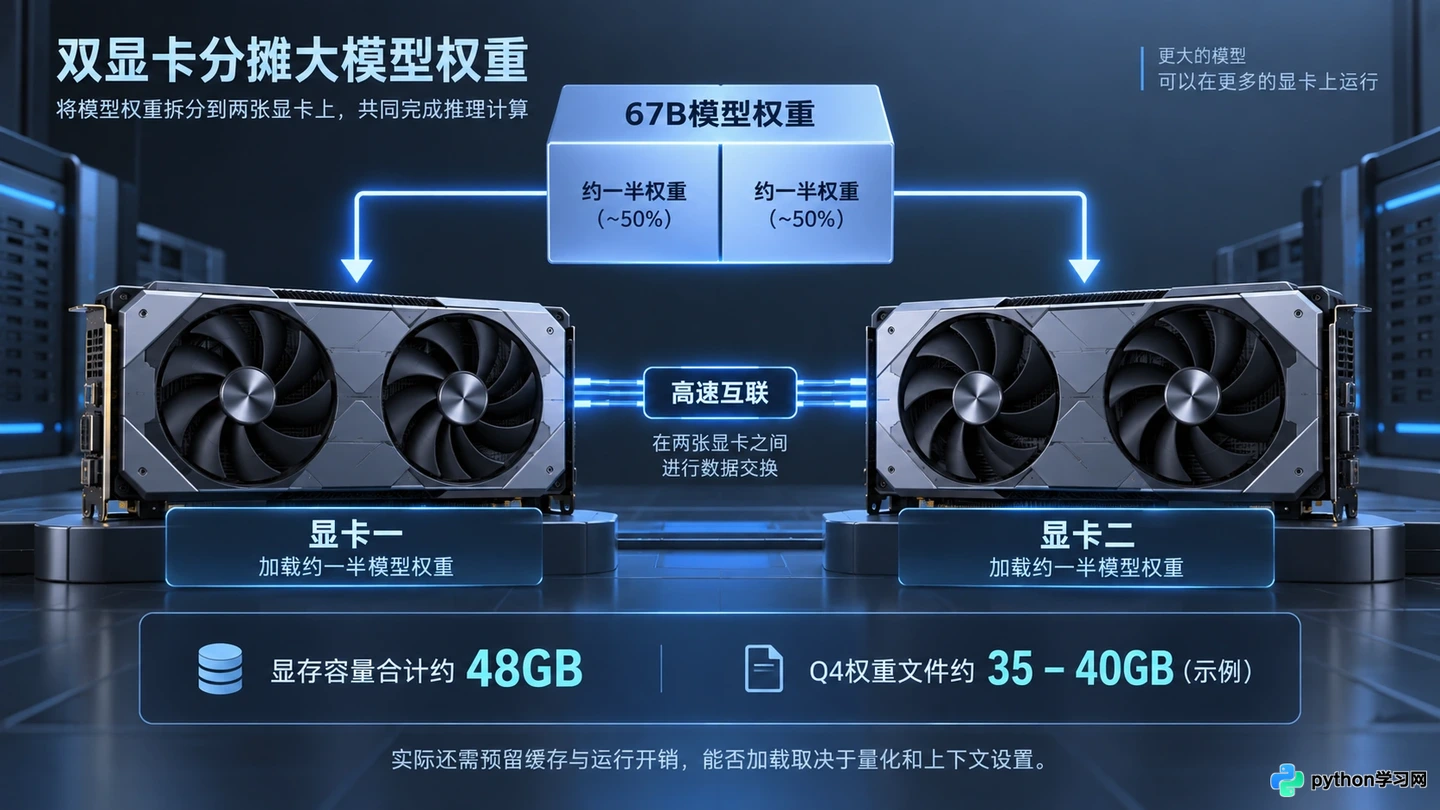
双RTX 4090互联分配67B模型权重的架构示意
要流畅运行67B级别的DeepSeek模型,通常有两种路径:多卡互联或大内存CPU卸载。如果是双RTX 3090/4090(共48GB显存),可以将模型权重完全分布在两张卡上,实现接近实时的推理体验。这种方案成本高昂,但对专业开发者而言,能获得接近商用API的智能水平。
对于单卡用户,唯一的出路是利用系统内存。通过llama.cpp等工具,可以将部分层卸载到GPU,其余留在CPU内存中。这时,系统内存的大小和速度成为了新的瓶颈。运行Q4量化的67B模型,建议至少配备64GB DDR5内存。虽然推理速度会显著下降(可能降至每秒2-5个token),但对于非实时性的任务,如长文档摘要、复杂逻辑分析,这种“慢但聪明”的模式依然具有极高价值。需要注意的是,如果使用DDR4内存或容量不足32GB,加载过程可能会因交换文件频繁读写而导致系统长时间无响应。
R1推理版本:思考链带来的额外开销
DeepSeek-R1作为强化推理能力的版本,其核心差异在于“思考过程”。在输出最终答案前,模型会生成一段长长的思维链(Chain of Thought)。这不仅意味着输出的token数量增加,更关键的是,推理过程中产生的中间状态会占用更多的KV Cache显存。
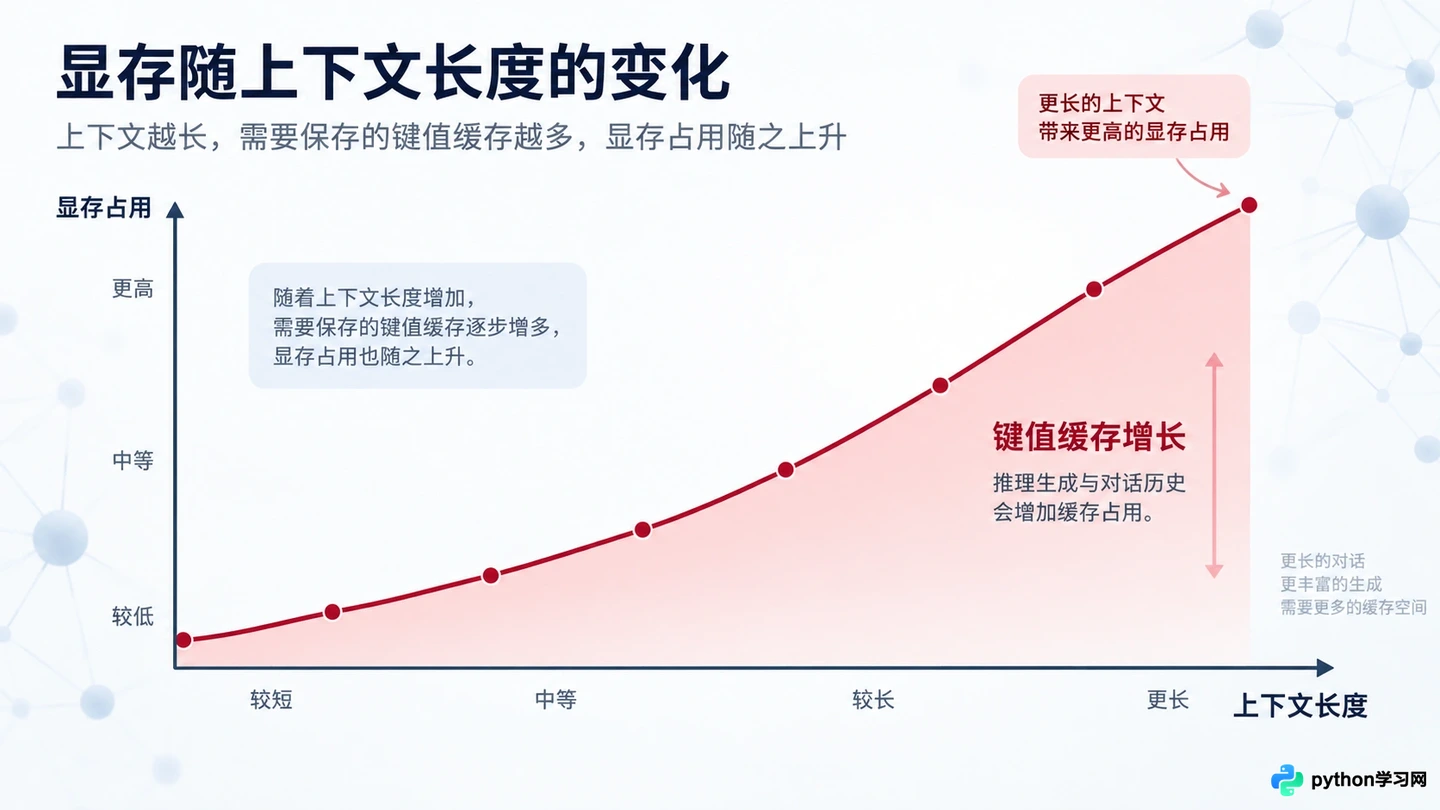
R1模型思考链生成导致的显存动态变化
在相同参数量下,R1版本的峰值显存占用通常高于普通对话版本。例如,7B-R1在处理复杂数学题或逻辑谜题时,由于上下文长度迅速拉长,KV Cache可能迅速吃掉剩余的几GB显存。如果你的显卡刚好卡在7B Q4的临界值(如8GB显存),运行R1版本时更容易出现OOM(Out Of Memory)错误。
对于67B-R1,这种效应被进一步放大。在多轮对话中,历史记录的累积会让显存压力呈螺旋式上升。因此,部署R1版本时,建议在常规硬件要求基础上预留20%-30%的显存余量,或者主动限制最大上下文长度(max_context_length)。这不是模型变“重”了,而是它的“思考”更占地方。
量化选择:在精度与速度间做取舍
面对硬件限制,量化(Quantization)是本地部署的救命稻草。常见的Q4_K_M、Q5_K_M、Q8_0代表了不同的压缩率。Q4将每个权重压缩为4位,体积最小,速度最快,但可能会在极少数复杂指令上出现逻辑偏差;Q8几乎保留了全精度的表现,但体积翻倍。
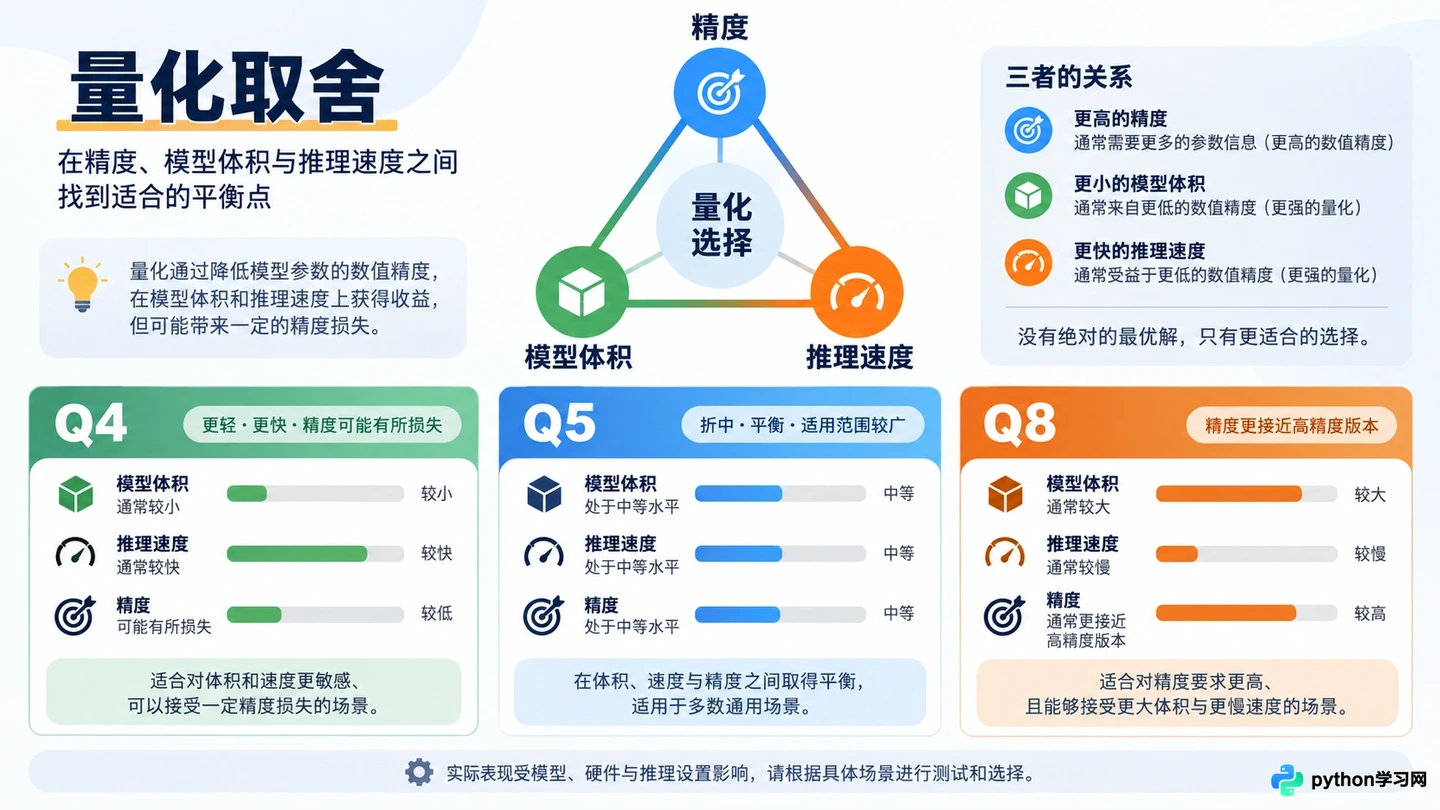
量化精度、模型体积与推理速度的三角平衡
在实际测试中,Q4_K_M通常是性价比最高的选择。它在绝大多数日常任务中与FP16的表现难以察觉差异,却能让67B模型勉强挤进48GB显存的双卡系统,或让7B模型在8GB显卡上飞起。除非你有明确的科研需求或发现Q4版本在特定领域频繁出错,否则不建议盲目追求Q8或FP16。对于内存充足但显卡较弱的用户,可以尝试Q2_K或Q3_K,虽然精度损失较大,但能大幅降低对系统内存的需求,让老旧电脑也有机会“跑起来”。
最后,不要忽视硬盘速度。加载几十GB的模型文件时,NVMe SSD与机械硬盘的体验天差地别。快速加载不仅节省时间,还能在模型切换时减少等待焦虑。本地部署是一场硬件的妥协艺术,认清自己的显存底线,选择合适的量化版本,才能让DeepSeek真正为你所用,而不是成为机箱里一个吃灰的巨大文件。
本地部署前的硬件自检与配置建议
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









