

Python 3中for循环与while循环的区别及选择建议

在Python 3中,for循环与while循环是控制程序重复执行流程的两种核心结构。简而言之,两者的本质分工十分明确:for循环是“遍历驱动型”,主要用于按顺序访问可迭代对象(如列表、字典、生成器或指定区间)中的每一个元素,循环次数通常由数据集合的长度或形态决定;而while循环是“条件驱动型”,只要指定的布尔表达式为真,循环体就会持续执行,适合处理状态变化、轮询等待以及事先无法确定循环次数的场景。理解这两种循环在执行逻辑、状态维护和语义表达上的差异,是写出清晰、安全且高效Python代码的基础。
一、两种循环的核心机制对比
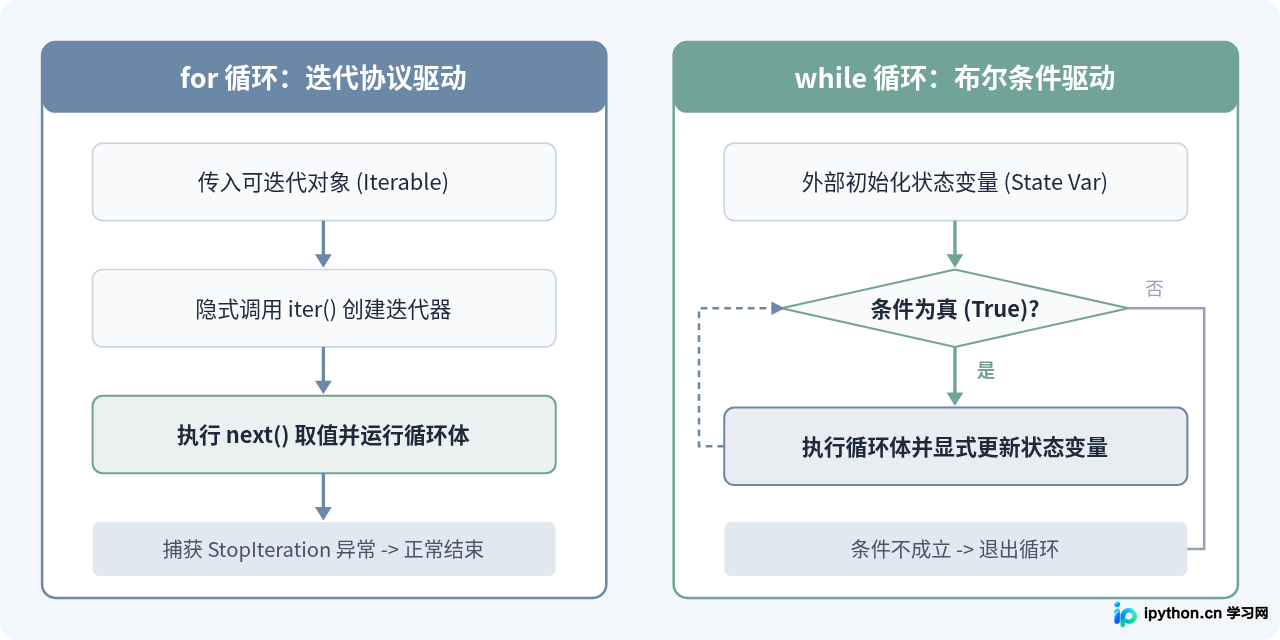
很多刚接触编程的读者常把两者看作简单的语法替代表达,但Python 3的for循环设计有其特殊的语言哲学。在C或Java等传统语言中,for (int i=0; i<n; i++)本质上依旧是基于计数器变量和条件的结构;而Python中的for循环实际上是对迭代协议(Iteration Protocol)的高层封装,等价于自动调用iter()获取迭代器并不断执行next(),直到捕获StopIteration异常安全退出。
相对而言,while循环保留了经典的条件判断模式。每次进入循环体之前,解释器都会评估紧随其后的条件表达式。如果条件为True,执行循环体;如果为False,跳过循环体向下执行。正因如此,开发者需要在循环体内显式更新控制条件(例如递增计数器、修改状态标志或消费队列),否则极易导致死循环。
我们通过直观的代码来看这两种结构在最常见的计数场景下的不同表现:
# 示例1:使用 for 循环遍历区间
for i in range(3):
    print(f"for 计数: {i}")

# 示例2:使用 while 循环实现相同计数
count = 0
while count < 3:
    print(f"while 计数: {count}")
    count += 1
运行结果完全一致,但for循环省去了初始化变量count并在循环体内手动累加count += 1的步骤,这不仅减少了样板代码,也杜绝了因为忘记递增而产生的逻辑失误。
二、for 循环的使用模式与执行步骤
在日常开发中,for循环是处理容器与序列的首选。它的结构紧凑,且天生与Python的内置函数及数据结构紧密配合。
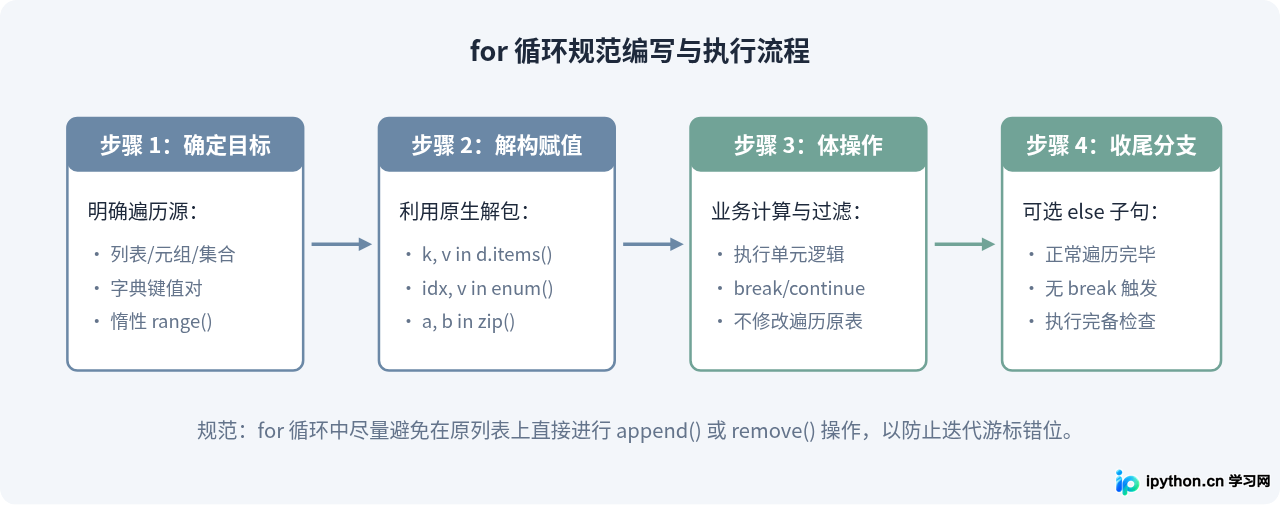
1. 遍历序列与生成序列
除了遍历预先分配好的列表、元组或字符串,最常用的工具是range()函数。需要注意的是,Python 3中的range()是一个不可变的惰性序列对象,而不是像Python 2那样直接在内存中分配一个完整的列表,因此即使range(1000000)也几乎不占用额外内存。
# 指定起始值、终止值与步长
for num in range(1, 10, 2):
    print(num)  # 依次输出 1, 3, 5, 7, 9
2. 配合 enumerate() 与 zip()
当开发者既需要访问元素本身,又需要获知其索引位置时,不应该手动去维护一个计数器变量,而应当使用enumerate():
fruits = ["苹果", "香蕉", "橙子"]
for index, item in enumerate(fruits, start=1):
    print(f"序号 {index}: {item}")
同样地,当需要并行遍历多个序列时,使用zip()能够让代码保持清晰整洁:
names = ["Alice", "Bob"]
scores = [95, 88]
for name, score in zip(names, scores):
    print(f"{name} 的得分是 {score}")
三、while 循环的使用场景与安全守则
既然for循环如此方便,为什么还需要while循环?原因在于,现实业务中并非所有重复操作都能够与某个固定的可迭代容器挂钩。例如网络轮询、用户连续输入校验、分批流式读取和收敛算法等场景,必须依据运行时随时产生的动态结果来决定是否继续。
1. 典型的动态条件控制
以下示例演示了典型的用户输入校验,在输入满足特定要求前,程序会持续等待:
# 校验用户输入合法性
valid_input = False
while not valid_input:
    user_str = input("请输入纯数字: ")  # 示例调用
    if user_str.isdigit():
        print(f"输入有效: {user_str}")
        valid_input = True
    else:
        print("格式错误,请重新输入。")
2. 死循环与防御性退出
在使用while循环时,最常犯的错误是条件无法收敛导致的死循环。编写while循环时,建议建立“三重防御”:
- 明确更新步进:确保每一次迭代都会使状态朝终止条件更进一步。
- 最大迭代上限:对于外部系统交互(如HTTP重试),务必引入
max_retries计数器,防止外部服务宕机导致进程假死。 - 明确超时/跳出机制:结合
break与超时时间控制。
import time

max_attempts = 5
attempts = 0
success = False

while not success and attempts < max_attempts:
    attempts += 1
    # 模拟外部检查任务
    status_ready = (attempts == 3)  # 示例模拟第3次成功
    if status_ready:
        success = True
        print("任务完成!")
        break
    print(f"第 {attempts} 次尝试未就绪,重试中...")
    time.sleep(0.5)

if not success:
    print("达到最大重试次数,操作终止。")
四、关键差异深度剖析
为了让选择更有依据,我们可以从控制机制、执行效率、可读性以及变量作用域四个维度深入考察两者的区别:
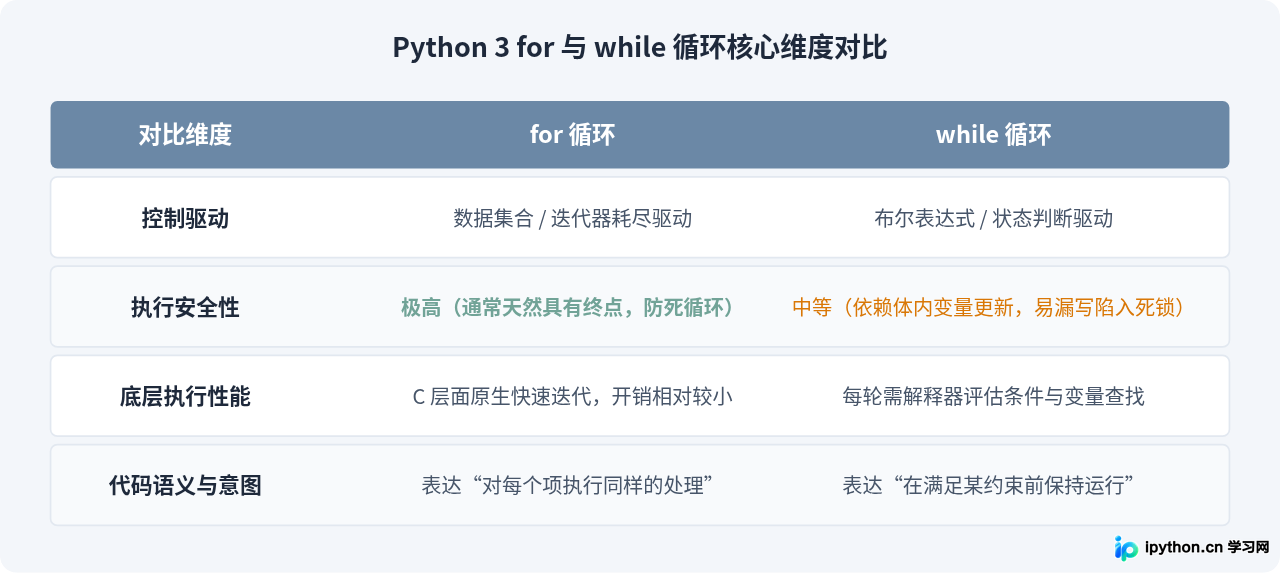
值得特别说明的是性能与解释器开销:当需要单纯遍历一定次数时(例如循环执行100万次空操作),使用for i in range(1000000)通常明显快于使用while count < 1000000。这是因为for配合range在CPython解释器内部经过了高度优化,迭代取值直接发生在C扩展底层;而while循环在每一轮都必须执行Python字节码层面的条件判断、属性加载以及加法运算并写回变量,额外耗费了指令跳转周期。
另一个常被忽视的细节是循环变量的作用域泄漏:在Python中,循环体并不是独立的作用域(不同于部分其它语言中的块级作用域)。无论是for item in list中的item,还是while之前定义的count,在循环结束后依然留存在当前函数或全局作用域中,甚至保留着最后一次迭代的值。使用时应避免与外部同名变量产生意外覆盖。
五、场景决策指南与选择建议
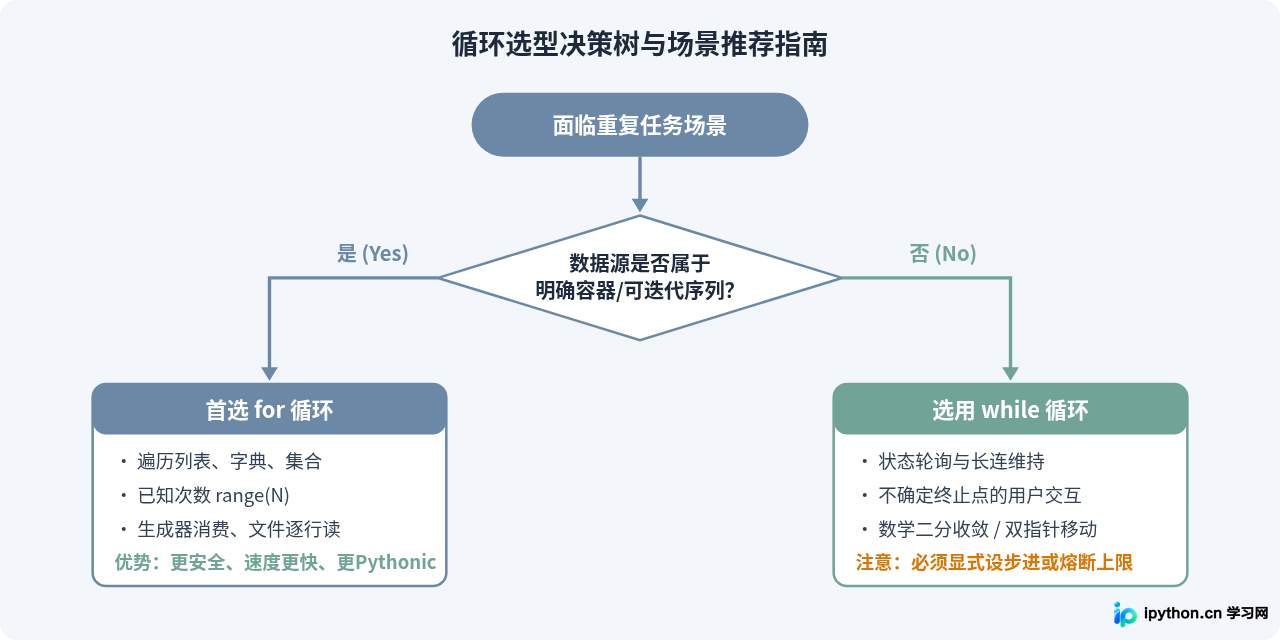
在编写实际业务代码时,应该如何抉择?可以遵循以下清晰的决策逻辑:
1. 默认首选
for:只要数据能够表示为可迭代对象,或者循环次数固定,一律优先使用for循环。它能将代码行数减少30%以上,同时杜绝死循环隐患。
2. 状态依赖才用
while:当循环结束依赖于外部世界的状态改变(如套接字是否收到数据、用户是否敲击回车、浮点数收敛差值是否小于阈值)时,才选用while循环。
3. 严控
while True 的出口:如果使用无限循环配合break退出,确保break之前没有可能抛出未捕获异常的阻塞代码,并在适当时机添加超时熔断逻辑。
总结
for循环和while循环在Python 3中并不存在谁替代谁的问题,而是各自面向不同的抽象层次。for循环依托于强大的迭代器协议,将我们从繁琐的索引管理和边界检查中解放出来,体现了Python语言推崇的优雅与可读性;而while循环提供了最纯粹的条件流控制,为状态流转和动态算法提供了稳健的表达能力。在实际开发中,先看数据结构能否转化为可迭代对象,再评估终止条件是否属于动态外部事件,就能准确选出最合适的循环结构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









