

Python itertools.cycle 实现无限循环迭代器详解

本文详细介绍Python标准库itertools中cycle函数的用法。通过对比普通列表遍历,演示如何利用cycle构造无限循环迭代器,并解析其__iter__与__next__实现原理。结合爬虫场景中Cookie池顺序调用的实例,展示如何在遵守法律前提下高效管理请求频率,实现资源的循环复用。
Python itertools.cycle 实现无限循环迭代器详解
引入方式
from itertools import cycle引入方式与基本用法
使用方法
源码机制与迭代器协议
首先查看其源码实现
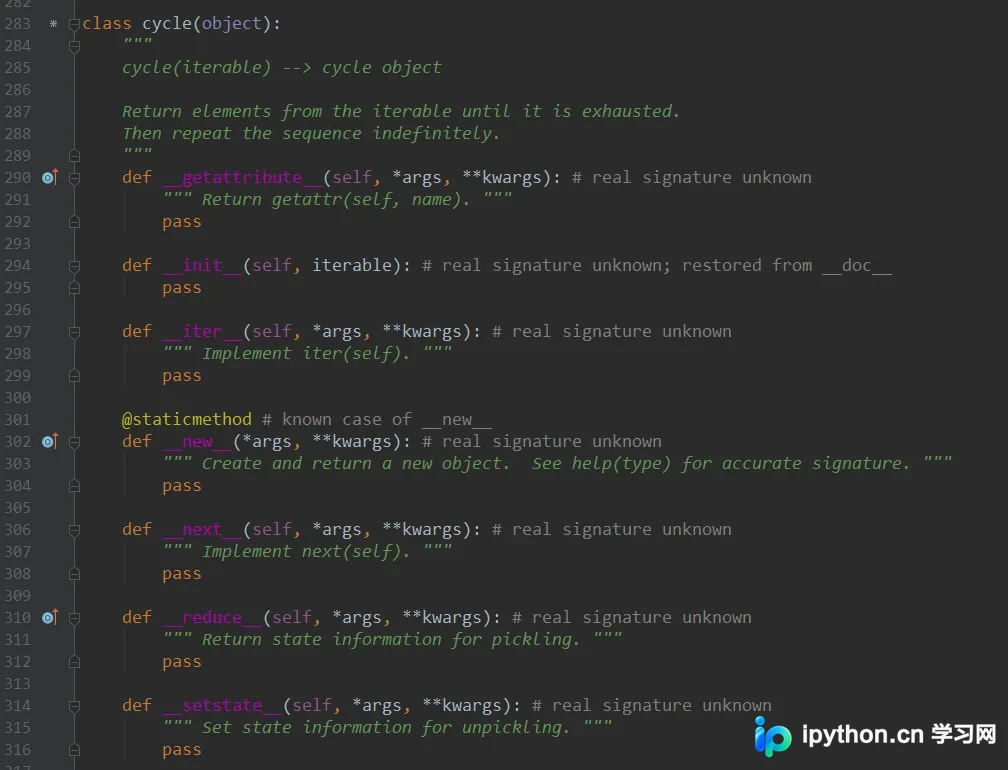
cycle函数接收一个可迭代对象作为参数,将其转换为一个可以无限次迭代的迭代器对象。
从源码可以看出,该实现包含了__iter__和__next__两个魔术方法,这意味着它既符合可迭代对象协议,也是一个标准的迭代器。因此,开发者既可以使用for循环进行遍历,也可以直接调用next()函数来获取下一个元素。
与普通列表遍历的对比
为了理解其特性,我们先回顾一下普通方式遍历列表的行为。
li = ['python', 'java', 'c', 'ruby', 'php', 'javascript']
for i in li:
  print(i)
运行上述代码后:
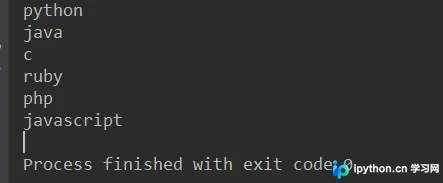
结果显示,当列表中的最后一个元素被遍历结束后,迭代过程即告终止,不会继续执行。
构造无限循环迭代器
接下来,我们演示如何使用cycle函数创建一个支持无限迭代的迭代器。
from itertools import cycle

li = ['python', 'java', 'c', 'ruby', 'php', 'javascript']
cycle_iter = cycle(li)
for i in cycle_iter:
  print(i)
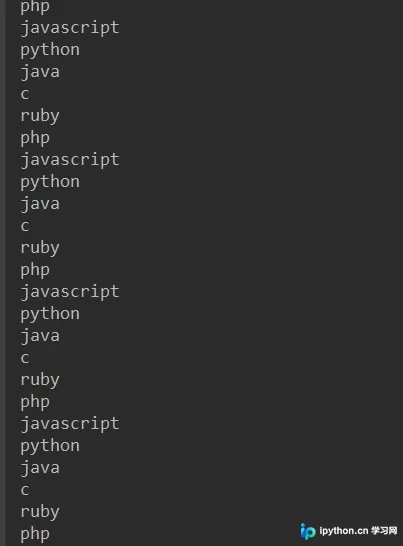
运行该段代码后:
......
观察输出结果可以发现,当遍历至列表末尾元素后,迭代器会自动重置并回到第一个元素继续遍历。这种机制形成了无限循环,其行为逻辑与while死循环相似。
使用next()函数的迭代行为
随后,我们尝试使用next()函数手动进行迭代,观察其具体表现。
from itertools import cycle

li = ['python', 'java', 'c', 'ruby', 'php', 'javascript']
cycle_iter = cycle(li)
print(next(cycle_iter))
print(next(cycle_iter))
print(next(cycle_iter))
print(next(cycle_iter))
print(next(cycle_iter))
print(next(cycle_iter))
print(next(cycle_iter))
print(next(cycle_iter))
执行结果如下:
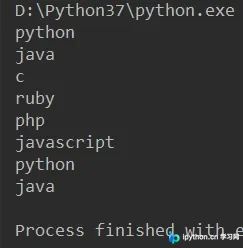
结果显示,当迭代完最后一个元素后,next()调用并未抛出StopIteration异常,而是继续返回第一个元素。这与普通迭代器的行为不同,普通迭代器在耗尽元素后继续调用next()会引发迭代停止异常。
实际应用场景:爬虫Cookie池管理
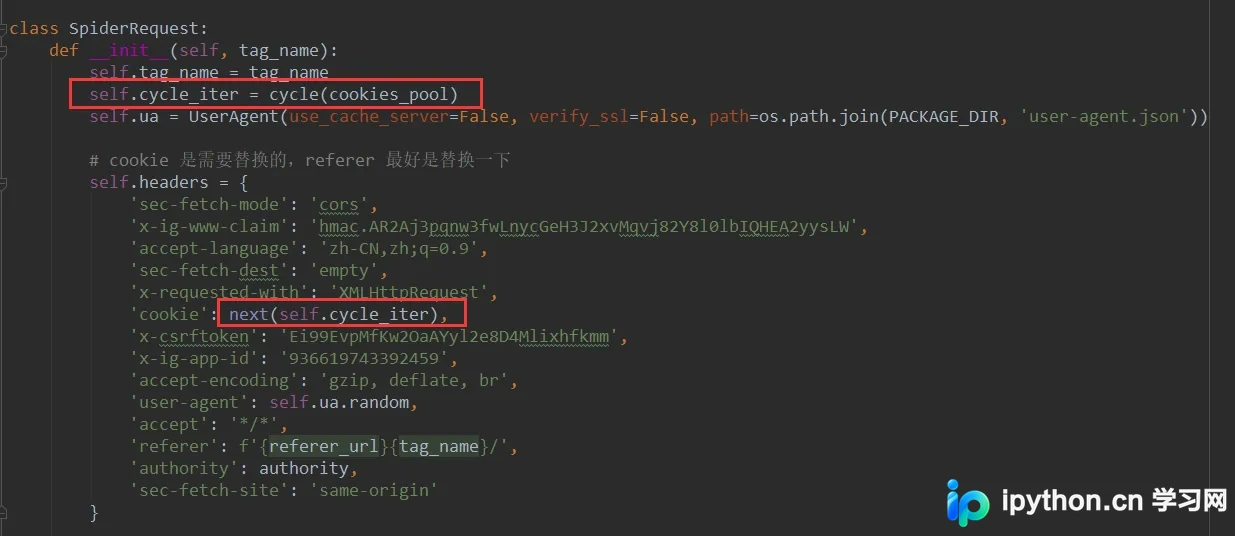
应用场景 在实际开发中,若有一批数据需要按固定顺序循环使用,且不希望随机选取,cycle函数便派上了用场。以网络爬虫场景为例:目标网站对请求频率有限制,但为了高效获取数据,我们可以构建一个Cookie池。在发起请求的循环中,利用next()方法按顺序从池中获取Cookie进行请求发送。当遍历完最后一个Cookie后,迭代器会回到第一个Cookie继续循环。这样,当账号数量较多时,每个账号的使用频率得以平均分散,从而达到规避限流的效果。部分实现代码截图如下:
温馨提示:网络爬虫操作必须严格遵守相关法律法规,切勿抱有侥幸心理触碰法律红线。请务必遵守被爬取网站的安全策略,避免暴力爬取,严禁抓取涉及国家安全及用户隐私的信息。
以上即为Python中使用cycle构造无限循环迭代器的完整内容,更多关于Python迭代器构建的资料,敬请查阅本站其他相关文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









