

llama.cpp结构化输出如何用Python区分JSON解析与字段校验
HTTP成功、JSON语法正确和业务字段有效是三个条件。通过本地Chat Completions完整请求示例,说明schema约束与Python验证,并区分预览构建修复范围。
llama.cpp结构化输出在Python中怎样验证?先区分HTTP请求成功、文本能被json.loads解析,以及结果满足业务字段这三个条件,再处理schema或工具参数转换问题。b12253、b12254、b12242和b12282修复的是不同生成环节,不能仅看到“JSON相关修复”就取消客户端验证;这些预览变化也不能统一归入v0.9.0正式版。
先看错误发生在哪一层
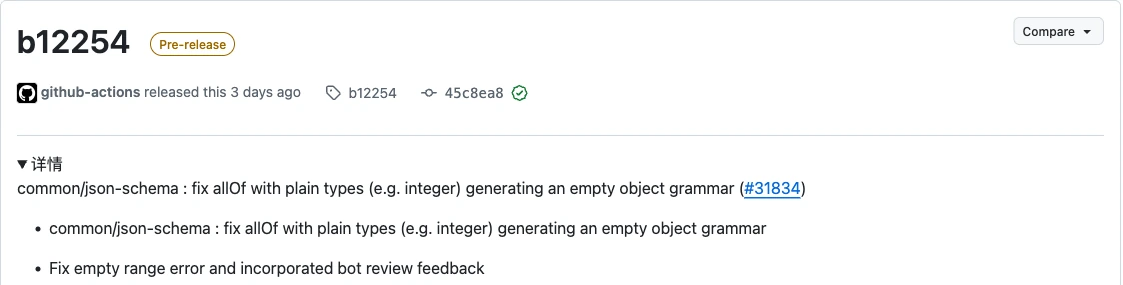
b12253处理工具参数字符串里的原始控制字符,例如代码参数含换行时形成无效JSON;b12254解决allOf与普通类型组合生成空对象语法的问题。前者偏向结果文本转义,后者属于模式到生成语法的转换,错误位置并不相同。
b12242调整response_format与工具同时使用的语法处理,b12282补上Muse Spark聊天路径忽略json_schema的处理。客户端收到200只能说明HTTP层完成,不能据此认定模型文本已经符合所有字段约定。
给已运行的本地服务提交完整schema请求
下面示例需要已运行且已加载合适聊天模型的llama-server,地址为本机8080端口,并在Python环境中安装requests。它不负责安装模型或启动服务;若服务地址不同,修改base。示例先读取服务报告的模型ID,再请求一个只有answer字符串字段的对象:
import json
import requests

base = "http://127.0.0.1:8080"
models = requests.get(base + "/v1/models", timeout=30)
models.raise_for_status()
model_id = models.json()["data"][0]["id"]

response = requests.post(
    base + "/v1/chat/completions",
    json={
        "model": model_id,
        "max_tokens": 128,
        "messages": [{"role": "user", "content": "用一句话解释Python列表"}],
        "response_format": {
            "type": "json_schema",
            "json_schema": {
                "name": "short_answer",
                "strict": True,
                "schema": {
                    "type": "object",
                    "properties": {"answer": {"type": "string"}},
                    "required": ["answer"],
                    "additionalProperties": False,
                },
            },
        },
    },
    timeout=120,
)
response.raise_for_status()
text = response.json()["choices"][0]["message"]["content"]
value = json.loads(text)
if not isinstance(value, dict) or set(value) != {"answer"}:
    raise ValueError("返回字段不符合示例约定")
if not isinstance(value["answer"], str):
    raise ValueError("answer必须是字符串")
print(value["answer"])
模型ID来自实际服务,answer是示例自定义的业务字段,不是llama.cpp强制返回字段。正常完成时打印回答字符串;HTTP异常、空模型列表、JSON语法错误或字段不符会在不同位置报错,便于分清故障层次。这里的字段检查只覆盖这个简单契约,不是完整JSON Schema验证器。
兼容端点不能代替参数映射核对
b12240把Responses API的text.format.json_schema转换到Completions格式,v0.9.0的/v1/responses会合并extra_params相关参数;这与上例Chat Completions的response_format不是同一个请求层次。不同客户端接口即使都称OpenAI兼容,也不能把所有字段原样互换。
音频路径同样独立:b12238加入/v1/audio/speech,b12236提供重采样辅助,b12237支持Gemma 4音频输入流,b12239调整实时API内部输入表示,b12233支持外部PLE加载。正式版mtmd声音接口、GET /props预定义声音及TTS声音名称,属于另一组输入输出契约。
模型支持、缓存与数据搬运各有什么条件
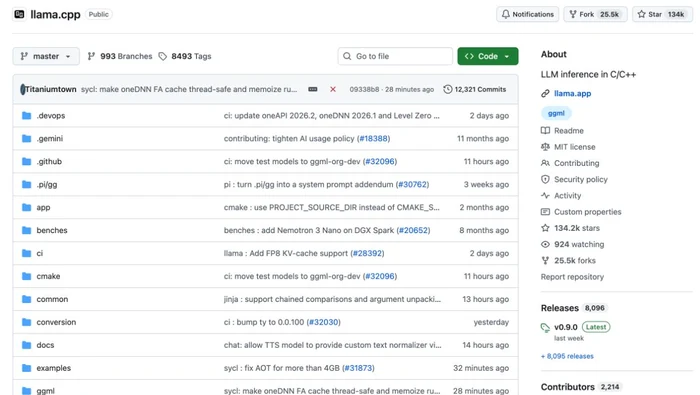
v0.9.0正式版加入Clover、Limite、Metis-1.6、Mistral Large 4架构,音频扩展Chatterbox TTS、Nemotron 3.5 Transcribe、Pocket TTS预定义声音,Gemma 4 E2B/E4B有预填充优化。ggml更新至v0.29.0,包含NCCL多节点张量并行;通用批量张量复制API替代二维复制,Metal、CUDA已有对应实现。外部源码集成不能忽略API变化。
OCP FP8 E4M3张量与量化是v0.9.0能力,b12274的FP8 KV缓存另有缩放、scale命名映射与Gemma 4 Assistant适配,仍标预览。权重精度与运行时缓存精度不是一回事;flash_attn_ext_rows改善统一KV多序列效率,b12141引用计数检查点、b12271调度器复用和b12273投机解码缓冲区别名修复,也分别处理不同环节。
视觉与多模态方面,b12259支持Kimi K3.1并修正K2.5/K3.1预处理与投影,b12261共享子上下文缓冲区并补音频加载分配,b12277改用mtmd_format并修格式化;b12211移除clip.h、整合进mtmd。这些变化不能只由服务端“能够启动”推定模型全部路径都正确。
后端与设备变化怎样影响结果判断
CUDA b12144涉及MoE布局及F16回归,b12167修Maxwell构建,b12262减少图复用兼容检查,b12263地址池预留不足时减半预留重试;最后一项不等于模型显存需求减半。b12169的CUDA 13发布构建使用13.5,预编译包仍有运行环境条件。
Adreno X2的b12125启用小批量f32/q5_K多列GEMV,Qualcomm b12246限制大注意力头Vulkan标量Flash Attention行数;Hexagon b12164改重打包、分块和批量设置,b12241修64位FastRPC关闭句柄截断。OpenCL b12213补f32 MUL_MAT_ID、b12219补头文件,均不能外推为所有端侧设备统一提速。
AMD专有驱动26.10.1及以上对应b12129大型cooperative-matrix配置。Metal b12220涉及无穷值选择,b12221防Flash Attention越界,b12270补矩阵乘精度测试和限制;SYCL b12283修非连续/带步长张量的CLAMP处理。后端的输出正确性与模型JSON契约,仍是两个要分别判断的条件。
zDNN b12212修库检测、b12230修张量路径,b12223补Granite NVFP4缩放,b12224避免上传未读输入。b12140的YaRN truncate=false涉及gpt-oss及部分PLaMo-3,b12214调RoPE测试容差,b12245仅在关闭mmap时改变iGPU lazy-mode回退。b12128主要是TOPK_MOE测试偶发失败修复,不能据此声称推理能力提升或紧急安全风险。构建选择应与实际模型、接口和硬件问题对应。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









