

Python二分查找算法原理与实战解析

发布时间:2026-10-16| 4人浏览过
本文详细解析Python中的二分查找(折半查找)算法。文章从算法原理出发,通过图解展示查找过程,并提供完整的Python代码实现。通过对比内置in关键字与二分查找的性能,分析其在大数据量有序序列中的优势及排序成本,帮助读者深入理解该算法的应用场景与限制。
前言
掌握Python基础语法后,许多开发者希望进一步深入语言的核心机制。在面向对象模块更新之前,本专栏将穿插“Python百炼成钢”系列,旨在通过算法题训练夯实基础。该系列文章获得了读者的广泛认可,同时也促进了作者的技术成长。接下来,我们将正式进入今天的核心主题:二分查找法。
问题背景
在软件开发中,数据的增删改查是核心操作,其中“查”尤为关键,因为软件的主要价值在于向用户展示信息,普通用户通常只有查看权限。在链表或数组中查找数据,传统方法是从头遍历,逐个比对。当数据量庞大时,这种线性搜索效率极低。二分查找(又称折半查找)正是为了解决这一问题而生,它主要适用于已排序的数据序列。其核心思想是每次取中间值进行比较,从而将查找范围缩小一半,逐步逼近目标值。
原理剖析
实现步骤
- 1. 确定当前查找区间的中间位置K,并设定区间的左右边界l和r。
- 2. 将待查找的值T与中间元素array[k]进行比较。如果两者相等,则查找成功,返回该位置索引;如果不等,则根据比较结果确定新的查找区域,并继续进行二分查找。
新区间的确定规则如下:
- 每次比较后,若未找到目标值,当前查找区间将缩小一半。根据比较结果(大于或小于中间值),重新调整左右边界及新的中间索引k。
- 该算法的时间复杂度为O(log2n)。
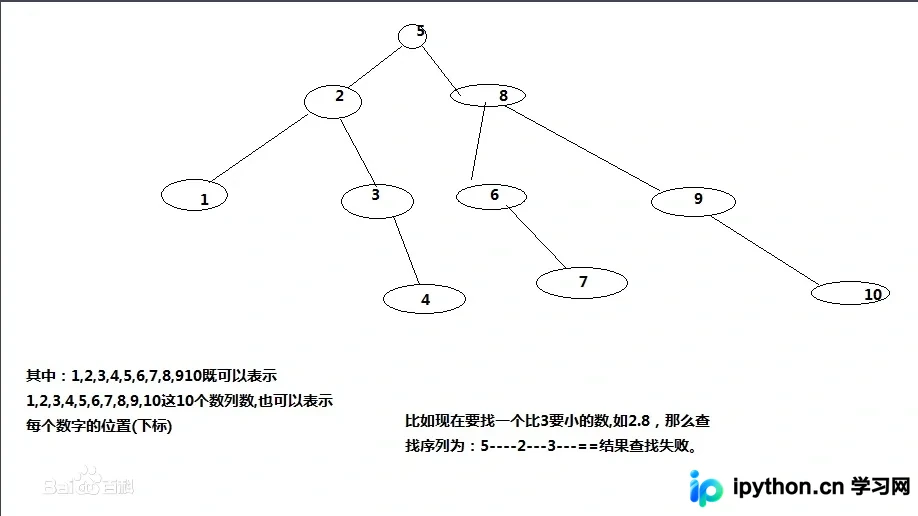
图解演示
图片源于网络
代码实现
在编写代码时,我们对比了Python系统内置的查找关键字in与自定义二分查找法的运行效果,具体打印结果如下:
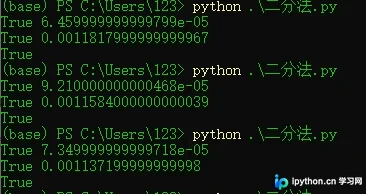
从结果可以看出,Python底层的查找算法执行速度极快,且使用便捷。
需要注意的是,二分查找在本次实验中的劣势在于需要对列表进行预先排序。
然而,对于数据量巨大且已有序的数据集,二分查找的优势将显著体现。
import time,math,random

#计时器(使用的是函数装饰器前面说函数的时候提到过)
def timeT(func):
    def wapper(*s):
        start=time.perf_counter()
        judge=func(*s)
        end=time.perf_counter()
        return judge,start-end
    return wapper
# 使用内置查找方法
@timeT
def serch1(lists,e):
    return e in lists

# 二分法
@ timeT
def serch2(lists,e):
    flag=False
    lists=sorted(lists)
    # print(lists)
    # 左游标
    lo=0
    # 右游标
    ma=len(lists)-1
    # 中间位置
    mid=len(lists)//2
    # 没有在列表内
    if lists[ma]<e:
        return False
    if lists[lo]>e:
        return False
    # 依次缩小左右游标,直到lo>ma
    while lo<=ma:
        if lists[mid]>e:
            ma=mid
            mid=(lo+ma)//2
        elif lists[mid]<e:
            lo=mid
            mid=(lo+ma)//2
        else:
        	#标记位,True代表查到了
            flag=True
            break
    return flag


def main():
	#生成一个含有10000个元素的列表
    numarr=[x for x in range(10000)]
    #打乱列表顺序
    random.shuffle(numarr)
    print(*serch1(numarr,23))
    print(*serch2(numarr,223))
    print(223 in numarr)
    # print(numarr)

if __name__=="__main__":
    main()
至此,关于Python二分查找法的详解介绍完毕。如需了解更多Python相关内容,请搜索本站往期文章或继续浏览后续更新。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









