

Python实现基于身份证后六位的PDF批量加密

本文介绍如何使用Python脚本批量对PDF文件进行加密。通过读取Excel名单,提取身份证号码后六位作为密码,利用PyPDF2库对指定目录下的PDF文件进行加密处理。文章提供了完整源码、依赖说明及运行环境配置指南,适用于需要保护个人隐私信息的办公场景。
一、源码
1、结果展示
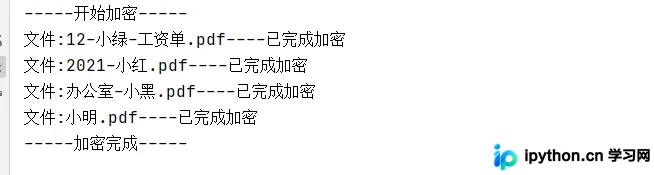
Python自动化办公已成为常见话题,随着公众对个人隐私保护意识的提升,产生了一种特定需求:为每人一个PDF文件加密,且密码设定为该用户身份证号码的后六位。程序运行后的效果如下所示:
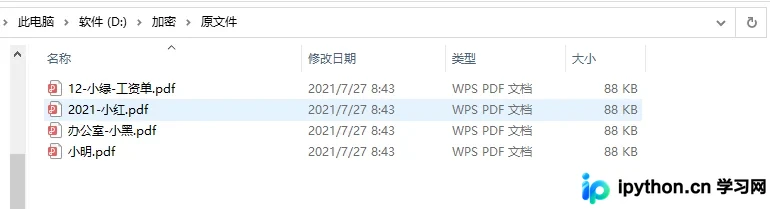
原始文件目录结构如下:
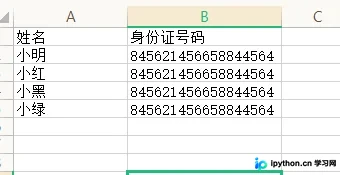
生成的密码列表如下:
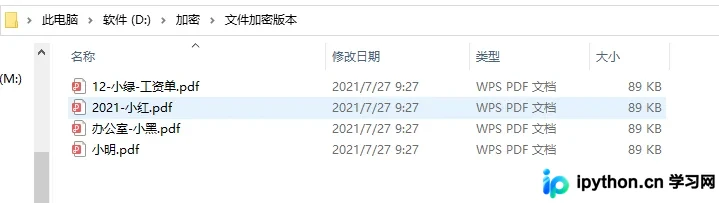
文件加密完成后的结果如下:
我们随机打开其中一个文件进行验证:
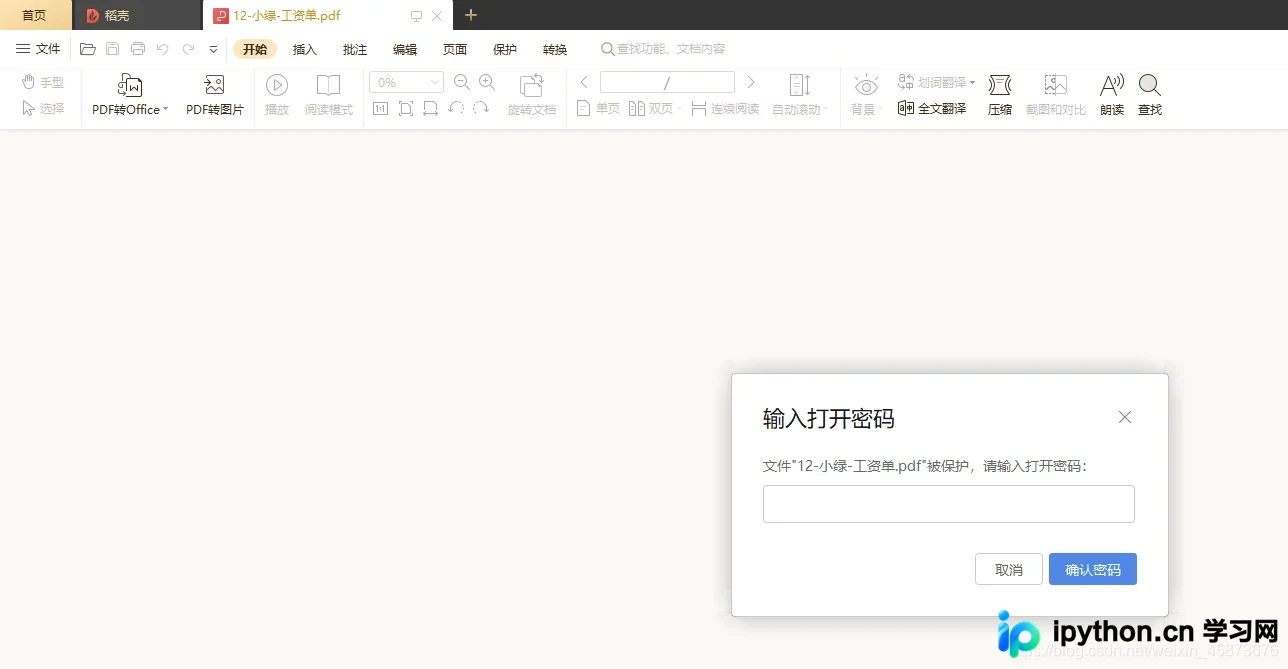
输入对应的身份证后六位作为密码,即可成功打开文件。
2、源码
可运行的完整源代码如下:
import os
from PyPDF2 import PdfFileWriter, PdfFileReader
import pandas as pd

# 全局工作目录
os.chdir("D:\加密")

def main():
    # 1、找文件
    # 获取实习证明原文件的文件名
    rosterfile = os.listdir('.\原文件\\')
    # 获取信息中表的姓名与密码
    name,Password = getPassword()

    # 对每个文件进行加密并保存
    for prove in rosterfile:
        for Name in name:
            if Name in prove:
                i = name.index(Name)
                rosterLast = prove
                rosterNow = '.\文件加密版本\\' + prove
                password = Password[i]
                # 2、加密文件并输出
                encryptionPDF(rosterLast,rosterNow,password)


# 获取了表中姓名信息,并提取身份证后六位作为密码
def getPassword():
    password = []
    name = []
    # 获取Excel列,包括姓名、身份证号
    Name = pd.read_excel('.\名单.xlsx', usecols=[0],names=None)  # 读取项目名称列,不要列名
    Id = pd.read_excel('.\名单.xlsx', usecols=[1],names=None)  # 读取项目名称列,不要列名
    Name1 = Name.values.tolist()
    id = Id.values.tolist()
    # 提取身份证后六位作为密码
    for i in id:
        password.append(str(i[0])[12:18:1])
    # 提取姓名为字符串,原来为list
    for j in Name1:
        name.append(j[0])
    return name,password

# 加密文件并输出
# 变量说明:rosterLast-原PDF文件路径,rosterNow-加密后输出路径,password-加密密码
def encryptionPDF(rosterLast,rosterNow,password):
    pdf_reader = PdfFileReader(r'.\原文件\\%s'%(rosterLast))  # 输入你想要操作的pdf文档的位置/名称
    pdf_writer = PdfFileWriter()

    for page in range(pdf_reader.getNumPages()):
        pdf_writer.addPage(pdf_reader.getPage(page))

    pdf_writer.encrypt(password)  # 写入密码并输出到目的路径
    with open(rosterNow, 'wb') as out:
        pdf_writer.write(out)
    print("文件:%s----已完成加密,密码为:%s"%(rosterLast,password))

# 函数入口
if __name__ == '__main__':
    print("-----开始加密-----")
    main()
    print("-----加密完成-----")
二、源码注释
1、所使用依赖包
代码中主要使用了三个第三方库:
# 文件操作
import os

# 操作PDF文件
from PyPDF2 import PdfFileWriter, PdfFileReader

# 操作数据
import pandas as pd
此处仅简要说明各库的作用,详细用法请参考官方文档或菜鸟教程。
2、函数功能
编码过程中定义了三个核心函数,具体功能如下:
# 主函数,从这里我们可以看到我整体是如何实现此需求的
def main():

# 功能函数,用来获取文件密码的,然后使用姓名与文件名做匹配,达到本人文件为本人身份证后六位的需求。
def getPassword():

#  功能函数,本次编码的核心,前面都可以作为准备阶段,就是为本函数用来加密文件而提供读取、输出路径以及密码的。
def encryptionPDF(rosterLast,rosterNow,password):
3、代码拓展
当前代码仅满足特定场景下的简单需求,不具备普遍适用性。它可能仅在作者的电脑环境中运行正常,直接拷贝源码到其他机器可能会因路径或环境差异报错。若需直接使用,必须严格按照编码时准备的数据结构进行配置。因此,该代码主要适用于学习交流,直接投入生产环境并不现实。当然,可以尝试在此基础上增加功能,例如获取用户输入的路径、定义密码模板等,以提高代码的通用性和可用性,使其支持直接拷贝运行。
三、可运行环境
如果不想修改源码直接运行,请按照以下步骤配置环境。首先在D盘根目录下创建一个名为“加密”的文件夹,路径必须严格为D:\加密。接着在该文件夹内创建如下子文件夹,结构需保持一致:
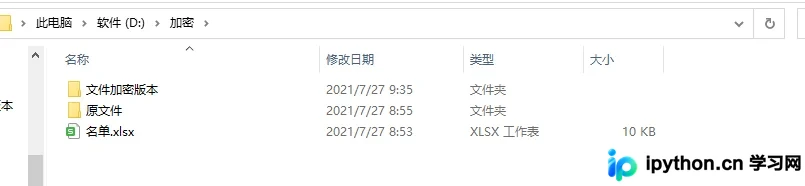
配置完成后,原始PDF文件放入“原文件”文件夹,加密后的文件将生成在“文件加密版本”文件夹中。最关键的是填写“名单.xlsx”表格,该表格用于设置加密密码,格式要求如下:身份证号码必须为纯数字格式。
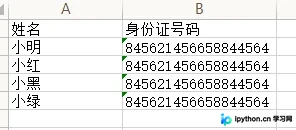
表格仅包含两列:一列为姓名,另一列为身份证号码。请注意,身份证号码列的数据类型必须为数字。
关于Python实现批量文件加密功能的介绍到此结束,更多相关Python批量文件加密内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









