

Python爬虫实战:抓取静态网页数据并保存为CSV
本文详解使用 Python 进行静态网页数据抓取并存入 CSV 的完整流程,涵盖环境依赖、HTTP请求伪装、DOM选择器提取、空值防御及 utf-8-sig 编码持久化。
抓取静态网页的核心在于向目标服务器发送合法的 HTTP GET 请求,获取服务端直接渲染生成的完整 HTML 文档,随后通过 DOM 解析器提取指定结构化字段,最终通过文件流以规范的编码格式写入 CSV 文件。本文以 Python 生态中成熟的 requests 与 BeautifulSoup4 组合为例,完整实现从请求伪装、数据清洗、异常防御到 CSV 文件的安全落盘全流程。
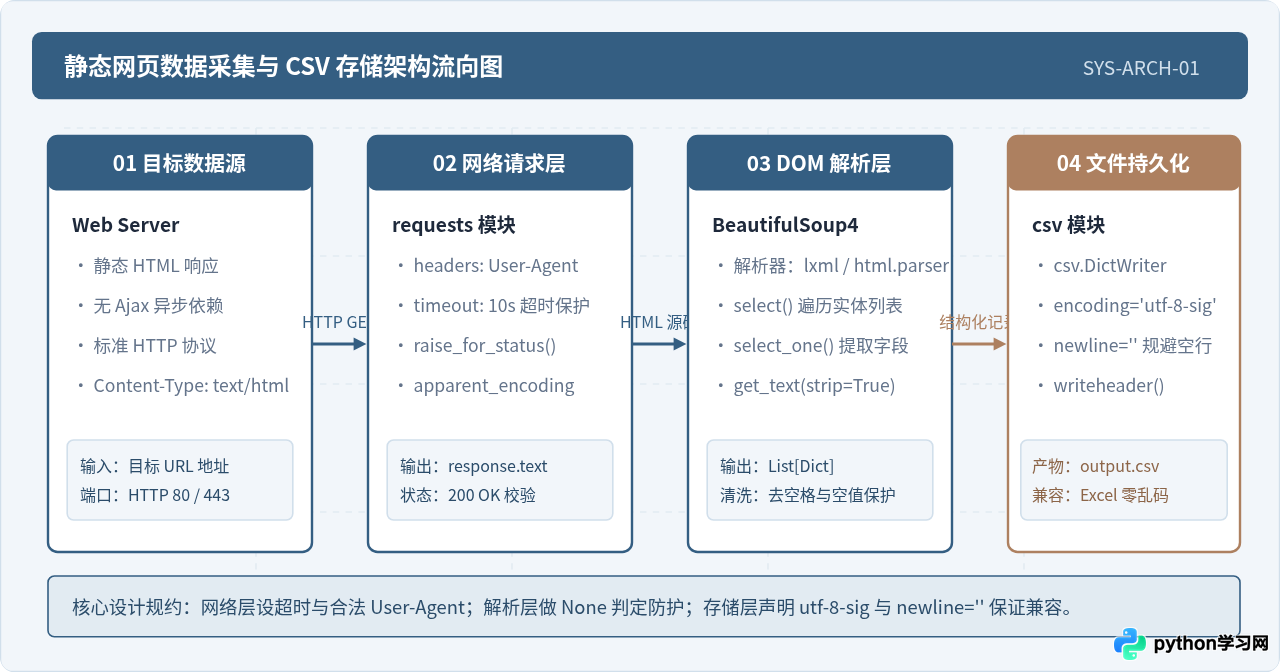
一、数据采集架构与执行流向
在开始编写代码前,必须明确静态网页抓取的技术边界。静态网页的特征是客户端请求的 URL 所返回的 HTML 文本中,已经包含了用户在浏览器中看到的最终文字与排版数据,不依赖页面加载后执行的二次 Ajax 异步接口。因此,我们只需要模拟客户端网络握手,将 HTML 下载至本地内存解析即可。
二、开发准备与依赖环境安装
本项目基于 Python 3 标准运行环境,仅需安装网络请求与 HTML 解析两个外部依赖。Python 内置的 csv 库用于处理表格写入,无需额外安装。
在终端或命令行执行以下命令安装依赖:
pip install requests beautifulsoup4 lxml各依赖项的作用如下:
- requests:简洁强大的 HTTP 客户端库,用于向服务器发送请求并获取返回的网页原始代码。
- beautifulsoup4:HTML/XML 文档解析库,可将杂乱的 HTML 字符串构建为结构化对象树。
- lxml:高性能 C 语言解析后端,相较于 Python 自带的
html.parser,其解析速度更快且对非标准语法的容错能力更强。
三、网页结构分析与 CSS 选择器提取原理
抓取数据的首要前提是在浏览器中确认目标元素的定位路径。打开目标页面后,右键点击想要抓取的字段(例如标题或价格),选择“检查”(Inspect)调出开发者工具,观察 HTML 树状结构。
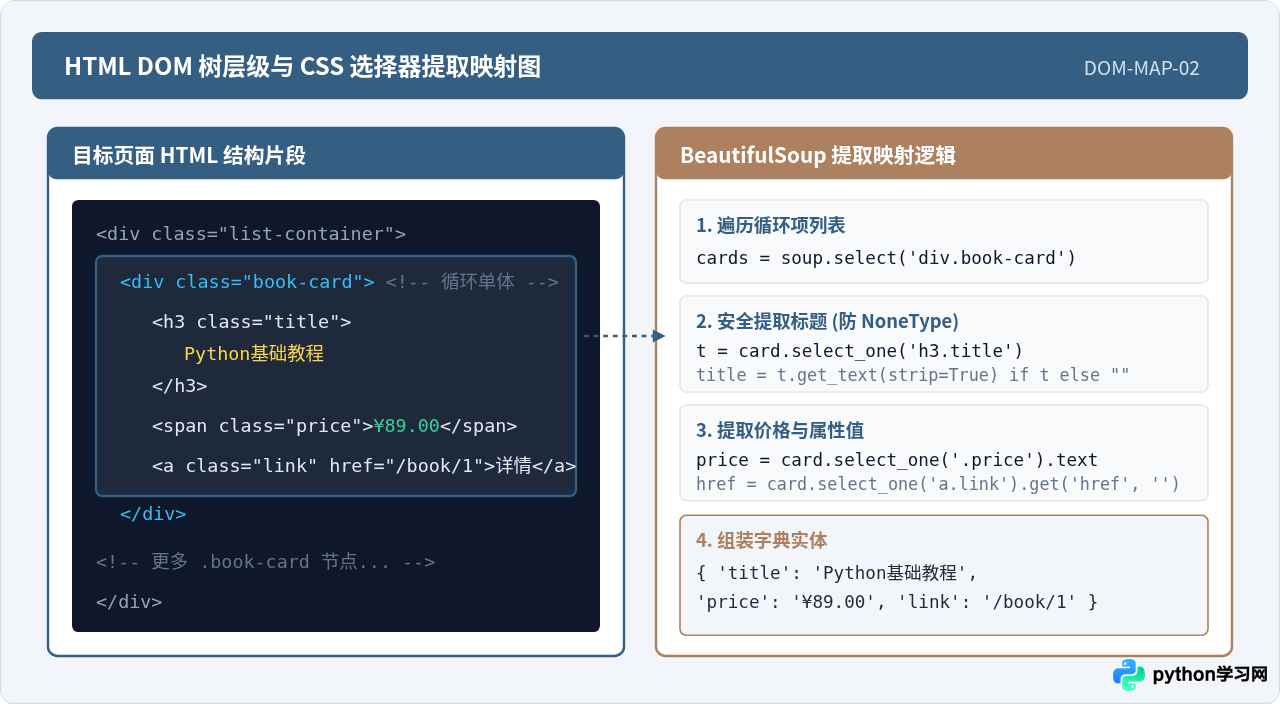
在结构分析中,最核心的工作是区分循环容器节点与属性子节点。例如,一个商品列表页中包含若干个带有 class 属性为 book-card 的 <div> 容器,每个容器内部又分别嵌套了存放标题的 <h3 class="title"> 和存放价格的 <span class="price">。解析时应先获取全部容器节点,再在各个容器的局部作用域内提取字段,避免字段出现错位。
四、关键步骤与实现细节
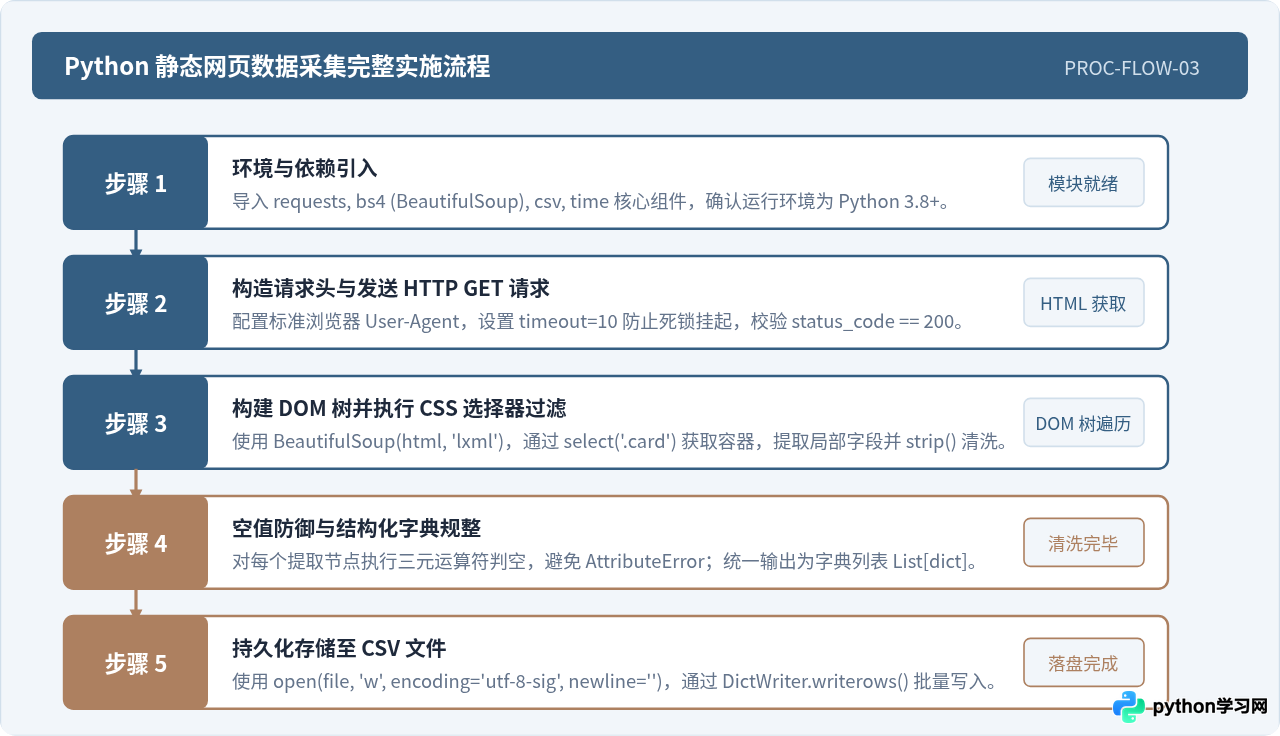
完成一个高稳定性的静态网页爬虫,需严格按顺序推进五个核心实施步骤。从最开始的请求伪装,到中间的异常容错,再到最后的编码落盘,每一步都存在特定的工程陷阱。
1. 网络请求发起与 Headers 伪装
许多 Web 服务器在检测到默认的 python-requests/x.x.x 请求头时,会直接返回 HTTP 403 Forbidden 拦截访问。因此,必须在请求头中传入标准的 User-Agent 属性。此外,必须显式传入 timeout 参数,防止因服务端网络挂起导致爬虫程序无限期阻塞。
import requests

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'
}

response = requests.get('https://example.com/books', headers=headers, timeout=10)
# 遇到 4xx/5xx 状态码时直接抛出异常
response.raise_for_status()

# 自动处理中文编码,防止中文网页乱码
response.encoding = response.apparent_encoding
2. 数据清洗与缺失值安全防御
真实网页中的数据往往存在缺失情况。例如某些商品有“促销标签”,而另一些没有。如果直接调用 item.select_one('.tag').text,一旦元素不存在就会抛出 AttributeError: 'NoneType' object has no attribute 'text' 导致整个采集崩溃。必须采用三元判断或局部函数做安全提取:
# 安全提取函数示例
def extract_text(parent, selector, default=''):
    node = parent.select_one(selector)
    return node.get_text(strip=True) if node else default
3. CSV 文件格式化规范与 Excel 乱码解决
保存 CSV 文件看似简单,但初学者极易遇到两个经典缺陷:
- 中文在 Excel 中显示为乱码:Windows 系统下的 Microsoft Excel 默认使用本地 ANSI(如 GBK)解码 CSV 文件。若直接使用
encoding='utf-8'写入文件,Excel 无法自动识别该编码。解决办法是使用encoding='utf-8-sig',在文件头部写入 UTF-8 的 BOM(Byte Order Mark)特征标记,Excel 识别后即可正确显示中文。 - 隔行产生多余空行:Python 3 的
open()函数在 Windows 平台上默认将\n转换为\r\n,而csv.writer内部也维护了换行逻辑,导致写入时每行数据后均多出一个空行。解决办法是在open()时显式设置newline=''。
五、完整实战代码与可运行示例
以下为一个完整的可运行脚本。代码中构造了模拟目标网页数据,展示了从发送请求、解析列表、抽取字段到持久化写入 CSV 的全套结构化逻辑。
import csv
import sys
import requests
from bs4 import BeautifulSoup

def fetch_and_save_data(output_csv_path='books_data.csv'):
    # 1. 目标 URL 与标准请求头配置
    # 此处使用知名的公开爬虫练习网站
    target_url = 'https://books.toscrape.com/'
    headers = {
        'User-Agent': (
            'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) '
            'AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'
        )
    }

    print(f"[1/4] 正在请求目标页面: {target_url}...")
    try:
        response = requests.get(target_url, headers=headers, timeout=12)
        response.raise_for_status()
        response.encoding = response.apparent_encoding
    except requests.RequestException as e:
        print(f"网络请求失败: {e}", file=sys.stderr)
        return False

    # 2. 构建 DOM 树
    print("[2/4] 正在解析 HTML 结构...")
    soup = BeautifulSoup(response.text, 'lxml')

    # 3. 循环遍历提取字段
    # 该网站每个商品卡片对应的 DOM 节点为 article.product_pod
    items = soup.select('article.product_pod')
    if not items:
        print("未定位到数据节点,请检查选择器或页面源码。", file=sys.stderr)
        return False

    records = []
    print(f"[3/4] 正在提取与清洗数据,检测到 {len(items)} 条实体...")
    for idx, item in enumerate(items, start=1):
        # 提取图书标题:位于 h3 下的 a 标签 title 属性或文本
        title_tag = item.select_one('h3 a')
        title = title_tag.get('title', '').strip() if title_tag else ''
        if not title and title_tag:
            title = title_tag.get_text(strip=True)

        # 提取价格:.price_color
        price_tag = item.select_one('.price_color')
        price = price_tag.get_text(strip=True) if price_tag else '0.00'

        # 提取库存状态:.instock.availability
        stock_tag = item.select_one('.instock.availability')
        stock = stock_tag.get_text(strip=True) if stock_tag else '未知'

        # 提取详情相对链接并组装
        link_tag = item.select_one('h3 a')
        rel_link = link_tag.get('href', '').strip() if link_tag else ''
        full_url = f"{target_url}{rel_link}" if rel_link else ''

        records.append({
            '序号': idx,
            '书名': title,
            '价格': price,
            '库存状态': stock,
            '详情链接': full_url
        })

    # 4. 持久化存储至 CSV
    print(f"[4/4] 正在写入 CSV 文件: {output_csv_path}...")
    fieldnames = ['序号', '书名', '价格', '库存状态', '详情链接']
    try:
        with open(output_csv_path, mode='w', encoding='utf-8-sig', newline='') as csvfile:
            writer = csv.DictWriter(csvfile, fieldnames=fieldnames)
            # 写入表头
            writer.writeheader()
            # 批量写入所有行
            writer.writerows(records)
    except IOError as e:
        print(f"文件写入失败: {e}", file=sys.stderr)
        return False

    print(f"数据采集与保存成功!共写入 {len(records)} 条数据。")
    return True

if __name__ == '__main__':
    fetch_and_save_data('books_output.csv')
运行输出结果示例
在本地终端执行上述脚本后,终端打印的标准运行流程如下:
[1/4] 正在请求目标页面: https://books.toscrape.com/...
[2/4] 正在解析 HTML 结构...
[3/4] 正在提取与清洗数据,检测到 20 条实体...
[4/4] 正在写入 CSV 文件: books_output.csv...
数据采集与保存成功!共写入 20 条数据。
生成的 books_output.csv 文件用文本编辑器打开后的内容片段展示如下(符合标准 RFC 4180 CSV 格式):
序号,书名,价格,库存状态,详情链接
1,A Light in the Attic,£51.77,In stock,https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html
2,Tipping the Velvet,£53.74,In stock,https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html
3,Soumission,£50.10,In stock,https://books.toscrape.com/catalogue/soumission_998/index.html
六、常见问题诊断与防护对策
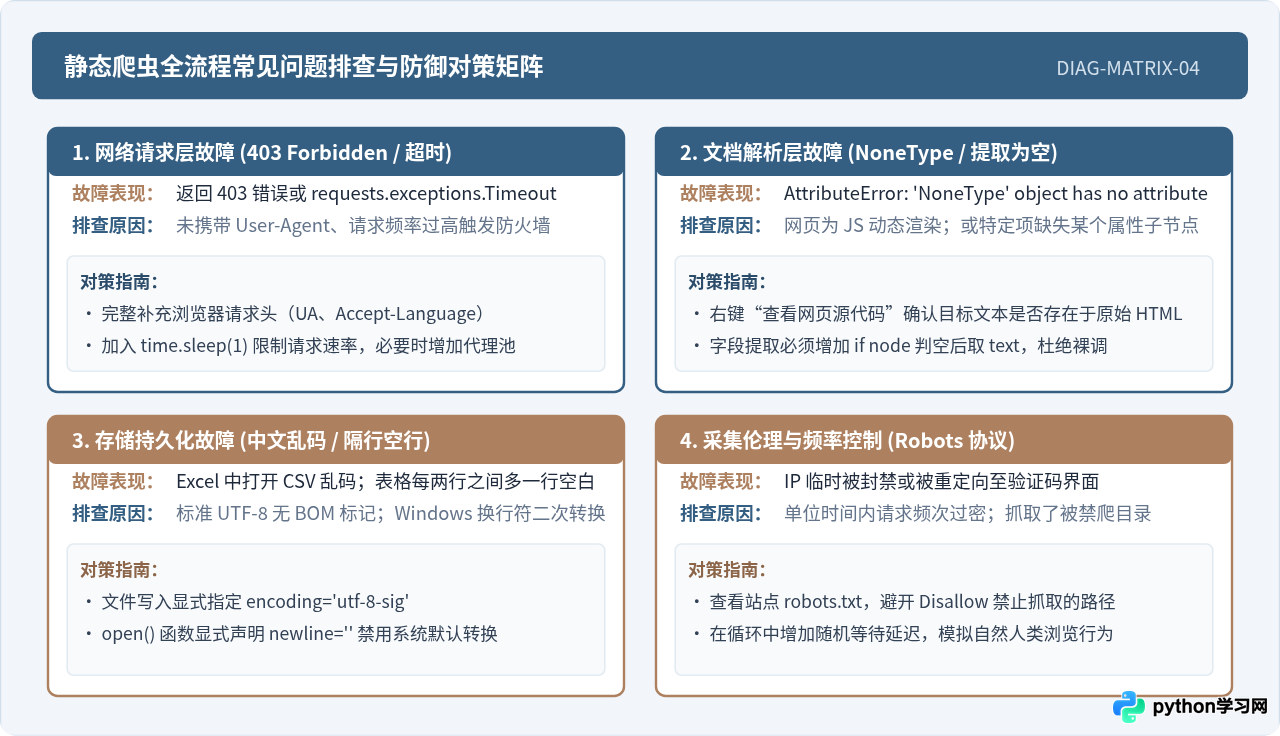
在实际爬取不同网站的过程中,开发者经常遇到网络受限、解析失效或数据格式损坏等问题。下表与图示总结了从网络请求到持久化存储全生命周期中最常见的问题及针对性解决方案。
七、验证输出结果与检查清单
完成数据抓取与保存后,可以通过以下几个步骤快速验证产物的完整性与准确性:
- 行数核对:在终端运行
wc -l books_output.csv,确认数据行数(除去首行表头)是否与网页展示的卡片数量完全一致。 - 字段对齐校验:通过普通文本查看工具抽查首行与尾行数据,检查是否因为标题内部含有半角逗号
,导致分列错位。由于使用了标准csv.DictWriter,含有逗号的字段会自动被双引号包裹(例如"Title, Part 2"),确保列数对齐。 - Excel 打开测试:在 Windows 环境下双击使用 Microsoft Excel 打开导出的 CSV 文件,确认中文字符正常显示,各列排布清晰且无空行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









