

Python批量爬取百度指定类别图片的完整实现方案

发布时间:2026-10-14| 5人浏览过
本文介绍如何利用Python脚本批量爬取百度指定类别的图片。通过配置关键词文件name.txt、设定每类图片数量,并运行提供的源代码,可实现自动化下载。文章涵盖核心逻辑解析与完整代码示例,帮助开发者快速掌握批量获取网络图片的方法,适用于数据采集与素材收集场景。
爬取配置与准备工作
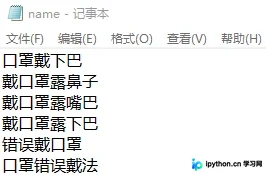
实现利用Python批量爬取百度任意类别图片的功能,主要包含以下三个关键步骤: (1):定义需要爬取的类别名称。 (2):设定每个类别下需要爬取的具体图片数量。 (3):创建一个名为name.txt的文本文件,在其中输入作为关键字的类别名称。确保该txt文件与Python源代码文件位于同一目录下。
Python核心代码实现
以下是实现该功能的Python源代码:
# -*- coding: utf-8 -*-
"""
Created on Sun Sep 13 21:35:34 2020
@author: ydc
"""
import re
import requests
from urllib import error
from bs4 import BeautifulSoup
import os

num = 0
numPicture = 0
file = ''
List = []
def Find(url, A):
  global List
  print('正在检测图片总数,请稍等.....')
  t = 0
  i = 1
  s = 0
  while t < 1000:
    Url = url + str(t)
    try:
      # 这里搞了下
      Result = A.get(Url, timeout=7, allow_redirects=False)
    except BaseException:
      t = t + 60
      continue
    else:
      result = Result.text
      pic_url = re.findall('"objURL":"(.*?)",', result, re.S) # 先利用正则表达式找到图片url
      s += len(pic_url)
      if len(pic_url) == 0:
        break
      else:
        List.append(pic_url)
        t = t + 60
  return s
def recommend(url):
  Re = []
  try:
    html = requests.get(url, allow_redirects=False)
  except error.HTTPError as e:
    return
  else:
    html.encoding = 'utf-8'
    bsObj = BeautifulSoup(html.text, 'html.parser')
    div = bsObj.find('div', id='topRS')
    if div is not None:
      listA = div.findAll('a')
      for i in listA:
        if i is not None:
          Re.append(i.get_text())
    return Re
def dowmloadPicture(html, keyword):
  global num
  # t =0
  pic_url = re.findall('"objURL":"(.*?)",', html, re.S) # 先利用正则表达式找到图片url
  print('找到关键词:' + keyword + '的图片,即将开始下载图片...')
  for each in pic_url:
    print('正在下载第' + str(num + 1) + '张图片,图片地址:' + str(each))
    try:
      if each is not None:
        pic = requests.get(each, timeout=7)
      else:
        continue
    except BaseException:
      print('错误,当前图片无法下载')
      continue
    else:
      string = file + r'\\' + keyword + '_' + str(num) + '.jpg'
      fp = open(string, 'wb')
      fp.write(pic.content)
      fp.close()
      num += 1
    if num >= numPicture:
      return
if __name__ == '__main__': # 主函数入口
  headers = {
    'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2',
    'Connection': 'keep-alive',
    'User-Agent': 'Mozilla/5.0 (X11; Linux x86_64; rv:60.0) Gecko/20100101 Firefox/60.0',
    'Upgrade-Insecure-Requests': '1'
  }
  A = requests.Session()
  A.headers = headers
  ###############################
  tm = int(input('请输入每类图片的下载数量 '))
  numPicture = tm
  line_list = []
  with open('./name.txt', encoding='utf-8') as file:
    line_list = [k.strip() for k in file.readlines()] # 用 strip()移除末尾的空格
  for word in line_list:
    url = 'https://image.baidu.com/search/flip?tn=baiduimage&ie=utf-8&word=' + word + '&pn='
    tot = Find(url, A)
    Recommend = recommend(url) # 记录相关推荐
    print('经过检测%s类图片共有%d张' % (word, tot))
    file = word + '文件'
    y = os.path.exists(file)
    if y == 1:
      print('该文件已存在,请重新输入')
      file = word + '文件夹2'
      os.mkdir(file)
    else:
      os.mkdir(file)
    t = 0
    tmp = url
    while t < numPicture:
      try:
        url = tmp + str(t)
        # result = requests.get(url, timeout=10)
        # 这里搞了下
        result = A.get(url, timeout=10, allow_redirects=False)
        print(url)
      except error.HTTPError as e:
        print('网络错误,请调整网络后重试')
        t = t + 60
      else:
        dowmloadPicture(result.text, word)
        t = t + 60
    # numPicture = numPicture + tm
  print('当前搜索结束,感谢使用')
至此,关于利用Python批量爬取百度任意类别图片的实现方法介绍完毕。如需了解更多关于Python批量爬取百度图片的内容,建议查阅本站历史文章或继续阅读后续相关教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









