

Python实现天气网卫星云图自动下载与保存

发布时间:2026-10-14| 5人浏览过
本文介绍使用Python从国家气象中心网站批量下载风云四号卫星云图的完整方案。通过构建URL生成逻辑与多线程请求机制,实现指定日期下每15分钟一张的高清卫星图片自动抓取。代码包含文件夹管理、断点续传逻辑及耗时统计,适用于气象数据分析前的数据准备工作。
相关项目的完整代码托管于以下仓库:
https://github.com/MrWayneLee/weather-demo
核心代码实现解析
文件下载与生成逻辑
# 下载并生成文件
def downloadImg(imgDate, imgURLs, pathName):
    a,s,f = 0,0,0
    timeStart = time.time()
    while a < len(imgURLs):
        req = requests.get(imgURLs[a])
        imgName = str(imgURLs[a])[-13:-9]
        print(str("开始请求" + imgDate + " " + imgName + "的数据"))
        if req.status_code == 200:
            open(pathName + '\\' + os.path.basename(imgName) + '.png', 'wb').write(req.content)
            print("数据" + imgDate + " " + imgName + "下载完成")
            s += 1
            del req
        elif req.status_code == 404:
            print("数据" + imgDate + " " + imgName + "不存在")
            f += 1
        a += 1
    timeEnd = time.time()
    totalTime = round(timeEnd - timeStart, 2)
    print("全部数据请求完成!总耗时:",totalTime,"秒")
    print("共请求", a, "次;成功", s, "次;失败", f, "次")
目录结构创建模块
def createFolder(pathName):
    imgName_Year = pathName[0:4]
    imgName_Month = pathName[4:6]
    imgName_Day = pathName[6:8]
    imgName_date = imgName_Year + '-' + imgName_Month + '-' + imgName_Day

    mainPath = 'F:\\[Wayne Lee]\\学习资料\\Python\\爬取图像'
    newPathName = mainPath + '\\' + imgName_date
    realPath = newPathName + '\\'

    isExists = os.path.exists(newPathName)

    if not isExists:
        os.makedirs(newPathName)
        print("新文件夹 [" + imgName_date + "] 创建成功")
        return realPath
    else:
        print(pathName + "文件夹已存在")
        return realPath
时间序列生成算法
def generateTime(imgUrl):
    timeList = []
    imgUrlList = []
    h,j = 0,0
    while h < 24:
        m = 0
        while m < 60:
            timeList.append("{:0>4d}".format(h * 100 + m))
            m += 15
        h += 1
    # print(timeList)
    # print(len(timeList))
    while j < len(timeList):
        imgUrlList.append(str(imgUrl + timeList[j] + "00000.JPG"))
        # print(timeList[j])
        j += 1
    return imgUrlList
    # print(imgUrlList)
    # print(len(imgUrlList))
下载链接构建函数
def downloadUrl(imgDate):
    imgUrl = "http://image.nmc.cn/product/" + imgDate[0:4] + "/" + imgDate[4:6] + "/" + imgDate[6:8] + "/WXBL/SEVP_NSMC_WXBL_FY4A_ETCC_ACHN_LNO_PY_" + imgDate # + "0000" +"00000.JPG"
    URLlist = list(generateTime(imgUrl))
    return URLlist
程序主入口控制
# 主函数
if __name__ == '__main__':
    # imgUrl = "http://image.nmc.cn/product/2020/04/11/WXBL/SEVP_NSMC_WXBL_FY4A_ETCC_ACHN_LNO_PY_20200411044500000.JPG"
    # imgUrl = "http://image.nmc.cn/product/2020/04/11/WXBL/SEVP_NSMC_WXBL_FY4A_ETCC_ACHN_LNO_PY_20200411"
    # imgName = imgUrl[-21:-9]

    while True:
        print("[1]手动输入日期")
        print("[2]获取当天日期")
        print("[3]退出程序")
        choose = str(input("你的选择:"))
        if choose == "1":
            imgDate = str(input("请输入日期[如20200411]:"))
            urlList = list(downloadUrl(imgDate))
            break
        elif choose == "2":
            imgDate = time.strftime("%Y%m%d",time.localtime())
            urlList = list(downloadUrl(imgDate))
            break
        elif choose == "3":
            break
        else:
            print("你的选择有误!请重试")
执行流程说明
    pathName = createFolder(imgDate)
    # 开始下载
    downloadImg(imgDate, urlList, pathName)
完整源代码展示
import requests
import time
import datetime
import os

# 下载并生成文件
def downloadImg(imgDate, imgURLs, pathName):
    a,s,f = 0,0,0
    timeStart = time.time()
    while a < len(imgURLs):
        req = requests.get(imgURLs[a])
        imgName = str(imgURLs[a])[-13:-9]
        print(str("开始请求" + imgDate + " " + imgName + "的数据"))
        if req.status_code == 200:
            open(pathName + '\\' + os.path.basename(imgName) + '.png', 'wb').write(req.content)
            print("数据" + imgDate + " " + imgName + "下载完成")
            s += 1
            del req
        elif req.status_code == 404:
            print("数据" + imgDate + " " + imgName + "不存在")
            f += 1
        a += 1
    timeEnd = time.time()
    totalTime = round(timeEnd - timeStart, 2)
    print("全部数据请求完成!总耗时:",totalTime,"秒")
    print("共请求", a, "次;成功", s, "次;失败", f, "次")

# 创建文件夹
def createFolder(pathName):
    imgName_Year = pathName[0:4]
    imgName_Month = pathName[4:6]
    imgName_Day = pathName[6:8]
    imgName_date = imgName_Year + '-' + imgName_Month + '-' + imgName_Day

    mainPath = 'F:\\[Wayne Lee]\\学习资料\\Python\\爬取图像'
    newPathName = mainPath + '\\' + imgName_date
    realPath = newPathName + '\\'

    isExists = os.path.exists(newPathName)

    if not isExists:
        os.makedirs(newPathName)
        print("新文件夹 [" + imgName_date + "] 创建成功")
        return realPath
    else:
        print(pathName + "文件夹已存在")
        return realPath

# 生成时间列表
def generateTime(imgUrl):
    timeList = []
    imgUrlList = []
    h,j = 0,0
    while h < 24:
        m = 0
        while m < 60:
            timeList.append("{:0>4d}".format(h * 100 + m))
            m += 15
        h += 1
    # print(timeList)
    # print(len(timeList))
    while j < len(timeList):
        imgUrlList.append(str(imgUrl + timeList[j] + "00000.JPG"))
        # print(timeList[j])
        j += 1
    return imgUrlList
    # print(imgUrlList)
    # print(len(imgUrlList))

# 生成下载URL列表
def downloadUrl(imgDate):
    imgUrl = "http://image.nmc.cn/product/" + imgDate[0:4] + "/" + imgDate[4:6] + "/" + imgDate[6:8] + "/WXBL/SEVP_NSMC_WXBL_FY4A_ETCC_ACHN_LNO_PY_" + imgDate # + "0000" +"00000.JPG"
    URLlist = list(generateTime(imgUrl))
    return URLlist

# 主函数
if __name__ == '__main__':
    # imgUrl = "http://image.nmc.cn/product/2020/04/11/WXBL/SEVP_NSMC_WXBL_FY4A_ETCC_ACHN_LNO_PY_20200411044500000.JPG"
    # imgUrl = "http://image.nmc.cn/product/2020/04/11/WXBL/SEVP_NSMC_WXBL_FY4A_ETCC_ACHN_LNO_PY_20200411"
    # imgName = imgUrl[-21:-9]

    while True:
        print("[1]手动输入日期")
        print("[2]获取当天日期")
        print("[3]退出程序")
        choose = str(input("你的选择:"))
        if choose == "1":
            imgDate = str(input("请输入日期[如20200411]:"))
            urlList = list(downloadUrl(imgDate))
            break
        elif choose == "2":
            imgDate = time.strftime("%Y%m%d",time.localtime())
            urlList = list(downloadUrl(imgDate))
            break
        elif choose == "3":
            break
        else:
            print("你的选择有误!请重试")

    # 创建文件夹
    pathName = createFolder(imgDate)
    # 开始下载
    downloadImg(imgDate, urlList, pathName)
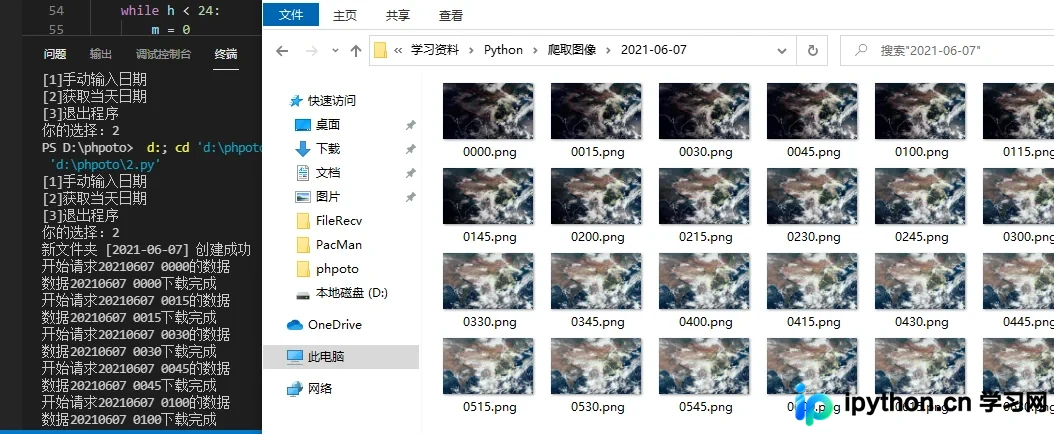
运行结果示例
关于Python抓取天气网卫星图像的详细教程至此结束,如需获取更多相关技术资讯,请查阅本站其他文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









