

Python多线程:threading与GIL理解

threading基础:创建、启动与管理线程
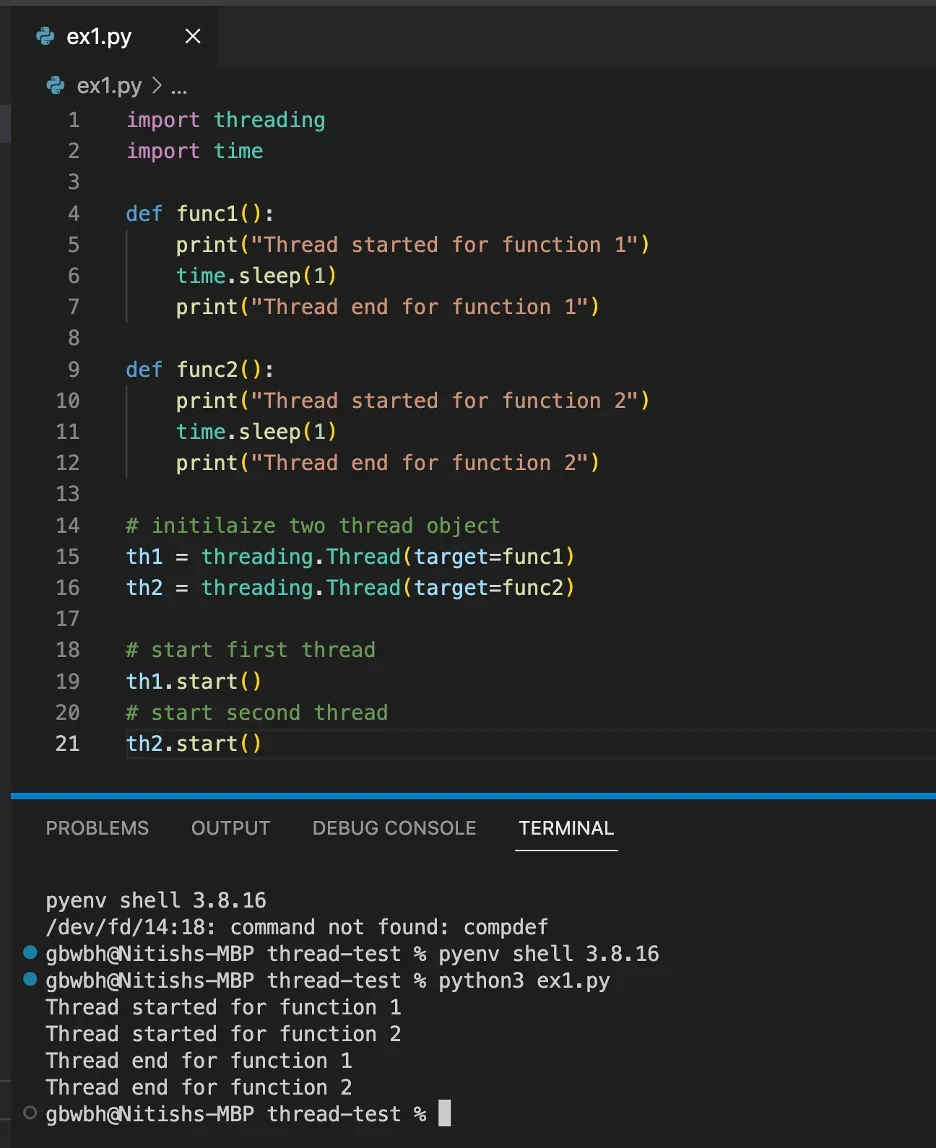
线程是操作系统能够进行运算调度的最小单位,它被包含在进程之中,是进程中的实际运作单位。在Python中,threading模块提供了高级的线程接口。创建线程的核心类是threading.Thread,其关键参数包括target(指定线程要执行的函数)、args(以元组形式传递的位置参数)以及daemon(布尔值,决定主线程退出时是否强制终止该子线程)。启动线程必须调用start()方法,它会在底层向操作系统申请资源并安排执行;而join()方法用于阻塞当前主线程,直到目标线程执行完毕,常用于确保所有子任务完成后再继续后续逻辑。例如,通过循环实例化三个Thread对象并分别调用start()与join(),即可实现并发执行多个独立函数。注意,直接调用run()方法并不会开启新线程,仅相当于普通函数调用。
GIL到底是什么:为什么线程不等于并行
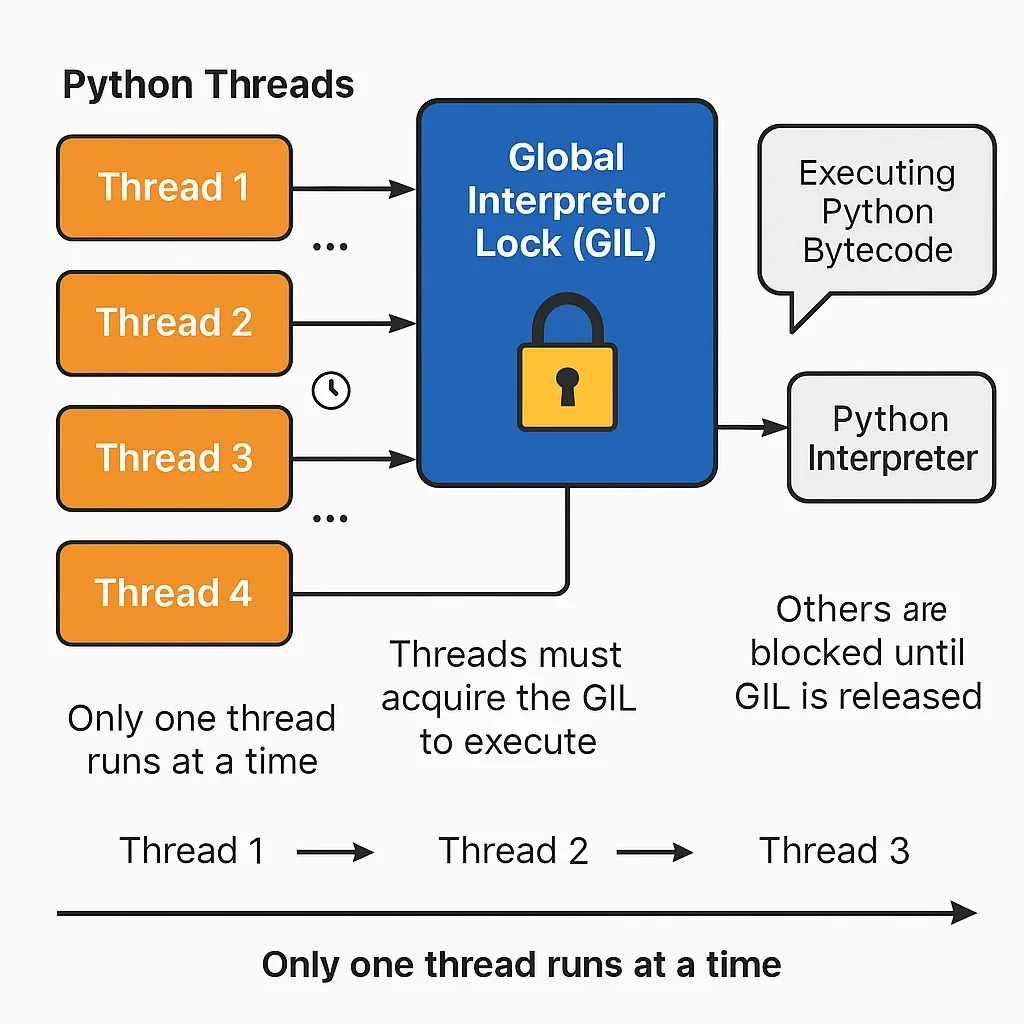
GIL(全局解释器锁)是CPython解释器内部的一个互斥锁,其设计初衷是为了保护Python对象的内存管理免受多线程并发访问的破坏。由于GIL的存在,同一时刻只能有一个线程执行Python字节码,这意味着在纯Python代码层面,多线程无法实现真正的CPU并行计算。然而,这并不意味着线程毫无用处。当线程执行阻塞型I/O操作(如网络请求、文件读写)或调用底层C扩展库时,GIL会被主动释放,此时其他线程可以获取GIL并继续执行。因此,对于I/O密集型任务,多线程能有效利用等待时间提升吞吐量;而对于纯Python编写的CPU密集型任务,GIL会导致线程频繁切换却无实质并行加速,甚至因上下文切换开销而变慢。理解GIL的释放时机,是合理选择并发模型的关键。
动手验证:IO密集型与CPU密集型性能对比
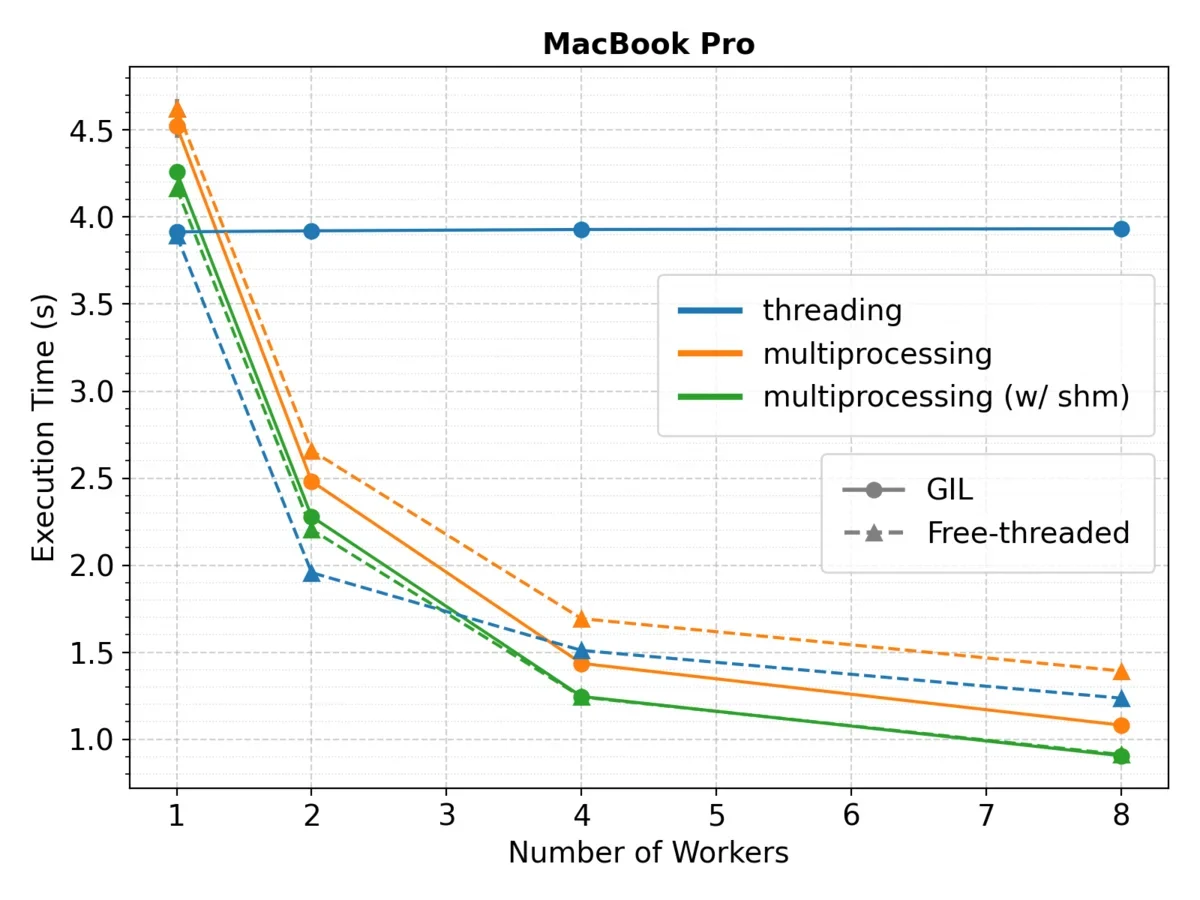
为直观验证GIL的影响,可设计两组对照实验。第一组为CPU密集型:定义一个执行一千万次浮点运算的函数,分别使用单线程、threading创建4个线程以及multiprocessing创建4个进程运行,并使用time.perf_counter()记录耗时。实验结果通常显示,多线程耗时与单线程相近甚至更长,而多进程耗时显著缩短,印证了GIL对CPU计算的串行限制。第二组为I/O密集型:模拟网络请求,使用time.sleep(1)代替实际请求,同样对比单线程、多线程与多进程。此时多线程总耗时接近1秒(并发等待),远优于单线程的4秒,多进程虽也能并发但进程创建开销更大。实验中需严格控制任务数量、硬件核心数及计时起点终点,确保变量唯一。该对比清晰表明:I/O任务选多线程,CPU任务选多进程。
线程安全与常见坑:共享数据、锁和正确选型
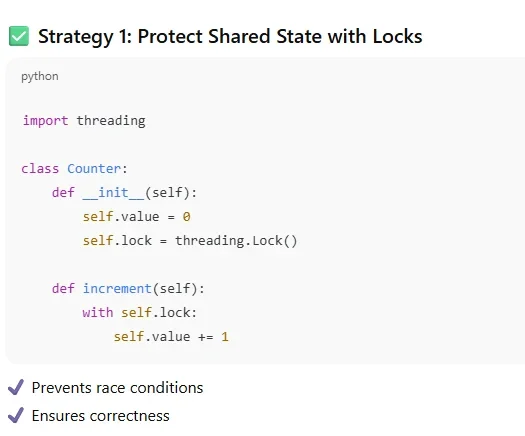
多线程共享可变数据时极易引发竞态条件。例如多个线程同时对全局计数器执行counter += 1,由于该操作非原子性(包含读取、计算、写入三步),最终结果往往小于预期。解决此问题需引入同步机制,最基础的是threading.Lock。通过with lock:上下文管理器包裹临界区代码,可确保同一时刻仅一个线程访问共享资源。但滥用锁会导致性能骤降,甚至因嵌套加锁顺序不当引发死锁。此外,盲目为每个任务创建线程会耗尽系统资源,应使用线程池控制并发上限。选型原则需牢记:I/O密集型且需简单并发时优先threading;纯CPU计算或需完全并行时选用multiprocessing;高并发网络服务且逻辑复杂时,推荐asyncio配合协程,以单线程事件循环实现极高吞吐。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









