


在 Go 项目里,for 和 range 几乎每天都在用,真正容易踩坑的不是“会不会写”,而是它们在不同数据类型上的成本并不一样。下面就按常见使用场景拆开看:先对比写法和基准结果,再解释为什么大结构体会把差距放大,最后给出更适合日常开发的选型原则。
先看写法差异:什么时候更适合 for,什么时候更适合 range
传统 for 循环更强调控制力,适合需要索引、步进控制或直接修改原始元素的情况:
// 经典三段式
for i := 0; i < len(slice); i++ {
    // 通过索引访问元素
    element := slice[i]
}
它的优势是迭代过程完全可控,也更适合涉及原地修改的代码。
range 的写法则更紧凑,适合做普通遍历:
// 遍历值
for _, value := range slice {
    // 使用value
}

// 遍历索引和值
for index, value := range slice {
    // 使用index和value
}它的优势是可读性高,少写边界处理,也天然适合数组、切片、map 和 channel 这类集合类型。
如果只从语法层面看,很多人会直接把 range 当作“更现代”的默认选项;但性能上能不能放心用,关键还是要看遍历的到底是什么数据。
三组基准测试:差距不是固定的,要看元素本身
基本类型切片:几乎可以按可读性来选
先看 []int 这种最常见的基本类型切片:
// 基准测试代码
func BenchmarkForIntSlice(b *testing.B) {
    nums := make([]int, 1<<20) // 100万个整数
    for i := 0; i < b.N; i++ {
        tmp := 0
        for j := 0; j < len(nums); j++ {
            tmp = nums[j]
        }
        _ = tmp
    }
}

func BenchmarkRangeIntSlice(b *testing.B) {
    nums := make([]int, 1<<20)
    for i := 0; i < b.N; i++ {
        tmp := 0
        for _, v := range nums {
            tmp = v
        }
        _ = tmp
    }
}
测试结果:
for:约 324,512 ns/oprange:约 322,744 ns/op
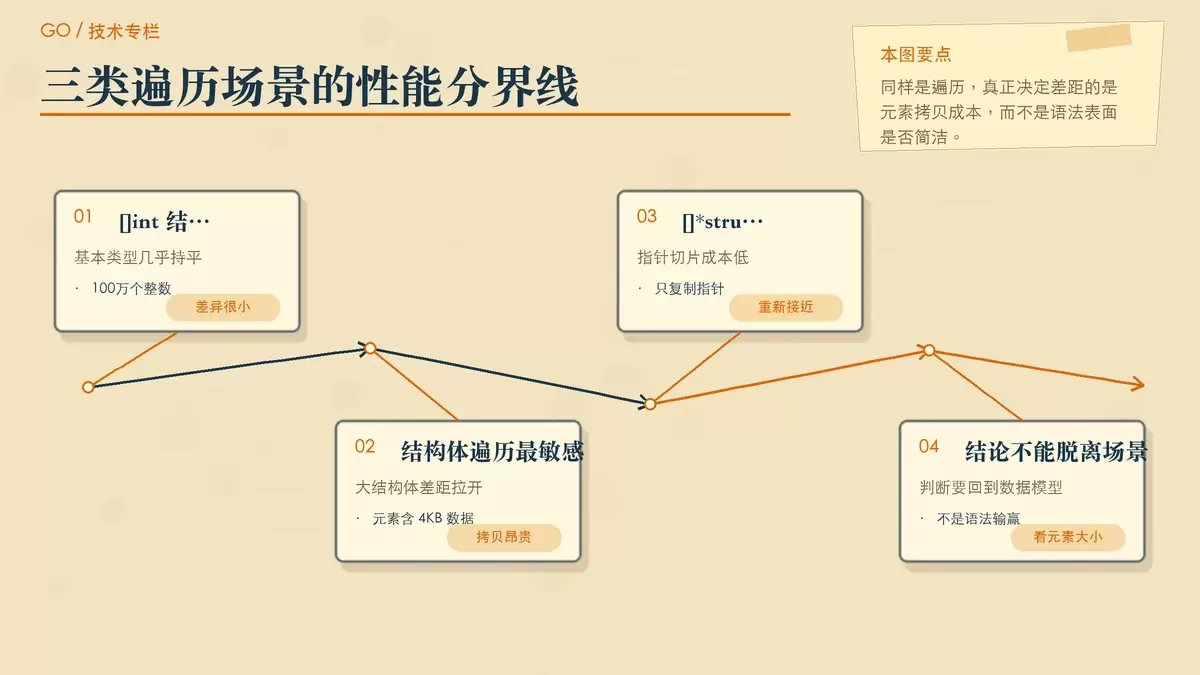
这个场景下,两者几乎没有实质差异。也就是说,如果你遍历的是 int、string、小型对象这类拷贝成本很低的数据,优先选择更简洁的 range 通常没有问题。
大结构体切片:性能差距会被迅速放大
真正的分水岭出现在大对象上:
type LargeItem struct {
    id  int
    val [4096]byte // 每个结构体占用4KB内存
}

func BenchmarkForStruct(b *testing.B) {
    var items [1024]LargeItem
    for i := 0; i < b.N; i++ {
        tmp := 0
        for j := 0; j < len(items); j++ {
            tmp = items[j].id
        }
        _ = tmp
    }
}

func BenchmarkRangeStruct(b *testing.B) {
    var items [1024]LargeItem
    for i := 0; i < b.N; i++ {
        tmp := 0
        for _, item := range items {
            tmp = item.id
        }
        _ = tmp
    }
}
测试结果:
for:约 324 ns/oprange:约 467,411 ns/op
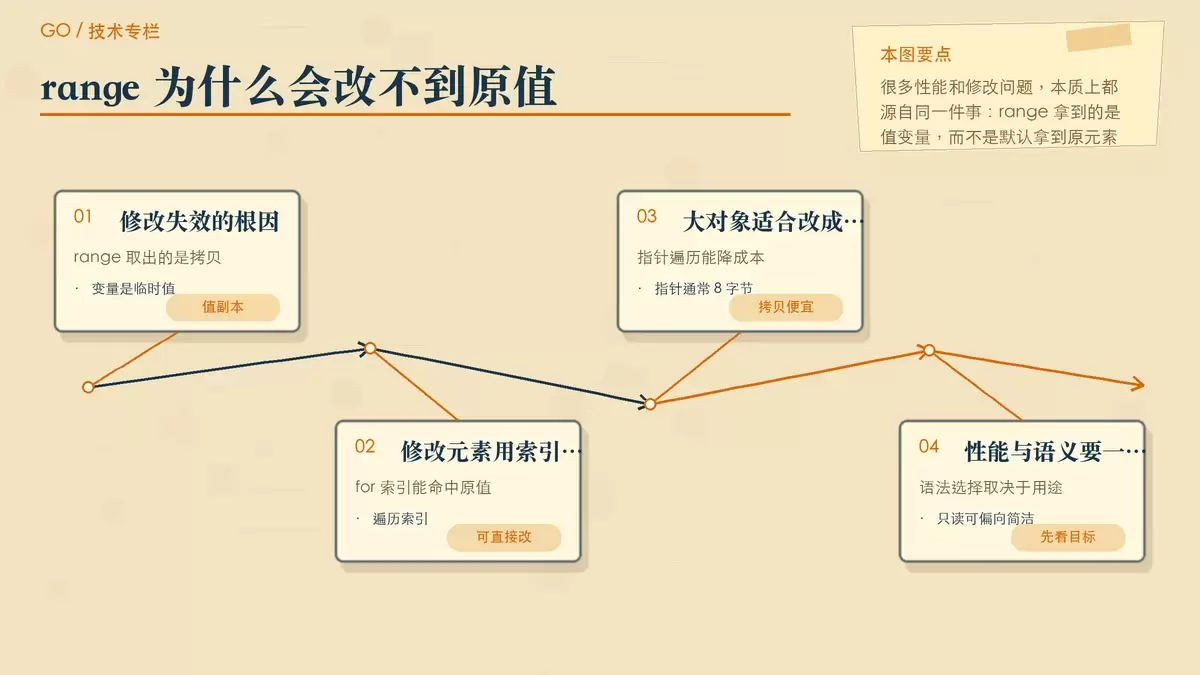
这里的差距已经不是“略慢一点”,而是数量级上的区别。原因不在循环语法本身,而在于 range 取出的 item 是当前元素的一个副本;当每个元素都有 4KB 体积时,这个拷贝成本会在每次迭代里持续累积。
指针切片:range 又会重新变得划算
如果把大结构体改成指针切片,结果会明显不同:
func BenchmarkRangePointer(b *testing.B) {
    items := make([]*LargeItem, 1024)
    // 初始化指针切片...
    for i := 0; i < b.N; i++ {
        tmp := 0
        for _, item := range items {
            tmp = item.id
        }
        _ = tmp
    }
}
测试结果:
for:约 4,160 ns/oprange:约 4,194 ns/op
这时性能又重新接近了。因为遍历时被拷贝的不再是整个结构体,而只是一个指针,通常只需要 8 字节,成本自然低很多。
性能差异的根源:range 取到的是值副本
理解这一点,比记住“某种写法更快”更重要。很多 Go 代码的性能差异,其实都能回到同一个事实:range 在遍历时会把元素值取出来,赋给循环变量。
这个行为不仅影响性能,也会影响修改结果:
type Person struct{ Age int }
people := []Person{{30}, {40}}

// range修改无效(操作的是拷贝)
for _, p := range people {
    p.Age += 10
}

// for修改有效
for i := range people {
    people[i].Age += 10
}
为什么前一段修改无效?因为 p 只是切片元素的副本,改的是临时值,不会写回原切片。
把这个规则套回前面的测试,结论就很清楚了:
- 基本类型:拷贝很便宜,
for和range差异通常可忽略 - 大结构体:每次迭代都可能发生完整拷贝,成本会迅速上升
- 指针类型:只拷贝指针本身,代价远低于拷贝整个对象
所以,性能敏感场景里真正要关注的不是“要不要统一用 range”,而是“当前循环变量拿到的到底是大对象本身,还是一个廉价引用”。
map 和 channel 的遍历要单独看
map:应直接使用 range
map 的遍历方式和切片不同,实践中应该直接用 range:
m := map[string]int{"A": 1, "B": 2}
for k, v := range m {
    // 迭代顺序不确定
    delete(m, "C") // 安全删除未迭代键
    m["D"] = 3     // 新增键可能被迭代到
}
这里需要注意两点:一是 map 的迭代顺序本来就不确定;二是在遍历过程中删除未迭代到的键是安全的,而新增键则“可能”被遍历到,不能依赖顺序和覆盖范围写逻辑。
对于 map,range 本身就是惯用且安全的写法,通常没有必要为了形式统一而绕成别的方案。
channel:range 是消费数据的标准写法
channel 的场景也类似:
ch := make(chan int, 10)
// ...发送数据...
for v := range ch {
    // 处理值,直到ch关闭
}
这类循环会持续接收值,直到 ch 被关闭。它是 Go 中消费通道数据最自然的方式。
需要额外记住的一点是:对 nil 信道使用 range 会永久阻塞。这不是性能问题,而是很典型的运行时行为问题,排查并发代码时经常会遇到。
实战怎么选:先看数据大小,再看是否修改元素
把前面的结论收束到日常开发里,可以按下面的思路选:
1. 基本类型切片:优先考虑代码简洁度
如果遍历的是基本类型切片,或者体积很小的对象,range 往往就是更省心的选择。性能差异很小,代码可读性通常更值得优先考虑。
2. 大内存结构体:避免直接用值遍历
当元素本身很大时,尽量不要写成直接取值的 range。更稳妥的方式有三种:
- 使用传统
for循环按索引访问 - 改成指针切片
[]*T后再配合range - 保留
range,但只遍历索引:for i := range items { items[i]... }
3. 需要修改原元素:不要直接改 range 的值变量
只要目标是修改集合中的原始元素,就不能把 range 取出的值变量当成原对象本身。应当使用索引回写,或者直接处理指针。
一个兼顾可读性和性能的常见写法是:
for i := range items {
    item := &items[i] // 获取指针避免拷贝
    item.Process()    // 直接修改原元素
}
4. map 和 channel:遵循语言惯用法
对于 map 和 channel,没有必要强行套用切片那一套比较方法。该用 range 时就直接用,重点是理解它们各自的行为边界。
最后还要补充一点:Go 1.20+ 对 range 在切片和 map 上的遍历性能做过优化。如果你的代码只涉及只读访问、基本类型或小对象,那么大多数情况下没必要为微小差异牺牲可读性。
归纳成一句话就是:拷贝成本高的地方优先考虑索引或指针,普通业务遍历优先考虑 range 的简洁性。 真正有价值的不是机械地站队,而是知道什么时候语法糖背后会带来真实代价。









