


在 Go 项目里,string 和 []byte 的互转几乎随处可见,HTTP 读写、日志处理、协议解析都会碰到。问题在于,这类转换默认不是“便宜操作”:一旦落在高并发、超高频路径上,内存分配和数据拷贝就可能放大成真实的性能成本。本文会先说明标准转换为什么会拷贝,再看零拷贝实现依赖的底层结构,最后结合基准结果、风险边界和替代方案,判断它到底该不该进生产代码。
为什么这类转换值得单独优化
很多 Go 服务都会在字节流和字符串之间来回切换。典型场景是 HTTP 服务器从网络层拿到的是 []byte,但上层解析、匹配、拼接时常常又要用 string。
如果这类转换只出现几次,问题并不明显;但在高并发、长连接或批量处理场景里,频繁互转会反复触发分配和拷贝,最后落到 CPU 和 GC 压力上。也就是说,性能瓶颈未必来自业务逻辑本身,可能就藏在这些看起来不起眼的类型转换里。
标准转换为什么一定会拷贝
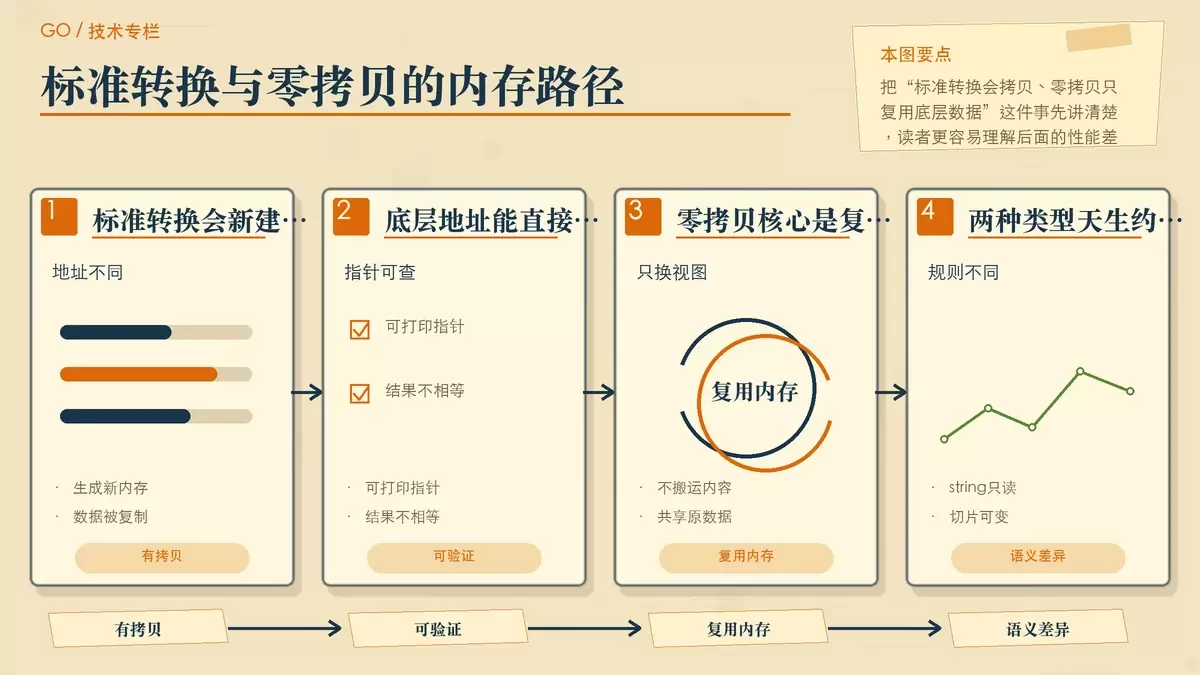
Go 里 string 是不可变的只读字节序列,而 []byte 是可变切片。这种语义差异决定了标准转换通常要重新分配内存,并把底层数据复制过去:
s := "Hello, World"
b := []byte(s)  // 分配新内存并拷贝数据
s2 := string(b) // 同样分配新内存并拷贝
这个结论可以直接通过底层指针验证。转换前后的数据地址不同,说明新对象确实被创建了:
func main() {
    s := "hello, gopher"
    ps := unsafe.StringData(s)

    b := []byte(s)  // 标准转换
    pb := unsafe.SliceData(b)

    fmt.Printf("ps=%p pb=%p equal=%vn", ps, pb, ps == pb)
    // 输出:equal=false,证明指针地址不同
}
所以,标准转换的成本并不神秘,本质上就是为了维持语言层面的类型语义和安全边界。只要发生了复制,它就很难做到极低开销。
零拷贝转换是怎么做到的
既然标准方式要复制,零拷贝的核心思路就很直接:不复制数据,只复用原有底层内存,然后手动构造另一个视角的头部信息。
先看运行时层面的数据结构
string 和 []byte 在底层都可以理解为“头部 + 底层数据”的组合,只是切片比字符串多了一个容量字段:
type StringHeader struct {
    Data uintptr  // 指向底层字节数组的指针
    Len  int      // 字符串长度
}

type SliceHeader struct {
    Data uintptr  // 指向底层数组的指针
    Len  int      // 切片长度
    Cap  int      // 切片容量
}
因此,只要能安全地取得底层数据指针,再按目标类型需要的结构拼好头部,就能避免额外拷贝。
Go 1.20+ 的直接写法
在较新的 Go 版本里,可以借助 unsafe.StringData、unsafe.SliceData、unsafe.String 和 unsafe.Slice 完成转换。这种方式比早年的头部强转更直白,也更接近官方提供的底层能力:
import "unsafe"

// string到[]byte的零拷贝转换
func StringToBytes(s string) []byte {
    return unsafe.Slice(unsafe.StringData(s), len(s))
}

// []byte到string的零拷贝转换
func BytesToString(b []byte) string {
    return unsafe.String(unsafe.SliceData(b), len(b))
}
这里没有创建新数据区,转换结果只是复用了原始内存,因此速度会明显快于标准写法。
旧版本常见的兼容写法
如果项目还要兼容更老的 Go 版本,常见做法是借助 reflect.StringHeader 和 reflect.SliceHeader 来拼接结构:
import (
    "reflect"
    "unsafe"
)

func StringToBytes(s string) []byte {
    stringHeader := (*reflect.StringHeader)(unsafe.Pointer(&s))

    bh := reflect.SliceHeader{
        Data: stringHeader.Data,
        Len:  stringHeader.Len,
        Cap:  stringHeader.Len,
    }

    return *(*[]byte)(unsafe.Pointer(&bh))
}

func BytesToString(b []byte) string {
    sliceHeader := (*reflect.SliceHeader)(unsafe.Pointer(&b))

    sh := reflect.StringHeader{
        Data: sliceHeader.Data,
        Len:  sliceHeader.Len,
    }

    return *(*string)(unsafe.Pointer(&sh))
}
这类代码的本质一样,都是绕过常规转换路径,直接复用底层存储。不过它对运行时实现细节的依赖更强,可读性和可维护性也更差。
性能收益有多大,代价又是什么
从基准测试看,零拷贝的收益确实很夸张。在“转换后不修改内容”的前提下,示例数据给出的结果大约快了 30 倍:
场景:未修改转换后的内容
BenchmarkB2sForce-12      474078568    2.527 ns/op
BenchmarkB2sStandard-12    16626858   77.04 ns/op
原因并不复杂:零拷贝路径跳过了内存分配和数据复制,主要是在操作头结构;而标准转换需要申请新内存并完成内容搬运。
但性能收益越明显,越要先问一个更实际的问题:这部分收益是不是发生在真正的瓶颈上。如果只是普通业务代码里的零星转换,引入 unsafe 往往得不偿失。
真正需要警惕的风险边界
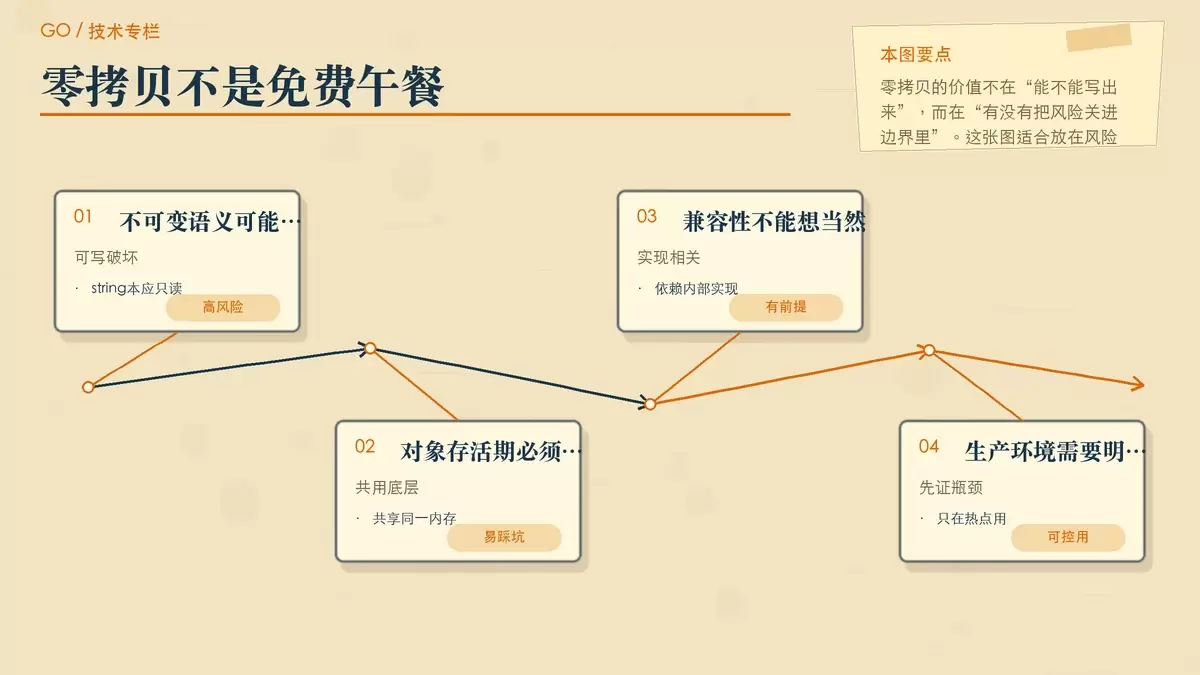
零拷贝转换之所以被称为“黑魔法”,不是因为它难写,而是因为它突破了 Go 原本为你兜底的类型和内存规则。
1. 可能破坏 string 的不可变语义
string 在语言层面是不可变的,但如果你把它零拷贝转成 []byte,得到的却是一个可以写入的视图。一旦后续代码修改了这些字节,等于直接破坏了原本应该只读的数据。
这类问题尤其麻烦,因为调用点表面上看不出来风险,真正出错时往往已经离转换位置很远。
2. 生命周期处理不当会带来内存安全问题
零拷贝转换共享的是同一块底层内存。如果原始 string 或 []byte 的生命周期判断失误,后续继续访问转换结果就可能落入未定义行为,严重时甚至触发崩溃。
这也是为什么这类技巧虽然能跑得快,但很难像普通语法那样放心交给团队大规模复用。
3. 对内部实现有依赖,兼容性并不稳
无论是 unsafe 直接转换,还是早期的 reflect.Header 写法,本质上都依赖 Go 的内部表示方式。只要运行时实现、编译器优化策略或相关 API 约束发生变化,旧技巧就可能失效,甚至留下隐蔽 bug。
因此,这种方案更适合少量、可审计、经过充分验证的热点路径,而不是广泛铺开。
生产环境里更稳妥的用法建议
如果确实确认了这里是性能热点,零拷贝不是不能用,但必须把约束写清楚、把边界守住。
比较实用的准则包括:
- 确保转换得到的
[]byte绝对不会被修改 - 只在性能瓶颈已经明确定位的场景使用
- 在代码旁写明使用原因、只读约束和风险说明
- 补足测试与代码审查,避免后续维护者误用
而在更多普通场景里,更值得优先考虑的是那些不破坏安全边界、但同样能减少分配的办法,例如:
// 对于字符串读取,使用strings.Reader
s := "large string data"
r := strings.NewReader(s) // 零拷贝
io.Copy(writer, r)

// 对于字符串构建,使用strings.Builder
var builder strings.Builder
builder.Grow(1024) // 预分配空间
builder.WriteString("prefix")
result := builder.String() // 仅一次分配
strings.Reader 适合把已有字符串按只读流方式交给下游处理,strings.Builder 则适合高频拼接字符串时减少中间分配。这类优化通常比引入 unsafe 更容易长期维护,也更符合大多数业务系统的演进方式。
该不该用,结论其实很明确
string 与 []byte 的零拷贝转换,确实能在特定场景下带来非常可观的性能提升,尤其是那些已经确认存在频繁互转、且每次拷贝都能被放大的热点路径。
但它同样会削弱 Go 原本提供的类型安全和可维护性。对大多数业务代码来说,标准转换仍然是默认选项;只有在性能瓶颈明确、只读约束可证明、团队能承担后续维护成本时,才值得谨慎引入零拷贝方案。真正成熟的优化,不是单纯追求更快,而是在收益、风险和工程可控性之间做出清醒取舍。









