


很多 Go 项目都会碰到同一类问题:现成能力在 C 库里,或者某段逻辑确实更适合继续用 C 实现,这时候完全重写往往并不划算。要把两边顺畅接起来,关键就是理解 cgo 的使用边界、调用方式,以及类型和内存该怎么处理,本文就按这三部分展开,帮助你快速判断什么时候该接、怎么接、有哪些坑要提前避开。
cgo 是 Go 与 C 之间的桥梁
Go 通过 cgo 提供与 C 代码交互的能力。它允许开发者在 Go 程序中直接调用 C 函数、使用 C 类型,或者链接已有的 C 语言库,让两种语言在同一个项目里协同工作。
在开始之前,先确认环境变量 CGO_ENABLED 已经开启,也就是设置为 1。这是 cgo 生效的前提条件;如果没有开启,相关代码即使能写出来,也不会按预期参与构建。
从工程角度看,cgo 适合解决两类问题:一类是复用成熟的 C 库,避免重复造轮子;另一类是在少量性能敏感路径中保留 C 实现。但它并不等于“Go 可以毫无代价地调用 C”,后文提到的调用开销、内存管理和平台差异,都是上线前必须评估的部分。
在 Go 中调用 C:嵌入代码与外部库两种做法
直接在 Go 文件里嵌入 C 代码
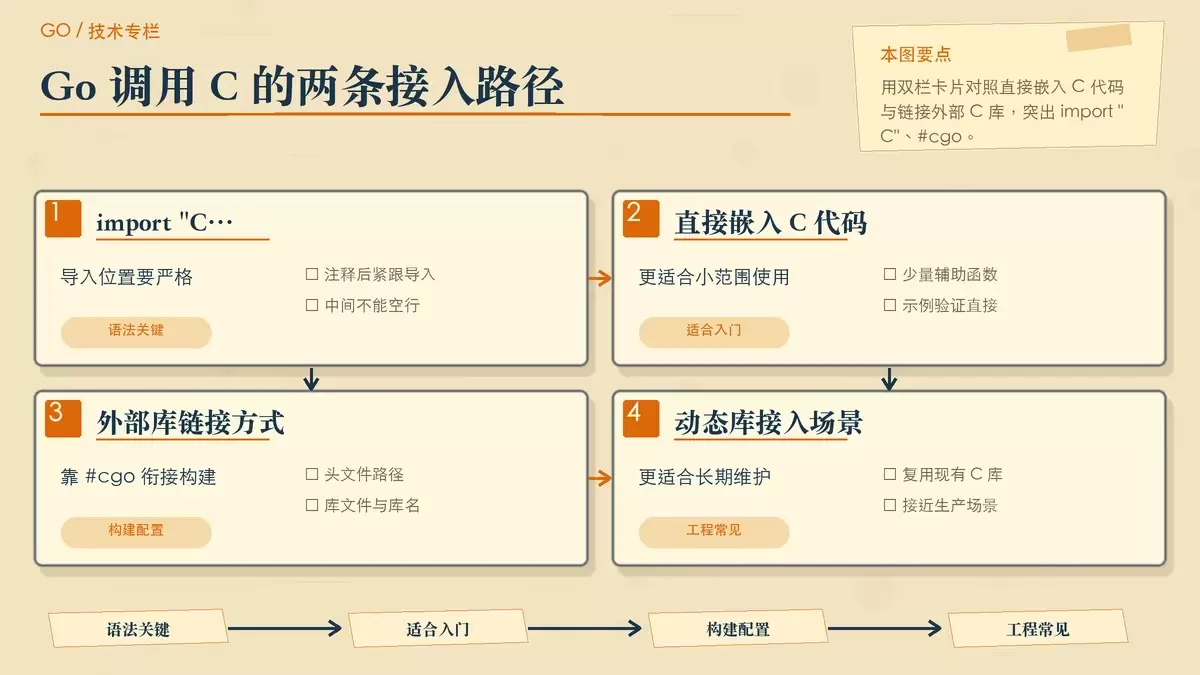
最简单的方式,是把 C 代码直接写在 Go 文件中的注释块里,再通过 import "C" 引入:
package main

/*
#include <stdio.h>

void sayHello() {
    printf("Hello from C!n");
}
*/
import "C"

func main() {
    C.sayHello()
}
这种方式适合示例、实验代码,或者少量非常简单的 C 辅助函数。这里有一个很容易踩的语法点:import "C" 必须紧跟在那段 C 注释之后,中间不能有空行,否则 cgo 无法正确识别。
从调用体验上看,这种写法几乎像是在直接访问一个 Go 包下的方法,调用形式是 C.xxx。但它本质上仍然是跨语言调用,构建链路和运行时约束都和纯 Go 不同,因此更适合小范围使用。
链接外部 C 动态库
如果项目里已经有独立的头文件和库文件,更常见的做法是通过 #cgo 指令告诉 Go 编译器如何找到这些依赖:
package main

/*
#cgo CFLAGS: -I.
#cgo LDFLAGS: -L. -lmath
#include "math.h"
*/
import "C"
import "fmt"

func main() {
    result := C.add(2, 3)
    fmt.Printf("Result: %dn", result)
}
这段代码里的重点不在 C.add(2, 3),而在前面的构建参数:
CFLAGS用于指定头文件路径。LDFLAGS用于指定库文件路径以及要链接的库名。
也就是说,cgo 不只是“让代码能调起来”,它还承担了把 Go 构建过程与 C 编译、链接过程衔接起来的职责。对于已有 C 项目接入 Go 来说,这通常是更实用、也更接近生产环境的方式。
如果你的团队需要长期维护这类混合项目,建议尽早把头文件位置、库文件命名、不同平台下的链接参数约定清楚,否则构建脚本很容易随着平台增多而变得混乱。
跨语言调用里最关键的一步:数据类型转换
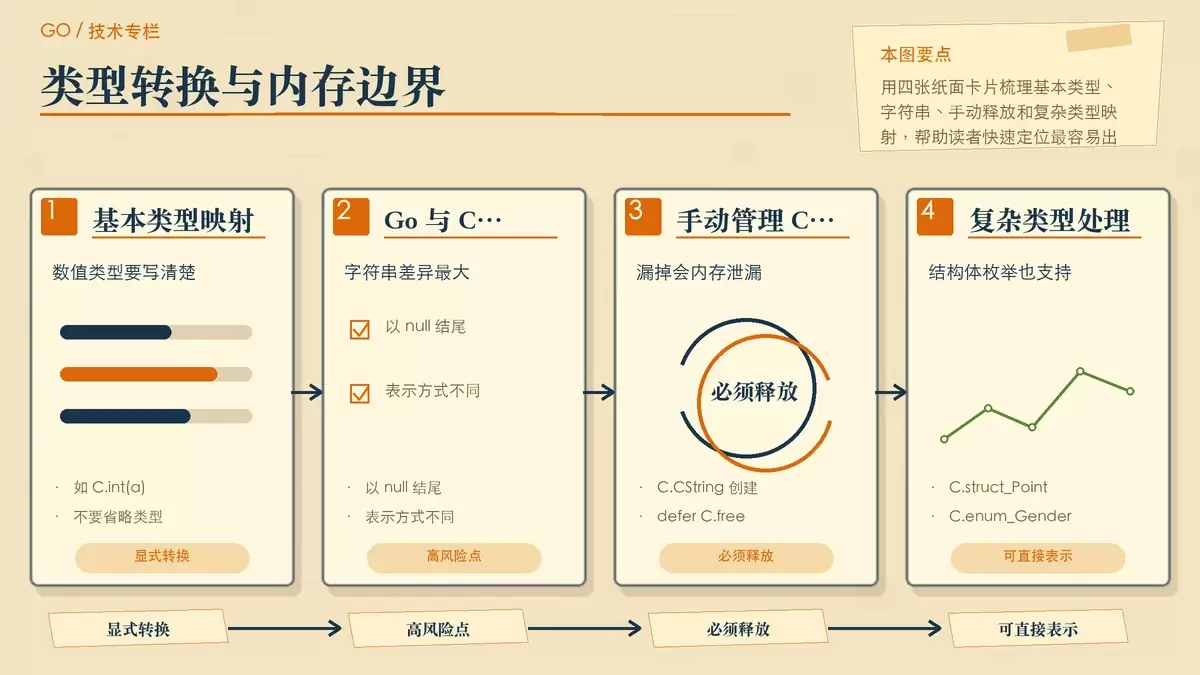
Go 和 C 的类型系统并不相同,所以函数能调用成功,并不代表数据一定能安全传递。实际开发里,类型转换往往比“能不能调起来”更值得花时间确认。
基本类型要显式转换
最常见的情况是数值类型转换。Go 里的 int 不能直接当成 C 的 int 用,通常需要显式写出转换:
var a int = 10
var b int = 20
// Go类型需要转换为C类型
sum := C.add(C.int(a), C.int(b))
cgo 提供了一组可直接使用的 C 类型映射,例如 C.char、C.int、C.float 等。这里的原则很简单:只要进入 C 调用边界,就尽量把类型写清楚,不要依赖隐式理解。
字符串转换要特别关注内存释放
字符串是最容易出问题的一类数据。原因在于,C 字符串本质上是以 null 结尾的字符数组,而 Go 的 string 是语言内建类型,两边的表示方式完全不同。
// Go字符串转C字符串
goStr := "Hello"
cStr := C.CString(goStr)
defer C.free(unsafe.Pointer(cStr)) // 必须手动释放内存

// C字符串转Go字符串
cStr := C.get_string()
goStr := C.GoString(cStr)
这里最重要的一点是:通过 C.CString 创建出来的 C 字符串,需要手动释放内存。也就是这句:
defer C.free(unsafe.Pointer(cStr))如果漏掉释放,问题不会像编译错误那样立刻暴露,而是会在运行过程中逐渐累积为内存泄漏。对于频繁调用的接口,这类问题尤其隐蔽。
相反,把 C 字符串转成 Go 字符串时,通常使用 C.GoString。这一步虽然更直接,但前提仍然是传入的 C 字符串本身有效、生命周期明确。
结构体和枚举也有对应表示
除了基本类型和字符串,cgo 也支持处理结构体、枚举等复杂类型:
// C结构体在Go中的表示
var point C.struct_Point = C.struct_Point{x: 1.0, y: 2.0}

// C枚举在Go中的表示
var gender C.enum_Gender = C.GenderMale
这说明 cgo 不只是做简单函数桥接,它还提供了对 C 数据结构的访问方式。实际使用时,重点不是语法本身,而是确保两边对字段、枚举值和内存布局的理解一致。只要接口涉及复杂结构,建议在设计阶段就把类型边界单独列清楚,而不是等到联调时再逐个排查。
反向调用:让 C 来调用 Go 函数
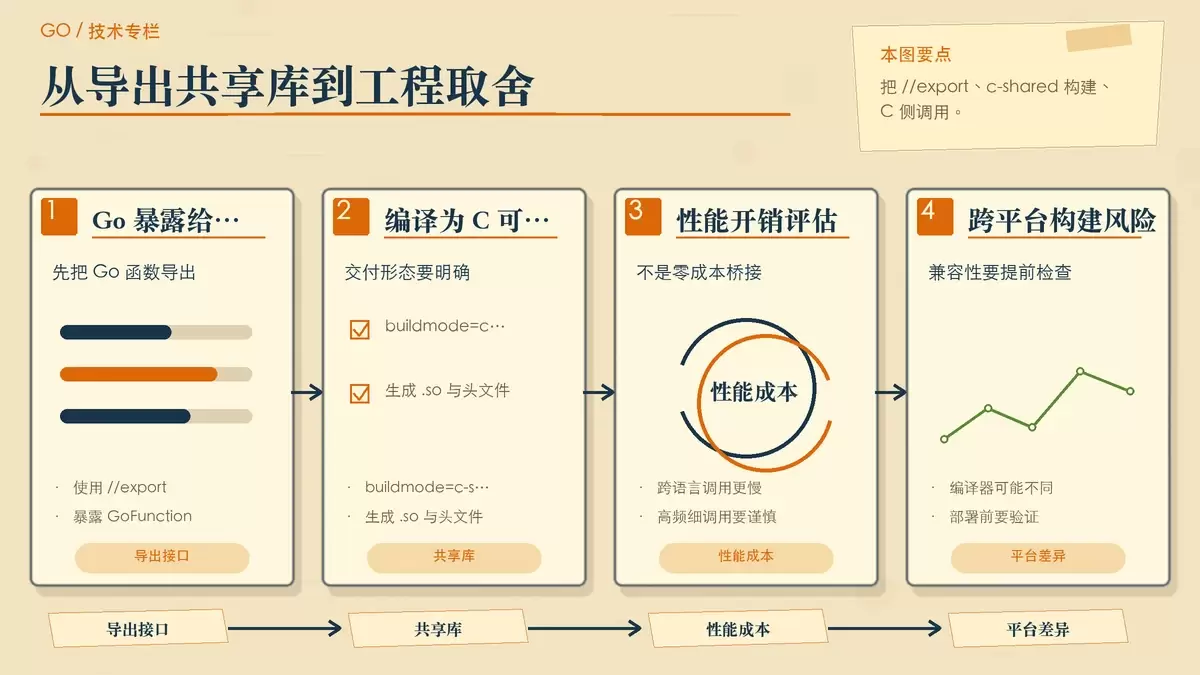
除了 Go 调 C,cgo 还支持反过来把 Go 函数导出给 C 使用。这一点经常被忽略,但在把 Go 作为动态库能力输出时很有价值。
做法是通过 //export 指令,把指定的 Go 函数暴露出去:
package main

import "C"

//export GoFunction
func GoFunction() {
    println("Hello from Go!")
}

func main() {}
接着把这段 Go 代码编译成 C 可调用的共享库:
go build -buildmode=c-shared -o awesome.so awesome.go构建完成后,C 侧可以通过生成的头文件来调用这个函数:
#include "awesome.h"

int main() {
    GoFunction(); // 调用Go函数
    return 0;
}
这样一来,Go 不再只是调用方,也可以成为被其他 C 程序复用的库。对于希望把 Go 的并发能力、业务封装或现有模块嵌入到老系统中的场景,这条路线很有现实意义。
不过要注意,导出共享库后,问题就不只是“代码能否运行”,还包括接口稳定性、部署方式以及目标环境是否能正确加载生成的 awesome.so。这类项目最好从一开始就把交付形态想清楚。
项目落地时要重点评估的 3 个问题
cgo 很好用,但它不是零成本的。真正进入项目后,至少有三个问题必须提前权衡。
1. 性能开销
cgo 调用本身会带来额外开销,通常会比普通 Go 函数调用更慢。如果只是偶尔调用一个重量级 C 能力,问题不大;但如果把高频、细粒度调用放到 cgo 边界上,整体收益可能会被调用成本抵消。
2. 内存管理
C 需要手动管理内存,Go 则依赖垃圾回收。两套机制并存时,最怕的是“双方都以为对方会处理”。字符串转换里的 C.CString 和 C.free 就是最典型的例子。跨语言传递指针、缓存对象或复杂结构时,更需要明确所有权和释放时机。
3. 跨平台兼容性
不同平台上的 C 编译器、链接器和库文件组织方式可能并不一致。开发环境能通过,不代表部署环境也能无缝通过。尤其是在 Linux、macOS、Windows 混合支持的情况下,构建参数和依赖分发策略都需要提前验证。
换句话说,cgo 适合解决“必须和 C 协作”的问题,但不适合为了炫技而引入。只要你能明确复用价值、接口边界和运行成本,它就是一条很实用的工程路径。
怎么判断项目该不该用 cgo
Go 通过 cgo 提供了完整的跨语言协作能力:可以直接嵌入 C 代码、链接外部 C 库,也可以通过 //export 把 Go 编译成 C 可调用的共享库。这让 Go 项目能够复用已有 C 生态,而不必把所有能力都重写一遍。
真正的判断标准在于两点:一是这段 C 能力是否值得接入,二是团队是否能控制好类型转换、内存释放和构建兼容性。如果答案是肯定的,cgo 会是非常直接的桥梁;如果只是为了少量非关键逻辑而引入,它带来的复杂度可能会超过收益。









