


Go 函数经常同时返回结果和 error,写得久了,很多人都会遇到一个问题:返回值本身没错,但函数签名不够直观,读代码时还得倒回函数体确认每个值代表什么。命名返回值就是为这类场景准备的,它既能把返回意图直接写进签名,也能在 defer 和统一错误处理里减少重复。下面从语法、典型用法和注意事项三部分展开,帮助你判断它是否值得放进日常 Go 编码习惯里。
命名返回值到底是什么
命名返回值是 Go 的一个语言特性,允许你在函数签名里直接给返回值命名。这样一来,这些返回值在函数体内部会被当作局部变量使用,可以直接赋值,也可以在最后用裸 return 返回。
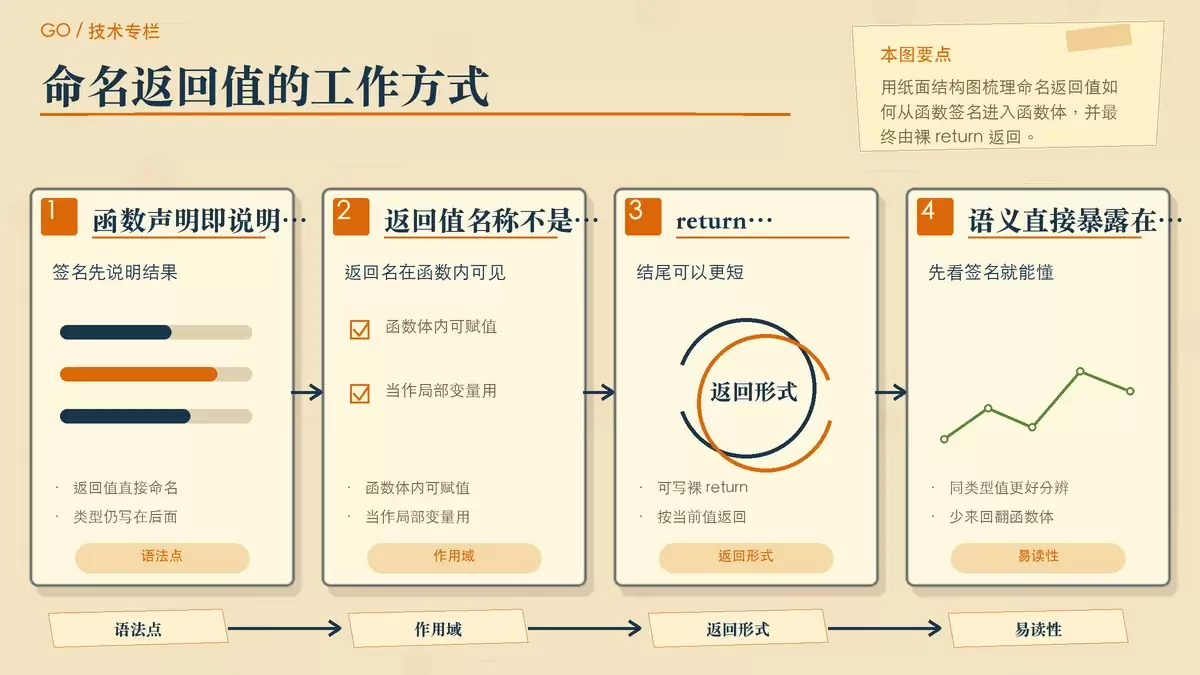
基本语法如下:
func 函数名(参数列表) (返回值1 类型1, 返回值2 类型2, ...) {
    // 函数体
    return // 可省略具体返回值
}
看一个计算商和余数的例子会更直观:
func divide(a, b int) (quotient int, remainder int) {
    quotient = a / b
    remainder = a % b
    return // 自动返回quotient和remainder
}
这一写法和普通多返回值函数的行为并没有本质区别,差别在于:函数签名已经把“返回的到底是什么”写明白了。特别是在返回值类型相同的时候,像这里的两个 int,命名后会明显更好认。
如果改成匿名返回值,调用者仍然能正常使用,但阅读者需要额外理解“第一个 int 是商,第二个 int 是余数”。命名返回值把这层解释前移到了函数声明处,减少了读代码时来回跳转的成本。
它为什么能让代码更清楚
返回含义直接写在函数签名里
命名返回值最直接的价值就是可读性。看到类似 (result int, err error) 的签名时,读者不用进入函数体,已经知道返回结构是什么。这一点在公共函数、工具函数和接口实现里尤其有用。
对于团队协作来说,这种“自解释”效果接近一段很短但一直有效的文档。尤其当函数返回两个以上值,或者返回值中包含多个相同类型时,命名可以显著降低误读概率。
return 语句可以更简短
一旦返回值有了名字,函数体里可以直接给这些变量赋值,结束时只写一个 return。在逻辑分支较多的函数中,这能减少重复书写。
比如有的函数里会经历参数检查、数据处理、错误包装和最终赋值多个阶段,如果每个出口都显式写一遍返回变量,代码会显得有些啰嗦。命名返回值能让这类函数在结构上更紧凑。
不过这里有一个判断标准:如果函数很短、返回逻辑也很简单,裸 return 不一定更清晰。简化语法不等于提升可读性,关键还是看读者能不能一眼看懂。
defer 可以直接访问并调整返回值
这也是命名返回值最常被拿来讨论的场景。因为返回值在函数体里就是可见变量,所以 defer 闭包可以读取它们,必要时还可以做进一步处理。
func withLogging() (result int, err error) {
    defer func() {
        if err != nil {
            log.Printf("Error: %v", err)
        }
    }()
    // 函数主要逻辑
    return
}这个例子里,defer 在函数返回前执行,因此能够拿到最终的 err 值。对日志记录、统计失败次数、补充上下文信息这类需求来说,这种写法很顺手,也符合 Go 常见的错误处理思路。
哪些场景最适合使用
错误处理是最常见的落点
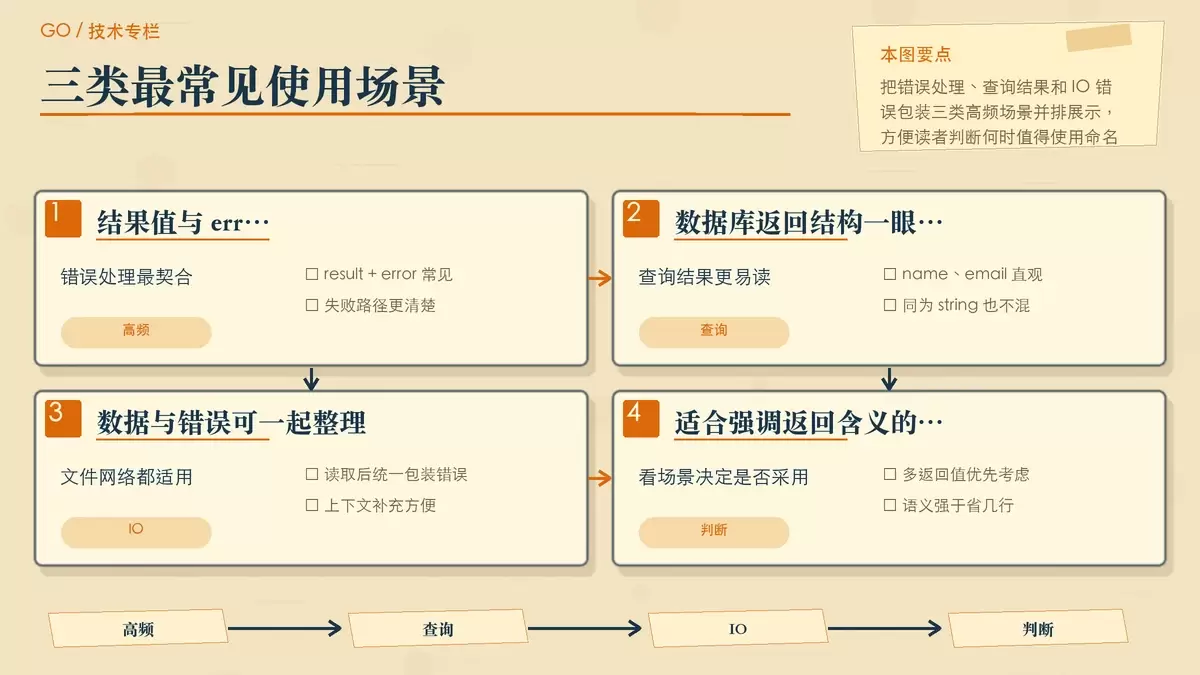
Go 没有异常机制,很多函数都遵循“结果值 + error”的模式。命名返回值和这一模式天然契合,因为它能把“正常结果”和“错误信息”明确地区分出来。
func safeDivide(a, b int) (result int, err error) {
    if b == 0 {
        err = fmt.Errorf("除数不能为0")
        return
    }
    result = a / b
    return
}这个函数的好处不只是少写了几次变量名,更重要的是逻辑表达很清楚:result 代表成功路径的值,err 代表失败路径的信息。即使以后再加日志、监控或错误包装,结构也不会太乱。
数据库查询里更容易看懂返回结构
数据库操作经常会一次返回多个字段,再附带一个 error。如果函数签名只写类型,不写名字,阅读成本会明显上升。命名返回值能把查询结果的语义直接放在签名中。
func queryUser(id int) (name string, email string, err error) {
    // 数据库查询逻辑
    // ...
    return
}
像 name string、email string 这样的命名,虽然看起来简单,但比单纯写两个 string 清楚得多。对调用方、维护者和后续重构都更友好。
文件与网络 IO 适合做统一错误包装
文件操作、网络请求等 IO 场景里,函数通常需要返回数据和错误,而且错误往往要补充上下文。命名返回值在这里的优势是:可以在主逻辑完成后,再对 err 做一次统一整理。
func readFileContent(filePath string) (content []byte, err error) {
    content, err = ioutil.ReadFile(filePath)
    if err != nil {
        err = fmt.Errorf("文件读取失败: %v", err)
    }
    return
}
这种写法把“拿数据”和“修饰错误信息”放在同一个函数内完成,代码比较整洁。尤其当你需要对不同底层错误补充业务上下文时,命名返回值能让错误变量始终保持可见、可修改。
使用时要注意的边界
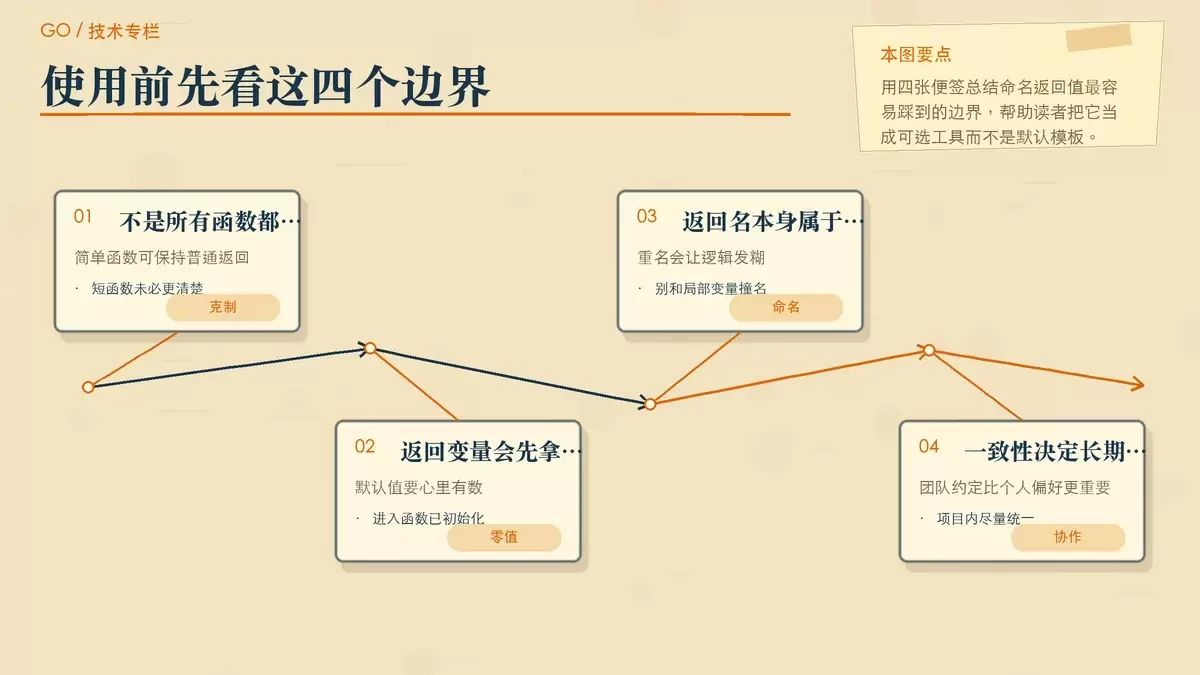
命名返回值很实用,但并不意味着所有函数都应该改成这种风格。下面几条边界,基本决定了它是帮忙还是添乱。
简单函数不要为了特性而特性
如果函数只有一两行、返回关系也非常直接,匿名返回值往往更自然。命名返回值真正适合的是“返回值语义需要强调”或“函数内要多次处理返回变量”的场景,而不是所有多返回值函数。
要记住它们会自动初始化为零值
命名返回值在进入函数时就已经存在,并且会先被赋予零值。也就是说,int 默认是 0,string 默认是空字符串,切片、指针、接口等则是 nil。这让函数在某些分支中可以直接 return,但也要求你清楚自己是不是有意返回这些零值。
如果对零值语义没有把握,或者函数存在很多分支,最好把每个分支的赋值过程写得更明确一些,避免让“默认值”掩盖逻辑问题。
避免和局部变量重名
因为命名返回值本身就是函数作用域内的局部变量,所以在函数体内再声明同名变量会造成冲突,或者至少让代码变得难读。尤其在较长函数里,局部变量和返回变量命名混在一起,很容易让人误判某次赋值到底影响的是中间状态还是最终返回结果。
一个实用做法是:返回值名称保持稳定、偏结果导向;中间过程变量则用更具体的名字区分职责。
项目内部最好统一风格
命名返回值不是越多越好,而是要用得一致。如果同一项目里有的包大量使用裸 return,有的包完全不用,阅读体验会很割裂。团队最好约定一个简单标准,比如只在以下情况使用:返回值超过一个、含有多个同类型值、或需要在 defer 中处理返回结果。
这样既能保留它的优势,也能避免风格漂移。
怎么判断该不该用
可以用一个很务实的标准来判断:如果函数签名在命名后能明显降低理解成本,或者函数内部确实需要围绕返回值做统一处理,那么命名返回值通常值得用。反过来,如果它只是把原本简单的返回变成了“需要读者额外记住变量名”的形式,那就没必要。
总结下来,Go 的命名返回值适合这几类问题:
- 返回多个值,而且其中有相同类型,容易混淆
- 函数遵循
result + error模式,希望签名更自解释 - 需要在
defer中读取、记录或调整返回值 - 希望减少重复的
return x, y, err书写
它不是炫技特性,也不是必须使用的 Go 语法糖。真正的价值在于:让函数对人更友好,让返回约定更容易被一眼看懂。对于多返回值函数,尤其是错误处理密集的代码,这一点往往比少写几行更重要。









