


在 Go 里,多重赋值经常出现在变量交换、value, err 错误处理、range 遍历这些高频场景里,写法简短,却不只是“少打一行代码”这么简单。真正决定它是否安全、是否适合使用的,是右侧表达式何时求值、左侧目标何时写入,以及在复杂下标或状态更新中会不会引入误判。本文按“能做什么、为什么安全、哪些地方容易踩坑”的顺序拆开说明,帮助你判断什么时候该直接用,什么时候该拆开写。
多重赋值到底解决了什么问题
Go 的多重赋值允许你在一条语句里同时给多个变量赋值。基本形式很直接:左侧放多个变量,右侧放多个表达式,数量一一对应。
// 基本的多重赋值
x, y := 10, 20
fmt.Printf("初始值: x = %d, y = %dn", x, y)

// 重新赋值
x, y = 30, 40
fmt.Printf("重新赋值后: x = %d, y = %dn", x, y)
这类写法的价值首先在于表达意图。与其把几次彼此关联的赋值拆开,不如让读代码的人一眼看到“这些值是同时更新的”。在 Go 里,这种表达方式还不是边角语法,而是很多惯用写法的基础。
最典型的例子就是变量交换。传统写法通常要引入一个临时变量:
// 传统变量交换方式
var a int = 10
var b int = 20

// 引入临时变量进行交换
tmp := a
a = b
b = tmp
它当然能工作,但问题也很明显:步骤更多,意图分散,还容易在复杂逻辑里夹杂额外操作。用多重赋值时,交换可以压缩成一句:
// Go语言多重赋值进行变量交换
var a int = 10
var b int = 20
a, b = b, a // 交换a和b的值
这里的重点不只是“更短”,而是“更清楚”。看到 a, b = b, a,读者几乎不需要再追踪中间过程,就能确认这是一组对称交换。
为什么它能安全交换:先求值,再赋值
多重赋值之所以在交换场景里可靠,关键在于 Go 的执行规则:赋值号右侧的表达式会先被完整求值,然后才进行左侧写入。
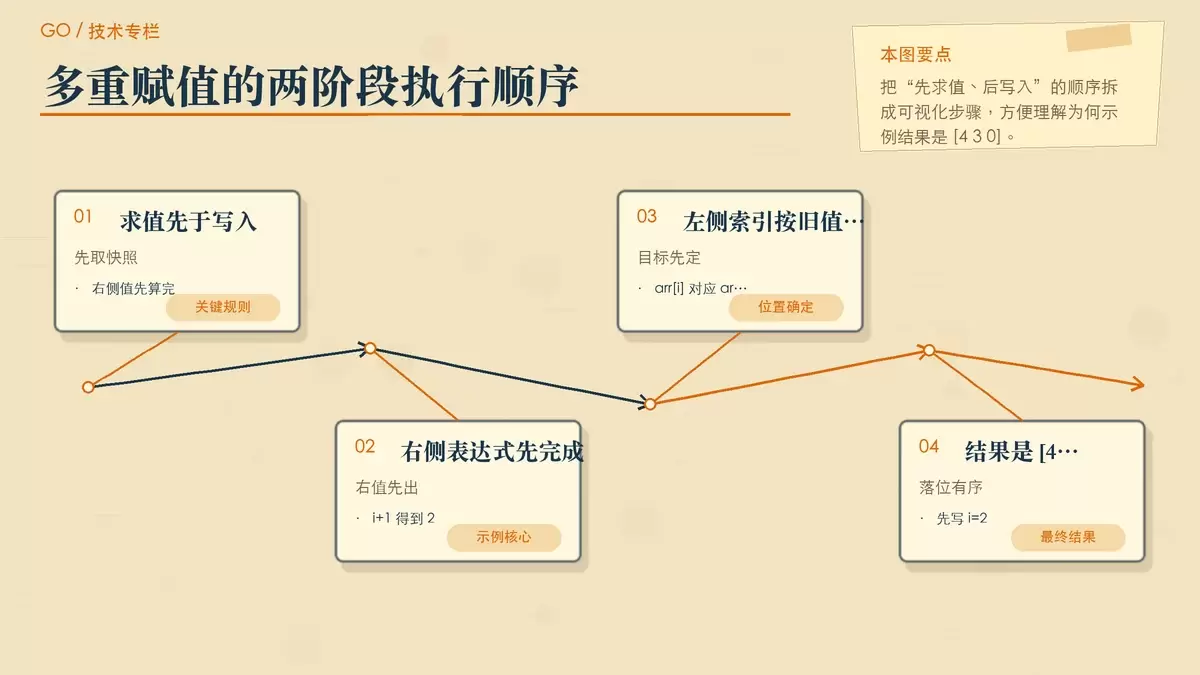
也就是说,在 a, b = b, a 中,编译器会先拿到右侧两个值的“当前快照”,再把它们依次写回左侧位置。不会出现“先把 a 改了,导致后面的 b 读错值”这种中间态干扰。
这个规则在简单交换时看起来理所当然,到了涉及索引、切片或多个写入目标时就尤其重要。看下面这个例子:
func main() {
    i := 1
    arr := []int{0, 0, 0}
    i, arr[i], arr[i-1] = i+1, i+2, i+3
    fmt.Println(arr) // [4 3 0]
}
结果为什么是 [4 3 0],而不是很多人第一眼猜到的别的值?可以拆成两个阶段理解。
求值阶段先确定右值和目标位置
i+1 = 2i+2 = 3i+3 = 4- 同时,左侧里带索引的目标也按当时的
i来确定:arr[i] -> arr[1],arr[i-1] -> arr[0]
赋值阶段再按顺序写入
i = 2arr[1] = 3arr[0] = 4
因此最终得到 [4 3 0]。真正该记住的是:arr[i] 里的索引是在赋值前就确定好的,后续 i 被改成 2,并不会倒过来影响已经解析过的目标位置。
这也是多重赋值既强大又容易被误解的地方。它不是“看起来像同时发生”,而是有一套明确的求值与落位顺序。理解这一点,很多表面上的“陷阱”其实都能解释清楚。
Go 里最常见的几类用法
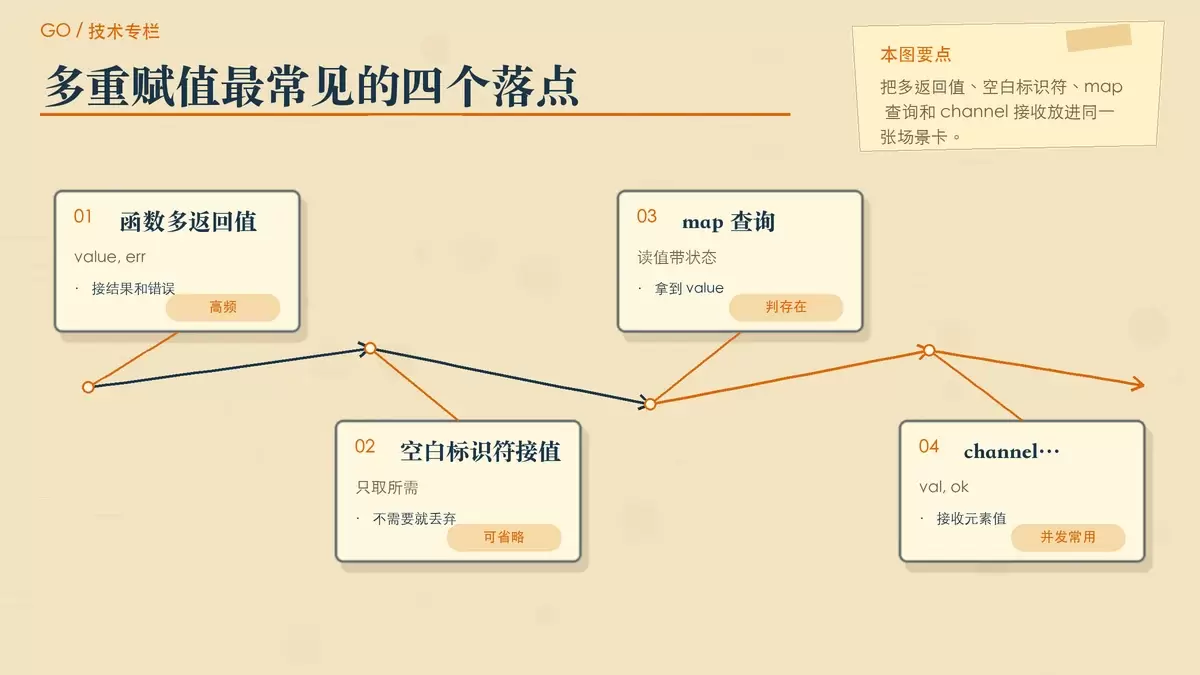
除了变量交换,多重赋值还是 Go 日常编码中的常规工具,很多标准写法都建立在它之上。
函数多返回值
Go 函数可以返回多个值,多重赋值就是接收这些结果的标准方式,尤其常见于错误处理。
func divide(numerator, denominator int) (int, error) {
    if denominator == 0 {
        return 0, fmt.Errorf("cannot divide by zero")
    }
    return numerator / denominator, nil
}

// 调用函数并接收多个返回值
result, err := divide(10, 2)
if err != nil {
    fmt.Println("Error:", err)
} else {
    fmt.Println("Result:", result) // Output: Result: 5
}
result, err := ... 这套模式几乎就是 Go 错误处理的基本语法单元。读者看到这种结构,就会自然预期接下来会有 if err != nil 分支。
用空白标识符忽略不需要的返回值
如果函数返回多个结果,但你只关心其中一部分,可以直接用 _ 丢弃其余值,让代码意图更直接。
func getCoordinates() (int, int, string) {
    return 10, 20, "North"
}

func main() {
    // 只关心x坐标和描述,忽略y坐标
    x, _, direction := getCoordinates()
    fmt.Printf("X坐标: %d, 方向: %sn", x, direction)

    // 只关心y坐标
    _, y, _ := getCoordinates()
    fmt.Printf("Y坐标: %dn", y)
}
相比先接全部结果、再忽略一部分,这样写更符合 Go 倡导的明确表达。
for ... range 遍历时接收索引和值
这可能是很多人接触最多重赋值的地方。range 返回的索引和值,通常就是成对接收的。
func main() {
    numbers := []int{1, 2, 3, 4, 5}
    for index, value := range numbers {
        fmt.Printf("索引: %d, 值: %dn", index, value)
    }
}
如果只需要其中一个,也可以配合 _ 使用,避免产生不必要的变量。
从 map 里同时拿值和存在性
Go 读取映射时,经常不是只拿值,还要顺手确认键是否存在。这也是一个非常标准的“双返回值”场景。
m := map[string]int{"apple": 1, "banana": 2}
value, ok := m["apple"]
if ok {
    fmt.Println("Apple exists, value:", value) // Output: Apple exists, value: 1
}
value, ok 的价值在于把“读取结果”和“有效性判断”放在一个动作里完成,避免把零值和真实值混为一谈。
从 channel 接收值并判断状态
通道读取同样支持多重赋值,可以同时获得元素值和通道是否仍然可读的状态。
ch := make(chan int, 1)
ch <- 10
val, ok := <-ch // 从通道接收值,并检查通道是否关闭
if ok {
    fmt.Println("Received:", val) // Output: Received: 10
}
在并发代码里,这种写法很常见,因为它把数据读取和状态判断绑定在了一起,读法统一,也更不容易漏判断。
容易踩坑的地方与更稳妥的写法
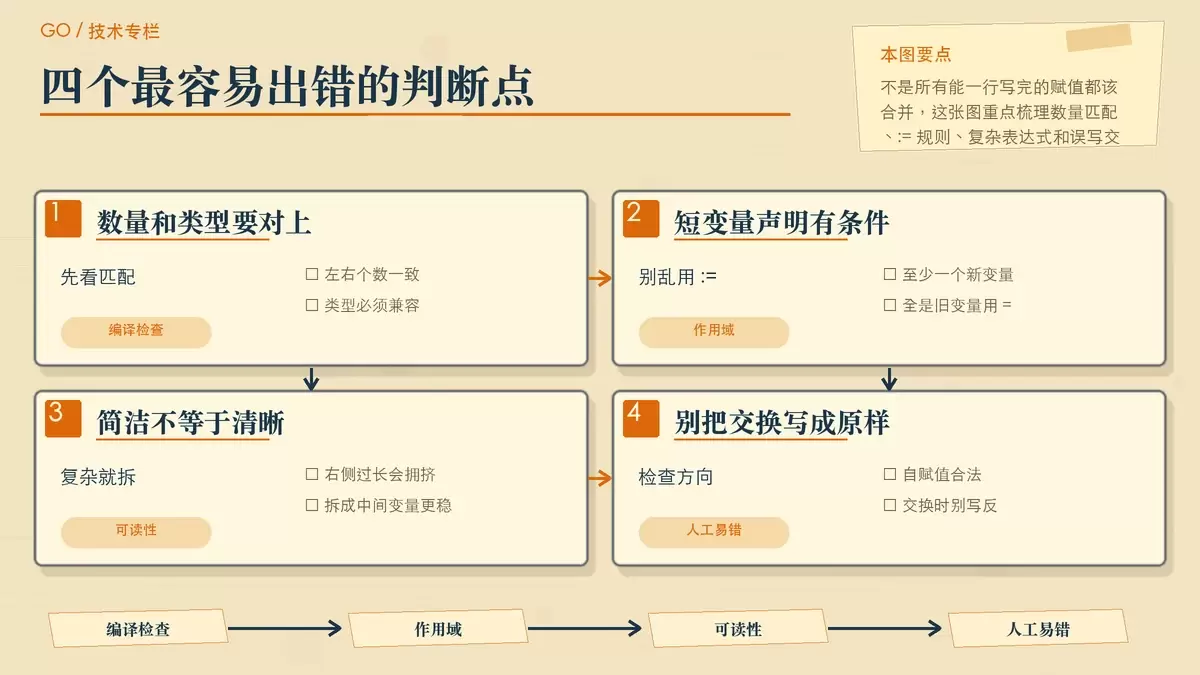
多重赋值虽然简洁,但它不是“越多越好”。真正影响代码质量的,通常是边界规则和可读性控制。
左右两侧数量必须对应,类型也要兼容
左侧变量的个数必须和右侧表达式个数一致,类型也要能正确赋值。这个约束很严格,没有模糊空间。
// 正确
x, y := 1, "hello"

// 错误:数量不匹配
x, y := 1, 2, 3

// 错误:类型不兼容
var x int
var y string
x, y = 1, 2 // 错误:2不能赋值给string类型变量
这类问题通常编译期就会报错,所以不算隐蔽;真正容易让人犹豫的,往往是 := 的使用规则。
短变量声明 := 不是任何时候都能用
在多重赋值里,:= 既承担赋值,也承担声明,因此需要区分当前名字是“新变量”还是“已有变量”。
- 如果左侧变量全是新名字,可以使用
:= - 如果左侧名字都已经声明过,就应使用
= - 如果是新旧混合,只要至少有一个新变量,也可以使用
:=
var x int = 10
y, z := 20, 30 // y和z是新声明的
x, y = y, x // x和y都是已声明的
这条规则如果没弄清楚,最常见的后果不是逻辑错,而是作用域和变量遮蔽问题。尤其在 if、for 等局部语句里,写成 := 后可能不小心引入了新变量,导致你以为在更新外层值,实际却只是改了一个内层副本。
表达式太复杂时,拆开反而更清楚
多重赋值的优势在于把“有关联的更新”放在一起,但如果右侧每一项本身都很复杂,强行写成一行,反而会让人很难快速判断每个值的来源。
// 可读性较差
a, b, c, d = w+x, y*z, getComplexValue(), anotherComplexFunction()

// 更清晰的做法
value1 := w + x
value2 := y * z
value3 := getComplexValue()
value4 := anotherComplexFunction()
a, b, c, d = value1, value2, value3, value4
这里的判断标准很简单:如果读者需要停下来逐项拆右侧表达式,那就说明这条赋值已经不够顺。多写几行并不丢人,尤其在业务代码里,可维护性通常比“语法上更短”更重要。
别把自赋值误当成交换
a, b = a, b 并不是语法错误,它只是一次合法的自赋值,执行后两个变量保持原值不变。真正的问题在于,开发者有时本来想交换,结果手滑写成了这句。
因此,遇到交换逻辑时,最好直接检查目标语句是否真的写成了 a, b = b, a。这类错误编译器不会帮你拦下,只能靠代码审查或测试发现。
性能取舍与实际代码里的典型场景
从日常使用看,多重赋值通常已经是 Go 里兼顾简洁与效率的默认选择。编译器对这种模式有较成熟的处理,简单交换场景下通常不需要为了性能退回到“手动临时变量”写法。
原始几种方式可以这样理解:
| 方法 | 应用场景 | 优点 | 缺点 |
|---|---|---|---|
| 临时变量 | 基本的值交换操作 | 简单易懂 | 需要额外的临时变量 |
| 多重赋值 | 多变量值交换 | 简洁高效,编译器优化 | 仅适用于简单的变量交换 |
| 切片操作 | 数组或切片的数据交换 | 方便处理批量数据 | 仅适用于数组或切片 |
| 函数封装 | 需要多次调用的交换操作 | 提高代码可读性和复用性 | 函数调用有一定的开销 |
不过,性能不是唯一标准。更实际的判断应该是:这次赋值是否能明显传达“这些值属于同一次更新”。如果答案是肯定的,多重赋值往往就值得用。
排序代码里的元素交换
排序算法是最经典的落地场景之一。交换相邻元素时,多重赋值能让代码保持非常紧凑。
// 冒泡排序中的交换操作
func bubbleSort(arr []int) {
    n := len(arr)
    for i := 0; i < n-1; i++ {
        for j := 0; j < n-i-1; j++ {
            if arr[j] > arr[j+1] {
                // 使用多重赋值交换元素
                arr[j], arr[j+1] = arr[j+1], arr[j]
            }
        }
    }
}
这里如果改成临时变量写法,逻辑当然不变,但会让循环内部的视觉噪声更大,真正的比较条件反而不够突出。
受保护状态的成组更新
在并发代码里,多重赋值并不会自动替代锁,也不意味着天然线程安全,但在已经持有锁的前提下,它很适合表达“多个状态在同一个临界区内一起更新”。
type Counter struct {
    mu    sync.Mutex
    count1 int
    count2 int
}

func (c *Counter) IncrementBoth() {
    c.mu.Lock()
    defer c.mu.Unlock()
    c.count1, c.count2 = c.count1+1, c.count2+1
}这段代码真正传达的信息是:count1 和 count2 属于同一批次变化。锁负责并发安全,多重赋值负责把“成组更新”写得更直观。
归纳起来,Go 的多重赋值最适合三类场景:一是交换,二是接收一组天然关联的返回值,三是在同一处表达成组状态变化。只要右侧表达式不过度复杂,使用它通常能让代码更贴近 Go 的惯用风格,也更容易被团队成员快速读懂。









