


写 Go 代码时,性能问题往往不是靠直觉能判断出来的:一个函数到底够不够快、两种实现谁更省资源、内存分配是否合理,都需要用可重复的数据来回答。Go 自带的 benchmark 机制正好解决这件事,本文会从最基础的编写规则讲到结果解读、常见误区、实战对比以及持续监控,帮助你把“感觉优化”变成“证据优化”。
什么是 Go 基准测试,和单元测试有什么不同
基准测试(Benchmark)是专门用来衡量代码性能的测试方式。在 Go 里,它主要关注两类指标:执行时间,以及执行过程中产生的内存分配。和关注“结果对不对”的单元测试不同,基准测试更关心“跑得快不快、代价高不高”。
Go 标准库已经内置了完整的基准测试框架,因此不需要额外引入工具,就可以对函数、方法甚至并发逻辑做量化评估。这也是性能优化能否成立的前提:先测量,再决定要不要改。
编写基准测试要满足的基本规则
Go 的 benchmark 写法比较固定,通常需要满足以下规则:
- 测试文件必须以
_test.go结尾 - 基准测试函数必须以
Benchmark开头 - 函数参数必须是
*testing.B - 被测逻辑通常放在
for i := 0; i < b.N; i++循环中执行
其中,b.N 不是手动指定的固定次数,而是测试框架为了获得稳定结果自动调整出来的迭代次数。也就是说,你只需要把被测代码写对位置,Go 会帮你尽量把统计做准。
下面是一段最基本的示例:
// fib.go
package main

func fib(n int) int {
    if n == 0 || n == 1 {
        return n
    }
    return fib(n-2) + fib(n-1)
}

// fib_test.go
package main

import "testing"

func BenchmarkFib(b *testing.B) {
    for n := 0; n < b.N; n++ {
        fib(30) // 运行fib(30) b.N次
    }
}
这段代码的重点很明确:不要把测试逻辑写散,也不要把真正要衡量的代码放在循环外。否则跑出来的数据很可能没有参考价值。
如何运行基准测试,并正确读懂输出结果
常用命令参数
运行 benchmark 的入口仍然是 go test,只是需要加上 -bench 参数:
# 运行所有基准测试
go test -bench .

# 运行特定模式的基准测试
go test -bench='Fib$'

# 显示内存分配信息
go test -bench . -benchmem

# 设置测试时间为5秒
go test -bench='Fib$' -benchtime=5s

# 运行3轮测试取平均值
go test -bench='Fib$' -benchtime=5s -count=3
这几个参数里,最常用的是 -benchmem。很多时候性能问题并不只是“慢”,而是“分配太多”。如果只看耗时,很容易漏掉真正的瓶颈来源。
-benchtime 和 -count 则更适合在你需要稳定结果时使用,尤其是准备比较两种实现差异、或者打算把数据放进 CI 时,单次结果通常不够稳。
一行 benchmark 输出该怎么看
运行后,你通常会看到类似这样的结果:
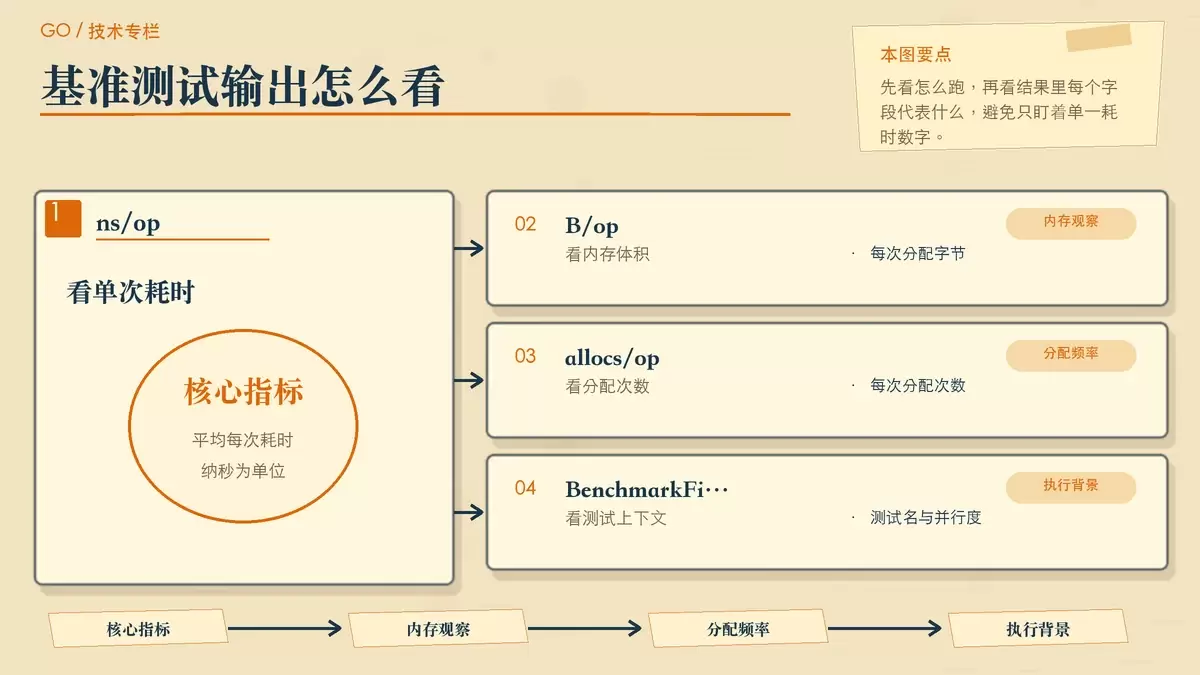
BenchmarkFib-8 200 5865240 ns/op 0 B/op 0 allocs/op这行输出可以拆成几部分理解:
- BenchmarkFib-8:基准测试名,以及当时的
GOMAXPROCS值 - 200:本次测试实际执行的迭代次数
- 5865240 ns/op:每次操作平均耗时,单位是纳秒
- 0 B/op:每次操作平均分配的内存字节数
- 0 allocs/op:每次操作平均发生的内存分配次数
实际判断时,可以遵循一个简单顺序:先看 ns/op 判断速度,再看 B/op 和 allocs/op 判断内存代价。如果某个实现耗时差不多,但分配次数明显更高,那么它在高频场景里往往还是更差的选择。
另外,单次 benchmark 数字不应该被当成绝对真理。它更适合做“同环境、同条件下的对比”,而不是跨机器、跨时间直接比较。
想让数据可信,基准测试要这样写
用计时器排除准备阶段干扰
很多测试都不只是“执行函数”这么简单,前面可能还有初始化、造数据、连接资源等准备动作。如果这些步骤也被算进耗时,结果就会偏离真正想测的目标。Go 为此提供了计时器控制接口。
如果准备工作只发生一次,可以在完成初始化后重置计时器:
func BenchmarkFibWithSetup(b *testing.B) {
    // 模拟耗时准备工作
    time.Sleep(time.Second * 2)
    b.ResetTimer() // 重置计时器

    for n := 0; n < b.N; n++ {
        fib(30)
    }
}
如果每次迭代前后都需要生成或清理数据,就可以在准备阶段暂停计时,只测核心逻辑:
func BenchmarkBubbleSort(b *testing.B) {
    for n := 0; n < b.N; n++ {
        b.StopTimer() // 暂停计时
        nums := generateWithCap(10000) // 生成测试数据
        b.StartTimer() // 开始计时
        bubbleSort(nums) // 只测量排序时间
    }
}
这一步非常关键。很多“优化有效”的结论,最后被推翻,问题就出在测试把准备成本和核心成本混在了一起。
不要只测一种输入规模
性能通常会随着输入规模变化而变化。一个函数在 1000 条数据上表现正常,不代表到了 100000 条时仍然可接受。因此更稳妥的做法,是按不同规模分别写 benchmark。
func benchmarkGenerate(i int, b *testing.B) {
    for n := 0; n < b.N; n++ {
        generate(i)
    }
}

func BenchmarkGenerate1000(b *testing.B)   { benchmarkGenerate(1000, b) }
func BenchmarkGenerate10000(b *testing.B)  { benchmarkGenerate(10000, b) }
func BenchmarkGenerate100000(b *testing.B) { benchmarkGenerate(100000, b) }
这样做的好处是,你可以更清楚地看到算法或实现方式在不同负载下的变化趋势,而不是被单一规模的结果误导。
用子基准测试组织一组场景
从 Go 1.7+ 开始,子基准测试可以把一组输入场景组织在同一个 benchmark 入口下,结构会更清晰,也更方便批量对比:
func BenchmarkFibonacci(b *testing.B) {
    benchmarks := []struct{
        name string
        n    int
    }{
        {"Fibonacci 5", 5},
        {"Fibonacci 10", 10},
        {"Fibonacci 20", 20},
    }

    for _, bm := range benchmarks {
        b.Run(bm.name, func(b *testing.B) {
            for i := 0; i < b.N; i++ {
                Fibonacci(bm.n)
            }
        })
    }
}
这类写法适合参数化场景,比如不同长度、不同容量、不同并发数。相比把函数拆成很多独立 benchmark,它更适合维护,也更利于统一观察输出。
并发代码要用并行基准测试
如果要衡量的是并发逻辑,普通的串行循环并不能反映真实情况。这时应使用并行基准测试:
func BenchmarkParallel(b *testing.B) {
    b.RunParallel(func(pb *testing.PB) {
        for pb.Next() {
            Fibonacci(10)
        }
    })
}
b.RunParallel 会按 benchmark 框架的方式调度多个 goroutine 并发执行,更适合评估并发访问下的吞吐能力和资源竞争情况。
实战:四种字符串拼接方式,谁更适合高频场景
基准测试最有价值的地方,在于它能把“经验判断”变成“可比较的数据”。字符串拼接就是一个非常典型的例子:看起来都能完成任务,但实际开销可能差很多。
下面这段代码比较了四种常见写法:
package main

import (
    "bytes"
    "fmt"
    "strings"
    "testing"
)

func plusConcat(n int, str string) string {
    s := ""
    for i := 0; i < n; i++ {
        s += str
    }
    return s
}

func sprintfConcat(n int, str string) string {
    s := ""
    for i := 0; i < n; i++ {
        s = fmt.Sprintf("%s%s", s, str)
    }
    return s
}

func builderConcat(n int, str string) string {
    var builder strings.Builder
    for i := 0; i < n; i++ {
        builder.WriteString(str)
    }
    return builder.String()
}

func bufferConcat(n int, str string) string {
    buf := new(bytes.Buffer)
    for i := 0; i < n; i++ {
        buf.WriteString(str)
    }
    return buf.String()
}

func benchmark(b *testing.B, f func(int, string) string) {
    for n := 0; n < b.N; n++ {
        f(100, "s")
    }
}

func BenchmarkPlusConcat(b *testing.B)    { benchmark(b, plusConcat) }
func BenchmarkSprintfConcat(b *testing.B) { benchmark(b, sprintfConcat) }
func BenchmarkBuilderConcat(b *testing.B) { benchmark(b, builderConcat) }
func BenchmarkBufferConcat(b *testing.B)  { benchmark(b, bufferConcat) }
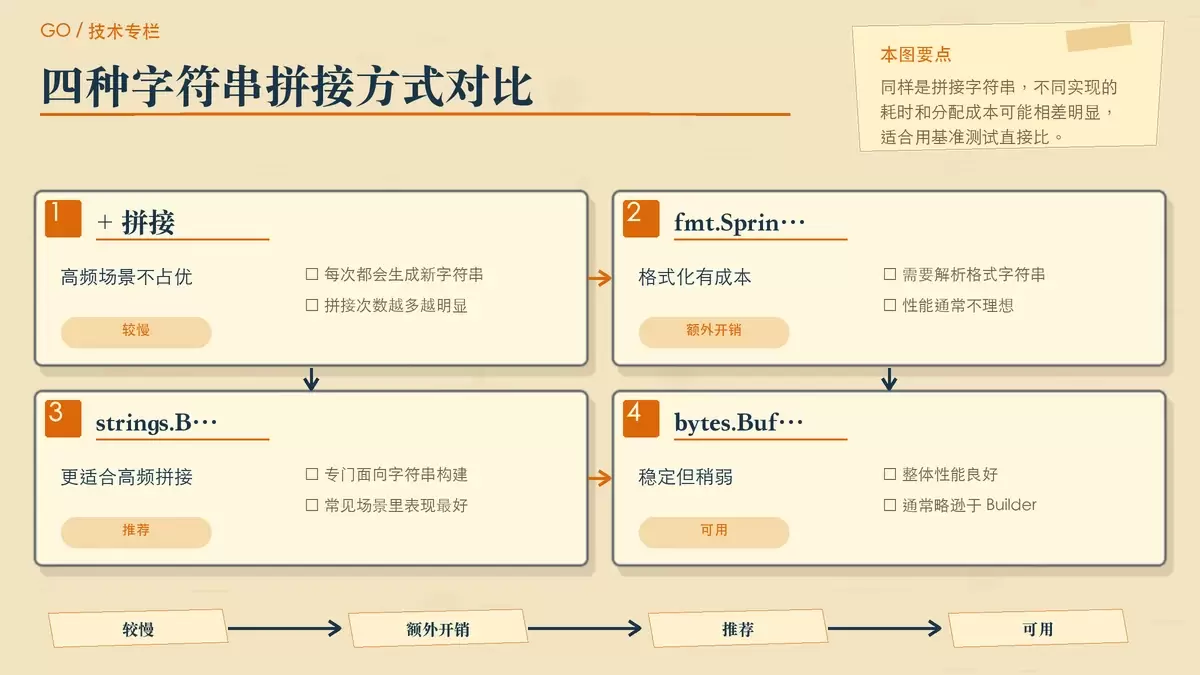
按常见结果趋势来看,这四种方式大致会呈现出下面的差异:
+拼接:通常最慢,拼接次数一多,频繁创建新字符串的代价会迅速放大fmt.Sprintf:一般也不理想,因为它还要处理格式解析strings.Builder:通常表现最好,适合专门做字符串构建bytes.Buffer:整体也不错,但字符串场景里往往会略逊于strings.Builder
这类 benchmark 的意义不只是“知道谁最快”,更重要的是知道该在什么场景下换工具。比如低频代码里,易读性可能比极致性能更重要;但在日志拼接、批量构造 SQL、模板输出等高频路径里,字符串拼接方式就值得认真比较。
避免结果失真:常见陷阱、pprof 联动与持续监控
先把测试环境尽量稳定下来
benchmark 对运行环境很敏感。为了提高可重复性,至少要注意这几件事:
- 机器状态:测试时尽量保持机器空闲,减少其他进程干扰
- 节能模式:笔记本测试时关闭节能模式,避免频率波动
- 避免虚拟机:能在物理机跑,就尽量不要放在虚拟化环境里
- 温度控制:高温导致的 CPU 降频会直接影响结果稳定性
如果环境本身一直在变,再精细的 benchmark 写法也很难得到可信结论。
几个很常见、也很容易踩的坑
1. 防止编译器把代码优化掉
如果函数结果没有被使用,编译器可能直接把相关逻辑优化掉,导致你测到的是“空操作”的时间。常见做法是把结果写入包级变量:
var result int // 包级变量防止优化

func BenchmarkSomething(b *testing.B) {
    var r int
    for i := 0; i < b.N; i++ {
        r = doSomething() // 确保结果被使用
    }
    result = r
}
2. 不要让一次性初始化污染结果
func BenchmarkSomething(b *testing.B) {
    // 耗时的初始化应该放在这里
    setup()
    b.ResetTimer()

    for i := 0; i < b.N; i++ {
        // 被测代码
    }
}
初始化通常应该放在循环外,计时从真正执行被测逻辑时开始。
3. 随机数据要固定种子
只要 benchmark 依赖随机输入,就应该先固定随机种子,否则每次输入都不同,结果也很难比较:
func BenchmarkWithRandomData(b *testing.B) {
    rand.Seed(42) // 固定随机种子保证可重复性
    data := make([]int, 1000)
    for i := range data {
        data[i] = rand.Intn(1000)
    }

    b.ResetTimer()
    for i := 0; i < b.N; i++ {
        processData(data)
    }
}
发现慢点后,用 pprof 往下挖
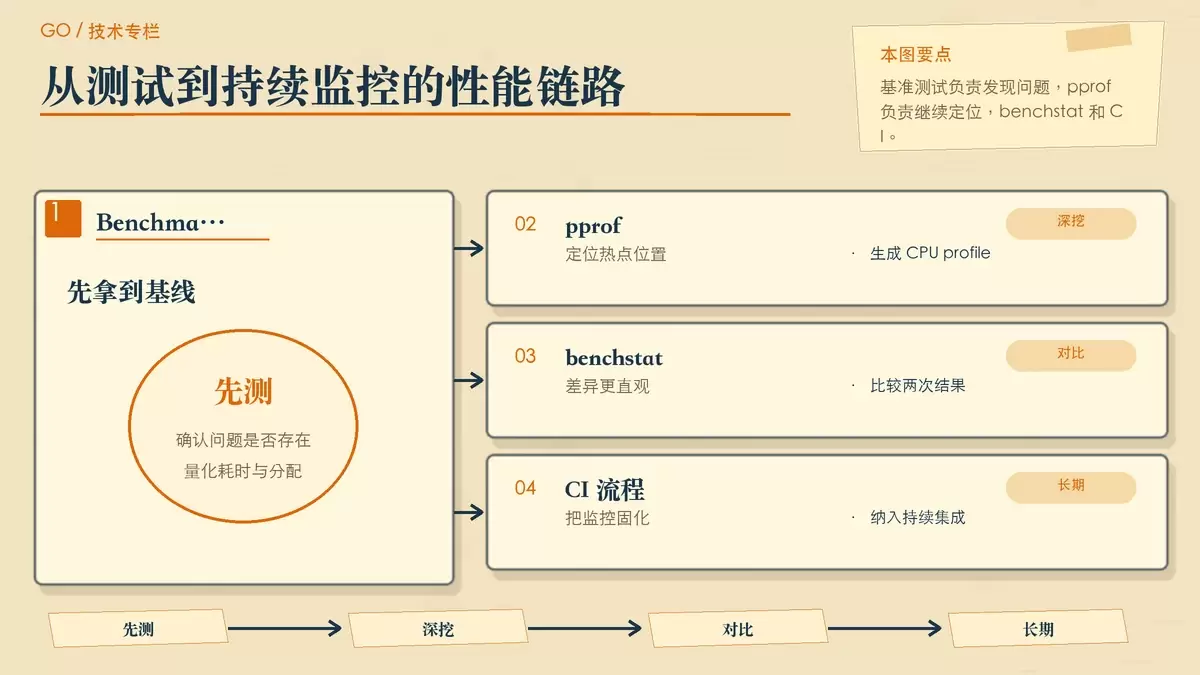
benchmark 负责告诉你“哪里可能有问题”,但它并不直接告诉你“为什么慢”。这时就可以接上 pprof 做更深层分析:
# 生成CPU profile
go test -bench=. -benchmem -cpuprofile=cpu.out

# 生成内存profile
go test -bench=. -benchmem -memprofile=mem.out

# 分析CPU profile
go tool pprof cpu.out

# 分析内存profile
go tool pprof mem.out
进入交互界面后,可以用 top、list 等命令继续查看热点函数和具体调用位置。也就是说,benchmark 更像“发现异常”,pprof 更像“定位病灶”,两者结合起来才是完整的性能分析链路。
把 benchmark 纳入持续集成,防止性能回退
很多项目在优化后一段时间又慢回去了,原因并不复杂:缺少持续检测。把 benchmark 放进 CI 后,至少能让性能变化有迹可循。
例如可以写一个简单脚本定期输出结果摘要:
#!/bin/bash
# benchmark.sh

echo "Running performance benchmarks..."

# 运行基准测试并保存结果
go test -bench=. -benchmem -count=3 > benchmark_results.txt

# 提取关键指标
echo "=== Performance Summary ==="
grep -E "Benchmark.*ns/op" benchmark_results.txt | sort -k 3n

echo "=== Memory Usage Summary ==="
grep -E "Benchmark.*B/op" benchmark_results.txt | sort -k 5n

echo "Benchmark completed. Results saved to benchmark_results.txt"
如果要比较两个版本之间的变化,可以使用 benchstat:
# 安装benchstat
go install golang.org/x/perf/cmd/benchstat@latest

# 对比两次测试结果
benchstat old.txt new.txt
benchstat 的价值在于,它比肉眼比对输出更稳,也更适合用于团队协作和版本评估。
最后该怎么用这些结果
Go 的基准测试框架并不是“优化前必跑一次”的点缀工具,而是性能决策的基础设施。真正有效的用法通常是这样的:先写最小可复现的 benchmark,确认问题确实存在;再做实现对比,观察 ns/op、B/op 和 allocs/op 是否一起改善;如果仍然不知道瓶颈在哪,就继续用 pprof 往下分析;最后把关键 benchmark 固化进持续集成,防止以后无意间回退。
当你开始用这套流程做优化时,很多原本模糊的性能讨论都会变得清晰:哪些改动真的有效,哪些只是“看起来更快”,数据会直接给出答案。









