


在阅读 Go 标准库、运行时代码或一些偏底层的项目时,常会遇到 //go: 开头的特殊注释。它们表面上像注释,实际会被编译器或工具链识别,直接影响编译、链接和运行时行为。本文不把它们当“冷知识”罗列,而是按常见用途拆开讲清楚:哪些是性能相关,哪些是构建相关,哪些虽然强大但风险很高,读完后你能更快判断一条指令是否值得在业务代码里使用。
什么是 //go: 编译指示
先看核心定义://go: 不是 Go 语法关键字,而是一类“编译指示”。这类指示会告诉编译器或工具链,某段声明、某个文件、某个符号需要按特殊方式处理。
这和 C 里的 #include、条件编译一类机制很接近,只是 Go 选择了“注释外形、工具链识别”的做法。也正因为它们不是普通语法规则的一部分,所以可用范围、行为细节以及风险,往往比一般语言特性更依赖编译器实现。
理解这一点很重要:很多 //go: 指令并不是给日常 CRUD 代码准备的,而是给运行时、汇编接口、底层优化和构建流程使用的。看到它们时,优先把它理解为“和编译器直接对话”。
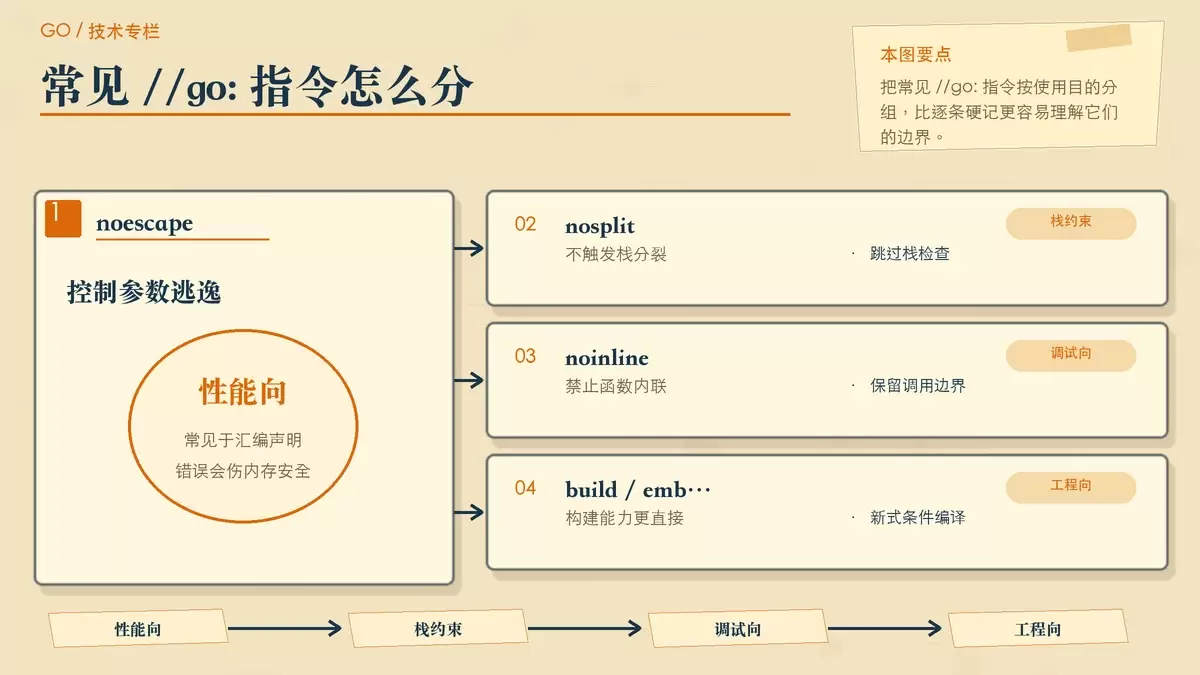
和性能、栈行为有关的常见指令
//go:noescape:告诉编译器参数不会逃逸
//go:noescape 用在“下一个没有函数体的函数声明”前,常见于由汇编或其他低级实现提供函数体的场景。它向编译器声明:这个函数不会让传入参数逃逸到堆上。
//go:noescape
func memmove(to, from unsafe.Pointer, n uintptr)
Go 的逃逸分析会决定变量分配在栈上还是堆上,进而影响 GC 压力和分配成本。这个指令的价值就在于,能避免编译器因为无法看见函数体而做出保守判断。
但问题也在这里:一旦声明与实际行为不符,后果不是“优化失效”,而可能是内存错误。因此它通常只适合非常明确、非常底层的接口,不适合拿来做经验主义优化。
//go:nosplit:跳过栈增长检查
Go 的 goroutine 初始栈很小,通常从 2KB 开始,并在运行时按需增长。正常情况下,函数调用前会做栈检查;而 //go:nosplit 的作用,就是让函数跳过这一步。
//go:nosplit
func atomicAdd(ptr *int32, delta int32) {
    // 汇编实现,无需栈操作
}
这类指令一般只会出现在对调用路径、栈占用都高度可控的底层代码里,例如运行时关键路径、原子操作或极低层封装。原因很直接:一旦函数实际需要的栈空间超出可用范围,程序就可能发生栈溢出。
所以它的使用前提不是“我想更快一点”,而是“我非常确定这里不该触发栈分裂,而且能承担后果”。
//go:noinline:阻止函数内联
内联是 Go 编译器常见的优化方式,尤其对短小函数,直接把函数体展开到调用点,可以减少调用开销。不过有些时候,你恰恰需要保留函数边界,这时就会用到 //go:noinline。
//go:noinline
func DebugLog(msg string) {
    fmt.Println("[DEBUG]", msg)
}
典型场景包括调试、性能分析、基准测试对比,或者你希望保留更稳定的调用栈信息。对于研究编译器行为的人来说,这个指令也很常见,因为它能减少优化带来的干扰。
它不是“关闭优化的通用开关”。对频繁调用的小函数,禁止内联可能让性能变差;但对某些较大函数,强行内联本身也未必合算,因为代码体积变大后,缓存命中率也可能受到影响。
和竞态检测、符号访问有关的高风险指令
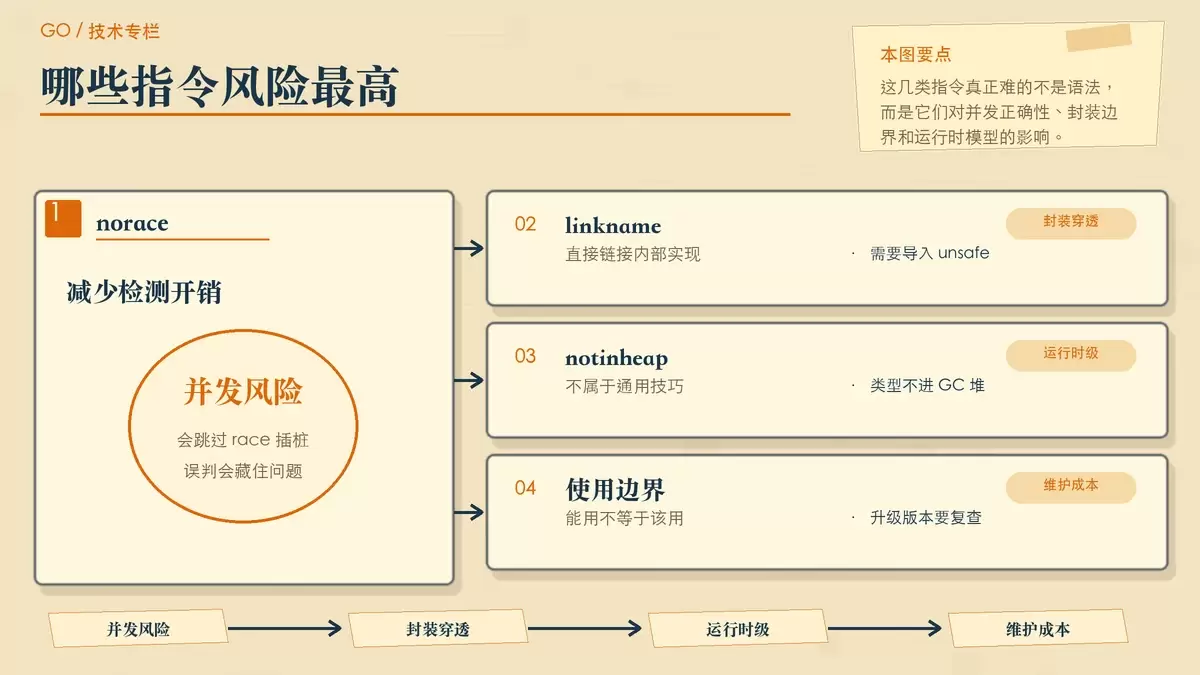
//go:norace:跳过竞态检测
//go:norace 的意思很直接:在 race 检测相关场景里,告诉工具链不要为该函数插入竞态检测逻辑。
//go:norace
func AtomicIncrement(ptr *int64) {
    atomic.AddInt64(ptr, 1)
}
它的主要价值在于减少 race 检测带来的额外开销,适合那些你已经百分之百确认不存在数据竞争、同时又希望降低检测噪声的代码路径。
风险同样明显:如果判断错了,它掩盖的不是警告,而是真实并发问题。因此这类指令一般不应出现在普通业务并发逻辑里,而应局限在非常窄、非常可验证的底层实现中。
//go:linkname:链接到未导出符号
//go:linkname 是一条能力很强、也很容易破坏边界的指令。它允许把当前包中的名字,链接到其他包里的未导出函数或变量。
import _ "unsafe"

//go:linkname timeNow time.now
func timeNow() (sec int64, nsec int32, mono int64)
它要求导入 unsafe,本质上是在绕过 Go 包级封装。某些特殊场景下这确实很有用,例如与运行时配合、兼容历史接口或做非常规底层扩展;但从工程维护角度看,这也是最需要克制的一类指令。
因为一旦目标符号在新版本中改名、改签名或语义变化,编译和运行行为都可能受到影响。换句话说,它换来的不是普通依赖,而是对内部实现细节的直接耦合。
//go:notinheap:禁止类型分配到 GC 堆
//go:notinheap 用于类型声明,表示这个类型的对象不应该从 GC 堆上分配。
//go:notinheap
type notInHeap struct{}
这类能力主要服务于 Go 运行时或极底层系统结构,目的是避开某些写屏障、调度和内存分配路径带来的成本。它不是通用性能技巧,而是运行时内部管理模型的一部分。
对绝大多数应用开发者来说,知道它的存在和含义已经足够;真正把它用进业务工程,往往意味着你已经进入需要同时理解 GC、写屏障和对象生命周期的层级。
和构建、资源管理直接相关的指令
//go:build:新的条件编译写法
从 Go 1.16+ 开始,//go:build 成为新的条件编译语法,用来替代旧的 // +build。
//go:build linux && amd64
package main
它最大的改进是表达更清晰,支持更自然的布尔逻辑组合。对于需要区分操作系统、架构或构建场景的项目来说,这条指令比旧写法更容易读懂,也更不容易写错。
如果你在维护跨平台代码库,看到不同平台拆分成多个文件时,通常就能在文件顶部发现这类条件编译指示。
//go:embed:把静态资源打进二进制
//go:embed 同样来自 Go 1.16。它解决的是另一个很实际的问题:如何把模板、图片、静态文件或配置一并打包进程序,而不是部署时再额外拷贝资源目录。
import "embed"

//go:embed templates/*.html static/images/*
var content embed.FS
对 Web 服务、CLI 工具和单文件分发程序来说,这个能力非常实用。它让部署形态更简单,也减少了“二进制在,资源丢了”的问题。
和前面那些偏底层、偏危险的指令不同,//go:embed 是普通项目里也很常见的一条,工程收益通常很直接。
什么时候该用,什么时候最好不要用
//go: 指令的共同特点是“能力强,但约束也强”。真正使用前,至少要先过四道判断:
- 先确认是否真的需要。 大多数日常开发并不需要直接干预编译器行为,只有在性能瓶颈、底层接口或构建需求明确存在时,这类指令才有意义。
- 严格遵守格式。 这类指令虽然写在注释里,但格式要求很死,
//和go之间不能有空格,位置也通常有限制。 - 理解机制再动手。 像
//go:noescape、//go:nosplit、//go:linkname这类指令,误用带来的不是“小问题”,而可能是内存错误、隐藏缺陷或维护成本飙升。 - 必须做验证。 既要看功能测试,也要看性能测试、并发测试和跨版本兼容性,尤其在依赖运行时细节时更是如此。
简单归类的话,可以这样理解:
- 性能与底层控制:
//go:noescape、//go:nosplit、//go:notinheap - 调试与分析控制:
//go:noinline、//go:norace - 构建与工程能力:
//go:build、//go:embed - 突破封装边界:
//go:linkname
如果你的目标只是写稳定的业务代码,那么知道这些指令在做什么,通常比亲自使用它们更重要;而如果你正在读标准库、运行时源码,或需要处理极端性能场景,这些知识就会直接影响你的判断质量。









