


Go 服务里的资源泄漏,很多时候不是因为少写了一个 Close,而是请求超时、上游断开、任务被取消之后,清理路径没有被当成正式流程来设计。context.AfterFunc 正是为这类场景准备的标准库能力:它能在 Context 取消时补上一段动作,但要想在生产环境里用稳,关键不在“会不会用”,而在于是否理解它的并发边界、stop 的真实含义,以及清理逻辑该如何收敛。
下面按几个最容易出错的问题展开:它到底解决什么问题、为什么 stop 不是等待按钮、清理逻辑为什么必须幂等,以及哪些业务场景最适合交给 AfterFunc。如果代码里已经多次出现相似写法,最后也可以考虑把它封装成一个可等待的清理器。
AfterFunc 到底解决什么问题
最直接的取消清理方式,是自己起一个 goroutine 监听 <-ctx.Done(),等上下文取消后再执行 cleanup()。这种写法当然能跑,但它有几个明显问题:每注册一次清理都要多一个 goroutine,正常路径结束后还要自己约定怎么停止回调,调用方也拿不到统一的停止句柄。
context.AfterFunc 把这套模式直接收进了标准库:
stop := context.AfterFunc(ctx, func() {
    cleanup()
})
defer stop()
它的语义可以概括为两点。第一,当 ctx 被取消时,回调会在一个独立的 goroutine 中执行。第二,如果注册时 ctx 已经取消,这个回调也会被立即安排执行,而不是静默跳过。
返回值 stop 用来断开 ctx 和这段回调之间的关联。它不是“取消上下文”,也不是“等待清理完成”,只是一次停止尝试。官方语义非常关键:
stop()返回true:说明回调还没运行,并且这次已经成功阻止它执行。stop()返回false:说明这次没拦住,回调可能已经开始,也可能之前已经被停止过。
也就是说,AfterFunc 解决的是“取消时触发动作”这件事本身,但它不会自动替你解决竞态、等待和幂等问题。这些仍然要由业务代码自己补齐。
为什么 stop 不是等待按钮
很多人第一次接触 AfterFunc 时,容易把 stop 理解成“撤销并等待结束”。这正是最危险的误解。stop 的返回值只代表有没有成功阻止回调启动,它不说明回调执行到了哪一步,更不会等待已经启动的清理函数跑完。
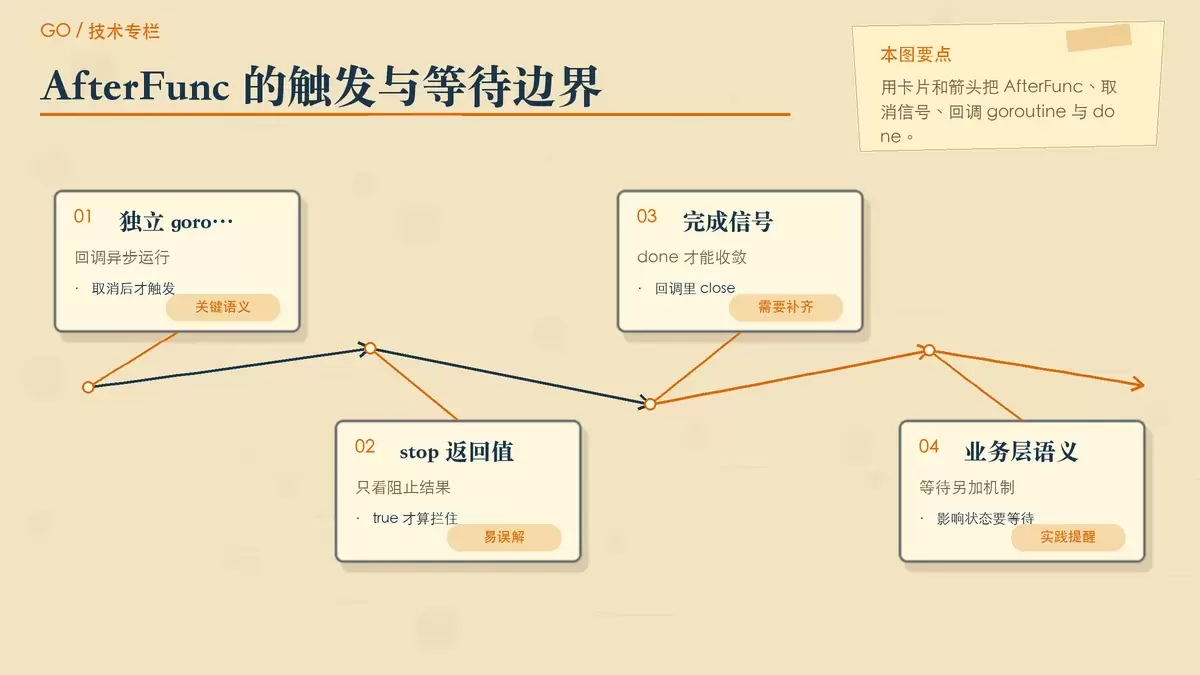
一旦清理逻辑会影响外部可见状态,就不能只依赖 stop。例如关闭连接、删除临时文件、回滚事务、释放分布式锁,这些操作都可能与正常路径同时发生。如果后续流程必须建立在“清理已经结束”的前提上,就要显式补一个完成信号。
原始写法可以这样扩展:
done := make(chan struct{})
stop := context.AfterFunc(ctx, func() {
    defer close(done)
    cleanup()
})
这里的 done 用来表达“清理路径已经收敛”。但只在回调中关闭它还不够,因为正常路径也可能先一步成功阻止回调;如果这种情况下没人关闭 done,等待方就会永久阻塞。
因此正常路径还要把 stop() 成功这一分支也补上:
if stop() {
    close(done)
}
<-done
这段代码的价值,在于把 stop 的“尝试停止”语义,补成业务里更常需要的“这条清理路径已经结束,我现在可以继续了”。如果你要做的是资源交接、状态切换、测试断言,这个完成信号通常比 stop 本身更重要。
清理逻辑为什么必须幂等
AfterFunc 很适合在取消发生时补一刀,但这不意味着清理函数可以随手写。真正的难点在于,正常路径和取消路径经常会争抢同一份资源,而你无法假设它们一定按顺序发生。
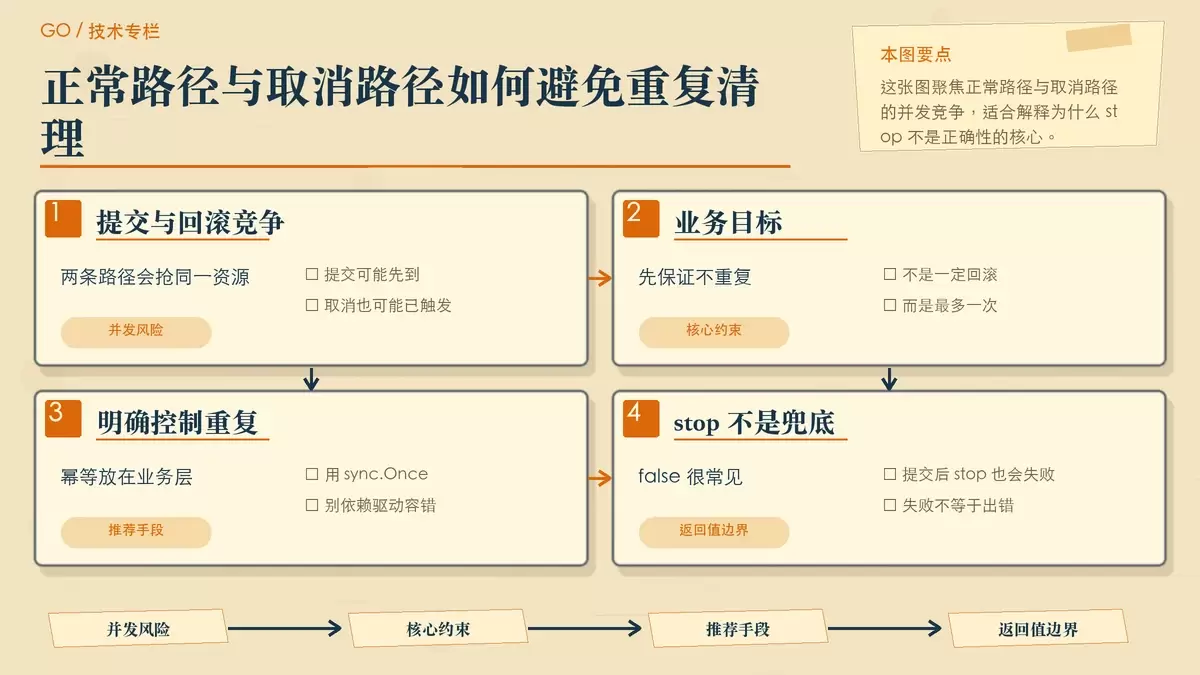
事务处理就是一个典型例子。业务成功时要提交,取消发生时要回滚。问题在于,提交和回滚可能几乎同时触发。安全目标不是“取消时一定回滚”,而是“无论走哪条路径,回滚最多执行一次”。
var once sync.Once
stop := context.AfterFunc(ctx, func() {
    once.Do(func() { _ = tx.Rollback() })
})
defer func() {
    if stop() { once.Do(func() { _ = tx.Rollback() }) }
}()
这里真正兜底的是 sync.Once,不是 stop。即便提交成功后再调用 stop(),返回值仍然可能是 false,因为取消回调可能已经开始。也就是说,不能把正确性寄托在“我应该能比取消更快一步”这种假设上。
数据库事务有时会在“提交后回滚”时返回错误,有些驱动还能容忍这类情况,但业务代码不该把安全性建立在具体实现的容错上。更稳妥的做法,是用 sync.Once、状态机、原子标记这类明确手段,把重复操作挡在业务层。
这个原则不只适用于事务。删除临时文件、关闭网络连接、释放锁、结束后台协程,只要正常路径和取消路径都可能碰它,就应该默认它会被并发触发一次以上,然后按这个前提来设计清理函数。
哪些场景适合放进 AfterFunc
并不是所有 defer 都值得改成 AfterFunc。如果资源生命周期天然跟函数返回绑定,而且不需要区分“正常结束”和“被取消”,普通 defer 仍然更直接。AfterFunc 更适合两类场景:
只在取消发生时才需要额外动作
这类情况最常见的特点是:正常路径有自己的收尾逻辑,取消路径只负责兜底,不参与主流程状态迁移。比如临时文件在正常成功后会被交给下游接管,那么取消时只需要负责删除即可;一旦接管完成,正常路径调用 stop(),就能阻止这次兜底删除继续发生。
把取消信号桥接到不支持 Context 的旧接口
有些阻塞接口本身不接受 Context,但底层对象暴露了 Close 之类的中断手段。这个时候,AfterFunc 非常适合把取消信号接过去:
stop := context.AfterFunc(ctx, func() {
    _ = conn.Close()
})
defer stop()
连接被关闭后,阻塞中的 Read 或 Write 通常会返回错误,外层再结合 ctx.Err() 判断这是不是由取消引起。这个模式的重点不是替代主流程,而是给那些“不懂 Context 的旧接口”补上一条取消出口。
从实践看,AfterFunc 尤其适合连接关闭、事务兜底回滚、临时文件删除、旧接口取消桥接这几类操作。共同特点都是:取消发生时确实需要补动作,但这个动作又不应该主导整个业务状态机。
封装一个可等待的清理器
如果项目里反复出现 AfterFunc + done 这套写法,可以考虑把它收成一个小工具,把最容易漏掉的边界集中起来。一个足够轻量的版本如下:
func onCancel(ctx context.Context, fn func()) func() {
    done := make(chan struct{})
    stop := context.AfterFunc(ctx, func() {
        defer close(done); fn()
    })
    return func() {
        if stop() { close(done) }
        <-done
    }
}
这个封装返回的就不是原始 stop,而是一个“要么成功停止,要么等待已经开始的清理结束”的函数。调用方式也更贴近日常业务代码:
wait := onCancel(ctx, cleanup)
defer wait()
这样做的好处,是把“回调是否已启动”“谁来关闭 done”“等待何时结束”这些容易写错的细节统一收进一个地方。对于测试清理、临时文件兜底、可重复关闭的网络资源,这种封装通常更顺手。
不过边界还是要看清。这个工具只解决“停止或等待完成”的问题,并不会自动让 fn 变成幂等函数。如果清理动作本身不能重复执行,仍然要在内部加上 sync.Once 或者其他状态保护。
使用 AfterFunc 时该记住什么
context.AfterFunc 的价值,在于把“取消发生后触发动作”变成了标准库的一等能力。它让清理逻辑能贴近资源创建处书写,减少散落各处的 select 监听和额外 goroutine。
但真正决定它能不能在生产环境里站住脚的,不是 API 本身,而是对并发语义的把握:回调在独立 goroutine 中执行;stop 只尝试停止,不等待完成;正常路径和取消路径可能并发命中同一资源;凡是会影响外部状态的清理,都应该尽量短小、幂等,并在必要时提供完成信号。
把这些边界处理清楚之后,AfterFunc 才不只是一个看起来方便的小函数,而会成为 Go 服务里真正实用的资源生命周期工具。









