


Go 项目一旦开始对接外部接口,鉴权、日志、超时和重试往往最先失控:一部分写在业务函数里,一部分散在工具包里,最后既难复用,也难统一排查。net/http 提供的 RoundTripper 恰好是一个合适的收口点,既不改变业务层继续使用 client.Do(req) 的方式,又能把这些横切逻辑放到标准扩展位里集中治理。本文从职责边界讲起,再到链式组合、鉴权与日志实现,最后落到最容易出错的重试细节,帮助你判断哪些能力该放进 Transport,哪些问题必须在实现时提前兜住。
RoundTripper 适合接什么,不适合接什么
RoundTripper 的接口非常小,但边界非常关键:
type RoundTripper interface {
    RoundTrip(*Request) (*Response, error)
}
它负责的是一次 HTTP 事务,也就是把请求发出去,再把响应拿回来。这里最容易混淆的一点是:RoundTrip 不负责解释业务结果。服务端即使返回 500,只要响应已经收到,通常也应该返回 Response,而不是直接把它当成 error。
同样,重定向、Cookie、认证策略这类更高层的能力,也不属于底层 RoundTripper 的默认职责。换句话说,RoundTripper 更像一层围绕“请求发送过程”的治理点,适合做请求改写、日志记录、有限重试、指标采集这类横切逻辑,但不适合顺手塞入响应解释和业务判断。
另一个必须明确的边界是并发安全。一个 RoundTripper 可能同时被多个 goroutine 调用,如果封装层里维护了 token 缓存、刷新状态或者指标计数,就要自己保证并发安全,常见做法是加锁或使用并发安全结构。这个约束看起来基础,但很多“偶发鉴权失败”或者“统计值跳变”的问题,本质上都出在这里。
怎么组合中间层,才能保住连接复用
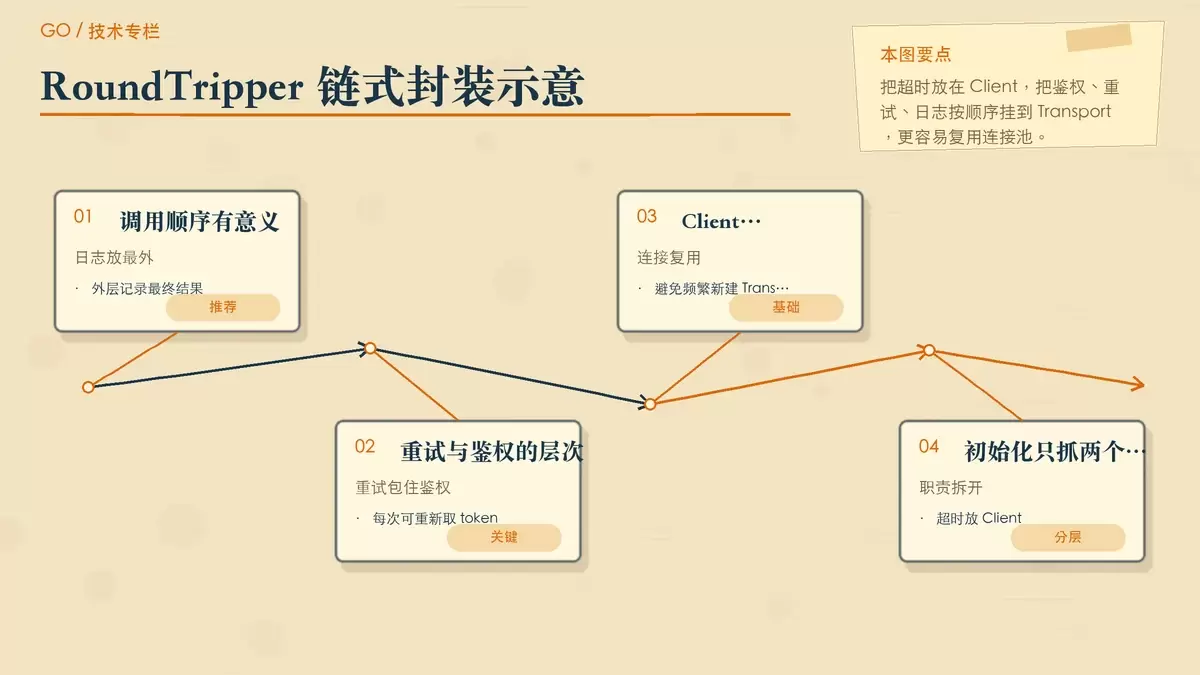
在 Go 里做 HTTP 客户端封装,一个常见误区是频繁新建 http.Client 或 Transport。这样会直接影响底层连接池复用,结果就是连接开销增加、延迟抖动变大。更稳妥的方式,是尽量复用 http.Client 和 Transport,把横切能力按中间件方式挂到 Transport 上。
每一层都可以写成接收 next 的中间件:
type TransportFunc func(*http.Request) (*http.Response, error)
func (f TransportFunc) RoundTrip(r *http.Request) (*http.Response, error) {
    return f(r)
}
type Middleware func(http.RoundTripper) http.RoundTripper
链式组装时,按从后往前包裹的方式更直观,也更符合中间件调用顺序:
func Chain(rt http.RoundTripper, ms ...Middleware) http.RoundTripper {
    for i := len(ms) - 1; i >= 0; i-- { rt = ms[i](rt) }
    return rt
}
客户端初始化时,可以只抓两个重点:超时放在 Client,横切治理放在 Transport。
client := &http.Client{
    Timeout: 3 * time.Second,
    Transport: Chain(http.DefaultTransport,
        Logging(log), Retry(2), Auth(token)),
}
这个顺序也有讲究。日志层放在最外面,更容易记录最终结果;重试层包住鉴权层,则每次重试都可以重新注入最新 token,而不是重复发送第一次已经过期的认证信息。很多时候,中间件“能跑”和“顺序合理”是两回事,实际问题往往就出在顺序上。
鉴权和日志层,重点是别破坏请求与响应
鉴权层最常见的错误,是直接修改传入的 req。问题在于,请求对象可能会被外层复用,直接改 Header 会把副作用带到调用链之外。更稳妥的做法是先克隆请求,再附加认证信息:
func Auth(token func() string) Middleware {
    return func(next http.RoundTripper) http.RoundTripper {
        return TransportFunc(func(req *http.Request) (*http.Response, error) {
            r := req.Clone(req.Context())
            r.Header.Set("Authorization", "Bearer "+token())
            return next.RoundTrip(r)
        })
    }
}这里还要注意一个细节:Request.Clone 对 Body 只是浅拷贝。鉴权层本身不读取 Body,所以问题不大;但如果你在别的层里需要重复发送请求,就不能只靠克隆解决请求体复用问题。
日志层的边界也要收得住。适合记录的是方法、路径、状态码、耗时和错误,而不是直接读取响应体。因为 Response.Body 是流,一旦被日志层消费,业务层就拿不到完整内容了。
return TransportFunc(func(req *http.Request) (*http.Response, error) {
    start := time.Now()
    resp, err := next.RoundTrip(req)
    code := 0
    if resp != nil { code = resp.StatusCode }
    log.InfoContext(req.Context(), "http client",
        "method", req.Method, "path", req.URL.Path,
        "status", code, "cost", time.Since(start), "err", err)
    return resp, err
})
示例里只记录 URL.Path,这也是一个很实用的取舍:避免把查询参数中的敏感信息直接打进日志。如果确实需要观察响应内容,更合适的做法是放在业务解析失败时做有限字节采样,而不是在通用日志层里统一读取。
重试实现里,真正容易踩坑的是这些细节
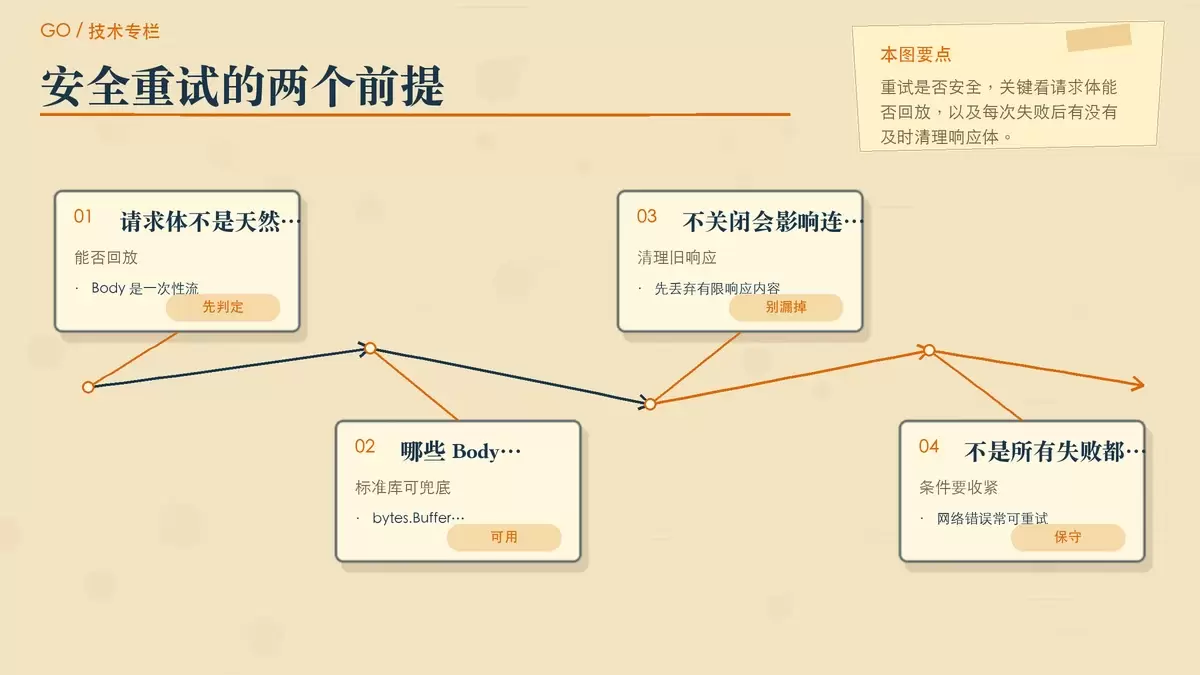
重试逻辑看起来不复杂,但最容易写出隐患。核心原因在于,请求体和响应体都不是可以随便重复使用的普通对象。
请求体能不能重发,先看 GetBody
Body 是一次性流,第一次发送后很可能就被消费掉了。要安全重试,关键不是“再 Clone 一次请求”,而是确认能不能重新生成请求体。标准库给出的关键信号就是 GetBody:
func cloneForRetry(req *http.Request) (*http.Request, error) {
    r := req.Clone(req.Context())
    if req.Body == nil || req.Body == http.NoBody { return r, nil }
    if req.GetBody == nil { return nil, fmt.Errorf("body not replayable") }
    body, err := req.GetBody()
    if err != nil { return nil, err }
    r.Body = body
    return r, nil
}
如果请求是通过 http.NewRequest 创建,且 Body 来自 *bytes.Buffer、*bytes.Reader、*strings.Reader,标准库通常会自动设置 GetBody。但如果 Body 来自文件、网络流或者压缩流,通用重试层就不该盲目重试,否则看起来只是“多发一次请求”,实际上发送出去的数据可能已经不完整了。
重试前先关掉旧响应体,才能继续复用连接
另一个经常被忽略的点,是上一次失败响应的清理。如果在下一次重试前不关闭响应体,底层连接就可能无法被复用。更稳妥的方式,是有限度地丢弃一部分响应体,再关闭 Body:
func closeBody(resp *http.Response) {
    if resp == nil || resp.Body == nil { return }
    _, _ = io.Copy(io.Discard, io.LimitReader(resp.Body, 512<<10))
    _ = resp.Body.Close()
}
这里用 io.LimitReader 控制读取上限,也是在避免为了“清连接”而无限制读入一个很大的失败响应。这个细节对高并发客户端尤其重要,否则问题不会立即暴露,但连接利用率和尾延迟会慢慢变差。
重试条件要保守,别把所有失败都当临时抖动
哪些情况值得重试,必须收紧。网络错误、429、5xx,通常可以归为临时失败;但像普通业务错误、明确的参数错误,就不该交给通用重试层处理。
func retryable(resp *http.Response, err error) bool {
    if err != nil { return true }
    if resp == nil { return false }
    return resp.StatusCode == 429 || resp.StatusCode >= 500
}
POST 能不能重试,也不能一概而论,关键要看接口是否具备幂等键,或者服务端是否有业务去重机制。没有这层保障时,通用重试很容易把一次临时失败放大成重复写入。
核心循环可以短,但生产约束不能省
一个可读性较好的重试循环可以很短:
for i := 0; i <= max; i++ {
    r, e := cloneForRetry(req)
    if e != nil { return nil, e }
    resp, err = next.RoundTrip(r)
    if !retryable(resp, err) || i == max { return resp, err }
    closeBody(resp)
    time.Sleep(time.Duration(i+1) * 100 * time.Millisecond)
}
但真正上线时,通常还要补上几项约束:上下文取消判断、抖动退避、方法白名单、最大总耗时,以及必要的指标统计。尤其当 req.Context() 已经取消时,重试层应该尽快退出,而不是继续等待下一轮退避时间。
落地时记住这几条判断规则
RoundTripper 的价值,不在于“把所有客户端逻辑都塞进去”,而在于为 HTTP 调用提供一个标准、可组合、可复用的治理入口。鉴权层负责改 Header,日志层只观察元数据,重试层只处理可回放请求和临时性失败,这样职责才不会越界。
真正需要守住的实现规则也很明确:不要把状态码错误误判成网络错误,不要在日志层消费响应体,不要重试不可回放的 Body,也不要忘记在重试前关闭失败响应的 Body。这些边界处理好之后,业务代码依然可以保持简单的 client.Do(req),而客户端治理能力却能集中演进,不再散落在各个调用点上。









